


 Поделиться
Введение
Классические архитектуры построения корпоративных сетей на коммутаторах предлагают решения с изоляцией сервисов на L2-уровне с помощью функциональности VLAN, использование единого адресного пространства IP-сети и изоляцию L3-сервисов с помощью VRF-Lite, требующую запуска отдельных процессов и трудоемкой настройки на множестве устройств.
Стек технологий MPLS L3 VPN на коммутаторах Eltex позволяет частично заимствовать практики построения операторских сетей в корпоративной среде и строить L3-сети с масштабируемой, сегментированной и отказоустойчивой сетевой архитектурой. Это достижимо за счет концепции Overlay-сети, состоящей из изолированных L3-сервисов различных топологий, развёрнутой поверх простой и надежной Underlay-сети.
Примечания и предупреждения

Подсказки содержат небольшие пояснения, помогающие быстрее освоить работу с оборудованием, или дополнительную информацию.

Примечания содержат важную информацию о настройке оборудования.

Предупреждения информируют пользователя о ситуациях, которые могут нанести вред, привести к некорректной работе системы или потере данных.
Глоссарий
5-Tuple (пятикортеж) — набор из пяти полей пакета, используемый для идентификации потока данных (flow) при балансировке.
Плоскость передачи данных (Data Plane) — логическая группа программно-аппаратных функций устройства, отвечает за передачу IP- и MPLS-пакетов на основании результатов работы протоколов и механизмов плоскости управления.
Плоскость управления (Control Plane) — логическая группа программно-аппаратных функций устройства, генерирует и поддерживает информацию об IP-маршрутах и MPLS-метках, топологическую информацию, информацию о лучших путях.
Поляризация трафика (Traffic polarization) — эффект, при котором последовательные устройства с одинаковыми алгоритмами хеширования направляют один и тот же поток трафика на один и тот же путь в ECMP-группе.
Сервисная плоскость (Service plane) — стек overlay-технологий на устройстве, отвечающий за идентификацию конкретного VPN-сервиса на PE, принимающих решение, в какой VRF обрабатывать трафик и какую сервисную MPLS-метку использовать при передаче.
Сервисная MPLS-метка — метка, которая идентифицирует конечный сервис VPN на PE, не меняется на протяжении всего пути через Overlay-сеть и используется только на последнем PE-узле.
Транспортная плоскость (Transport plane) — стек underlay-технологий на устройстве, отвечающий за доставку пакетов от одного PE к другому через P-маршрутизаторы, обеспечивает быструю и надежную пересылку трафика на основе транспортных меток (или IP-адресов) без анализа содержимого пользовательских данных.
Транспортная MPLS-метка — метка, которая указывает путь (nexthop) через транспортную плоскость сети, используется для пересылки пакета между маршрутизаторами (P- и PE-узлами) и меняется на каждом транзитном участке.
Active-active — режим работы multi-homing/dual-homing, при котором все каналы находятся в активном состоянии и одновременно обрабатывают трафик.
Active-standby — режим работы multi-homing/dual-homing, при котором только один канал является активным и обрабатывает весь трафик, остальные каналы находятся в резервном (ожидающем) состоянии и не несут нагрузки.
AF VPNv4 Unicast — семейство адресов протокола MP-BGP, используемое для обмена маршрутной информацией и функционирования L3 VPN.
AFI/SAFI (Address Family Identifier/Subsequent Address Family Identifier) — идентификаторы семейств адресов в BGP, указывающие, к каким типу и подтипу адресов относится анонсируемый маршрут.
AS (Autonomous System) — автономная система, совокупность сетей и маршрутизаторов, находящихся под единым административным управлением и использующих общую политику маршрутизации.
AS_PATH — атрибут BGP, упорядоченный список номеров AS, через которые прошёл маршрут от источника до текущего маршрутизатора.
BFD (Bidirectional Forwarding Detection) — протокол для быстрого обнаружения односторонней непроходимости на каналах, обеспечивающий субсекундное уведомление протоколов маршрутизации об отказе канала.
BGP (Border Gateway Protocol) — протокол динамического обмена информацией о достижимости сетей между автономными системами.
BGP Communities — атрибут BGP, транзитный тег (метка) для использования в групповых политиках маршрутизации.
BGP Extended Communities — атрибут BGP, расширенная версия Communities 8-байтового (64-битного) формата.
BGP Route Reflector (BGP RR) — роль BGP-маршрутизатора при взаимодействии с другими BGP-маршрутизаторами в пределах одной автономной системы для обмена маршрутной информацией путем отражения BGP-маршрутов.
BGP-Update — сообщение для передачи информации об изменении маршрутной информации между BGP-соседями.
CE (Customer Edge) — устройство-клиент (маршрутизатор, коммутатор, хост), которое непосредственно подключается к PE в рамках VPN и не относится к MPLS-домену.
Downstream-LSR — нижестоящий по потоку данных LSR, находится ближе к получателю (destination) трафика.
Dual-homing — разновидность схемы multi-homing подключения CE к PE, при которой CE-устройство имеет два независимых физических или логических соединения с разными PE.
eBGP (External BGP) — режим взаимодействия маршрутизаторов по протоколу BGP между разными AS.
ECMP (Equal-Cost Multi-Path) — метод маршрутизации и технология балансировки нагрузки, позволяющая передавать пакеты одному получателю по нескольким равноценным альтернативным путям.
ECMP-группа (ECMP-group) — набор из двух или более nexthop для одной или более сетей назначения, которые имеют одинаковую стоимость с точки зрения протокола маршрутизации.
Egress-LSR — выходной (последний) LSR в LSP-туннеле на стороне получателя трафика.
Egress-PE — последний PE-маршрутизатор на пути VPN-трафика к CE-назначения, отвечает за декапсуляцию MPLS и передачу IP-трафика к CE.
FEC (Forwarding Equivalence Class) — класс множества пакетов, имеющих одинаковый путь относительно текущего узла MPLS-домена.
FIB (Forwarding Information Base) — таблица передачи, аппаратная таблица, программируемая на основе информации о лучших маршрутах из RIB, используется для передачи IP-пакетов в плоскости передачи данных.
GRT (Global Routing Table) — базовый экземпляр таблицы маршрутизации устройства.
Hash-функция (хэш-функция) — детерминированная математическая функция, служащая для преобразования входных числовых данных любой длины в числовую строку фиксированной длины.
iBGP (Internal BGP) — режим взаимодействия маршрутизаторов по протоколу BGP в пределах одной AS, требует полносвязной топологии соединений или маршрутизатора с ролью route reflector.
IGP (Interior Gateway Protocol) — протокол внутреннего шлюза (IS-IS, OSPF), используется для передачи информации о маршрутах в пределах автономной системы.
Ingress-LSR — входной (первый) LSR в LSP-туннеле на стороне источника трафика.
Ingress-PE — первый PE-маршрутизатор на пути исходящего трафика от CE-источника, отвечает за инкапсуляцию VPN-трафика в MPLS.
IS-IS (Intermediate System to Intermediate System) — двухуровневый иерархический IGP-протокол на основе состояния каналов (link-state), использующий алгоритм Дейкстры для расчета кратчайших путей, функционирует поверх канального уровня.
L3 VPN (Layer 3 Virtual Private Network) — технология виртуальной частной сети, которая работает на сетевом уровне модели OSI, обеспечивает эффективную передачу данных протокола IP изолированных друг от друга сетей и приложений.
Label Stack — совокупность MPLS-заголовков пакета, в которой решение о выполняемой над пакетом операции принимается на основе верхней метки в стеке по алгоритму LIFO.
LDP (Label Distribution Protocol) — протокол распределения MPLS-меток для FEC и распространения информации о метках между маршрутизаторами MPLS-домена.
LER (Label Edge Router) — пограничный маршрутизатор MPLS-домена, выполняющий роль ingress/egress LSR.
LFIB (Label Forwarding Information Base) — таблица MPLS-коммутации, аппаратная таблица передачи по меткам, которая формируется на основе информации из LIB и используется в плоскости передачи данных.
LIB (Label Information Base) — программная таблица информации о MPLS-метках и FEC, формируется протоколом LDP и используется в плоскости управления.
LSP (Label Switched Path) — однонаправленный канал (MPLS-туннель) от Ingress LSR до Egress LSR, по которому будет направлен пакет через MPLS-домен.
LSR (Label Switch Router) — маршрутизатор в MPLS-домене, выполняющий операции с MPLS-метками: инкапсуляции/декапсуляции/замены (push/swap/pop), в зависимости от роли узла: ingress/transit/penultimate/egress.
MP_REACH_NLRI (Multiprotocol Reachable NLRI) — атрибут MP-BGP для анонсирования достижимых маршрутов для мультипротокольных семейств адресов (отличных от IPv4 Unicast).
MP_UNREACH_NLRI (Multiprotocol Unreachable NLRI) — атрибут MP-BGP для отзыва ранее анонсированных мультипротокольных маршрутов.
MP-BGP (MultiProtocol Border Gateway Protocol) — расширение протокола BGP, позволяющее передавать маршрутную информацию для нескольких сетевых протоколов и семейств адресов и управлять данными о маршрутах для виртуальных частных сетей (VPN), не изменяя существующий механизм пересылки пакетов и маршрутизации.
MPLS (Multiprotocol Label Switching) — технология коммутации и пересылки пакетов данных на основании меток, без необходимости анализа IP-заголовка и поиска пути по таблице IP-маршрутизации на каждом транзитном узле.
MPLS Label — MPLS-метка фиксированной длины, имеющая локальное значение на каждом узле и присваиваемая потокам трафика, имеющим эквивалентные пути передачи к узлам назначения в MPLS-домене.
MPLS-домен — совокупность узлов MPLS, между которыми существуют непрерывные LSP.
Multi-homing — схема подключения CE к PE, при которой CE-устройство имеет несколько независимых физических или логических соединений с разными PE.
NLRI (Network Layer Reachability Information) — блок с информацией о достижимости сетей в BGP-Update-сообщении.
OSPF (Open Shortest Path First) — IGP-протокол с иерархией областей на основе состояния каналов (link-state), использующий алгоритм Дейкстры для расчета кратчайших путей, функционирует поверх сетевого уровня.
Overlay-сеть — логическая сеть, построенная поверх Underlay-сети, служит для создания и управления изолированными туннелями между устройствами, скрывая детали физической топологии и позволяя гибко переносить трафик разных сервисов независимо от расположения узлов.
P-маршрутизатор (provider) — маршрутизатор в MPLS-домене, который не является точкой терминации VPN-сервисов, выполняет транзитные функции в транспортной плоскости.
PE-маршрутизатор (provider edge) — пограничный маршрутизатор MPLS-домена, являющийся точкой терминации сервисов виртуальных частных сетей.
Penultimate-LSR — предпоследний LSR на пути следования пакета к его конечному получателю, находится непосредственно перед последним (Egress-LSR) маршрутизатором в LSP.
PHP (Penultimate Hop Popping) — процесс удаления MPLS-метки на предпоследнем относительно Egress-LER LSR.
RD (Route Distinguisher) — идентификатор-дискриминатор маршрутной информации, обеспечивающий уникальность IP-префиксов VPN-маршрутов.
RIB (Routing Information Base) — программная таблица информации о всех известных устройству IP-маршрутах, формируемая протоколами IP-маршрутизации, используется для выбора лучших маршрутов в плоскости управления.
RT (Route Target) — атрибут BGP Extended Communities, идентификатор, используемый для описания правил импорта/экспорта VPN-маршрутов.
Salt (соль) — случайное число, которое добавляется к кортежу перед вычислением хэша, используется для рандомизации выбора пути, чтобы избежать направления одного и того же потока трафика на один и тот же путь в ECMP-группе.
Seed (зерно) — начальное число (инициализатор) для хэш-функции: при одном и том же значении Seed хэш-функция всегда будет выдавать один и тот же результат для одинаковых входных данных.
Single-homing — схема подключения CE к PE, при которой CE-устройство имеет только одно физическое или логическое соединение с одним PE.
Transit-LSR — промежуточный MPLS-маршрутизатор, расположенный внутри LSP между Ingress-LSR и Egress-LSR.
Underlay-сеть — базовая IP/MPLS-сеть, обеспечивающая возможность соединения между всеми устройствами MPLS-домена.
Upstream-LSR — вышестоящий по потоку данных LSR, находится ближе к источнику (source) трафика.
VPN-сайт (VPN-Site) — точка терминации VPN-сервиса, группа CE-устройств, подключённых к PE-маршрутизаторам через VRF в рамках одного VPN в пределах одной площадки.
VPN-сервис (Virtual Private Network) — логическая сеть для объединения территориально распределённых офисов, филиалов или удалённых пользователей в единое изолированное частное пространство.
VRF (Virtual Routing and Forwarding) — технология, которая позволяет нескольким экземплярам таблицы маршрутизации сосуществовать в одном маршрутизаторе одновременно.
VRF-Lite — вариант локального использования технологии VRF для изоляции таблиц и процесса маршрутизации в пределах одного устройства без задействования MP-BGP.
Постановка задачи
Цель и целевая аудитория
Цель данного руководства — предоставить читателю подробную информацию о реализации стека технологий MPLS в ПО коммутаторов Eltex, а также рекомендации и валидированные примеры конфигурации, необходимые для применения MPLS в корпоративной сети на коммутаторах Eltex.
Целевой аудиторией являются сетевые инженеры, системные интеграторы, партнеры и заказчики, использующие или планирующие использовать оборудование производства Eltex. Руководство будет полезно для решения задач построения сети связи или планирования модернизации уже существующих сетей.
Преимущества решения
Основные преимущества стека технологий MPLS L3 VPN:
- Масштабируемость и упрощение архитектуры сети:
- Использование iBGP и функциональности Route-Reflector позволяет надежно, централизованно и гибко управлять обменом маршрутной информацией между коммутаторами всего MPLS-домена;
- Вся информация о VPNv4-маршрутах хранится только на PE- и RR-коммутаторах MPLS-домена;
- Транзитные P-коммутаторы имеют простую типовую конфигурацию и выполняют сквозную коммутацию по меткам, не занимаясь обработкой VPNv4-маршрутов.
- Возможность создавать изолированные и безопасные сетевые сегменты для разных отделов, подразделений и офисов:
- Изоляция на уровне L3 за счет использования технологии VRF;
- Гибкость управления маршрутами с помощью MP-BGP и механизмов Route Distinguisher (RD) и Route Target (RT);
- Использование пересекающихся адресных пространств в разных VRF благодаря MP-BGP и RD в VPNv4-маршрутах.
- Отказоустойчивость архитектуры:
- Использование технологии ECMP для передачи трафика и его балансировки по альтернативным путям позволяет эффективно использовать полосу пропускания;
- Использование технологии BFD позволяет оперативно обнаруживать каналы с односторонней непроходимостью и уводить с них трафик на альтернативные пути, исключая длительные простои сервиса при отказах.
Перечисленные преимущества подобной сетевой архитектуры позволяют реализовать следующие сценарии:
- Быстрое развертывание типовых L3-сервисов и ввод в эксплуатацию новых сегментов сети;
- Простое объединение сетей с пересекающимися адресными пространствами и различными топологиями;
- Соединение удаленных филиалов через единую MPLS-сеть и обеспечение георезервирования ключевых узлов;
- Использование оборудования различных вендоров за счет широкого распространения и совместимости используемых протоколов и решений.
Таким образом, использование MPLS L3 VPN в архитектуре будет целесообразно в следующих случаях:
- Построение сетей с высокими требованиями к отказоустойчивости, георезервированию и быстрому развертыванию типовых L3-сервисов;
- Построение распределенных кампусных сетей с большим количеством удаленных сайтов;
- Объединение разнородных IP-сетей с пересекающимися адресными пространствами и различными топологиями, с последующей миграцией этих сетей в единое адресное пространство с централизованным управлением.
Ограничения в использовании стека технологий MPLS L3 VPN на коммутаторах MES
Несмотря на описанные преимущества, использование стека технологий MPLS L3 VPN в архитектуре построения сетей на коммутаторах имеет и некоторые ограничения:
- Усложнение протоколов в плоскости управления:
- MPLS L3 VPN требует знаний MPLS, LDP, MP-BGP, что повышает требования к компетенции инженеров эксплуатации;
- Ошибки в импорте/экспорте RT могут привести к утечке VPN-маршрутов между VRF.
- Необходимость миграции с L2-сетей:
- Часто требует полного пересмотра архитектуры существующих коммутируемых L2-сетей и проработки перехода на L3;
- Потенциальные проблемы совместимости с системами и сервисами, требующими прозрачности на L2-уровне.
- Рост требований к соединениям между устройствами:
- Требование по пропуску специфического MPLS-трафика в случае использования арендованных каналов (уровень L1-L2, jumbo-frame, пропуск multicast-трафика для работы IGP/LDP);
- Добавление MPLS-заголовка увеличивает размер кадра, что требует настройки MTU и поддержки Jumbo Frames на всем протяжении сети;
- Отсутствие возможности фрагментации MPLS-пакетов на транзитных участках сети.
- Требования к производительности устройств:
- Для реализации функций требуются производительные L3-коммутаторы уровня ядра и ЦОД;
- Реализация функций MPLS-туннелирования значительно расходует аппаратные ресурсы коммутатора — TCAM, ARP.
Технология MPLS и ее реализация в ПО коммутаторов MES
MPLS — технология коммутации и пересылки пакетов данных без необходимости анализа IP-заголовка и поиска пути по таблице IP-маршрутизации на каждом транзитном узле. Анализ IP-заголовка выполняется один раз — на входе в MPLS-домен, после чего пакету добавляется MPLS-заголовок и присваивается MPLS-метка. Дальнейшая передача данных осуществляется на основании MPLS-заголовков. Это возможно за счет присвоения меток фиксированной длины, имеющих локальное значение на каждом узле, потокам трафика, имеющим эквивалентные пути передачи к узлам назначения в MPLS-сети. Инкапсуляция MPLS-заголовка производится между заголовками канального и сетевого уровней.
Базовая архитектура MPLS-домена
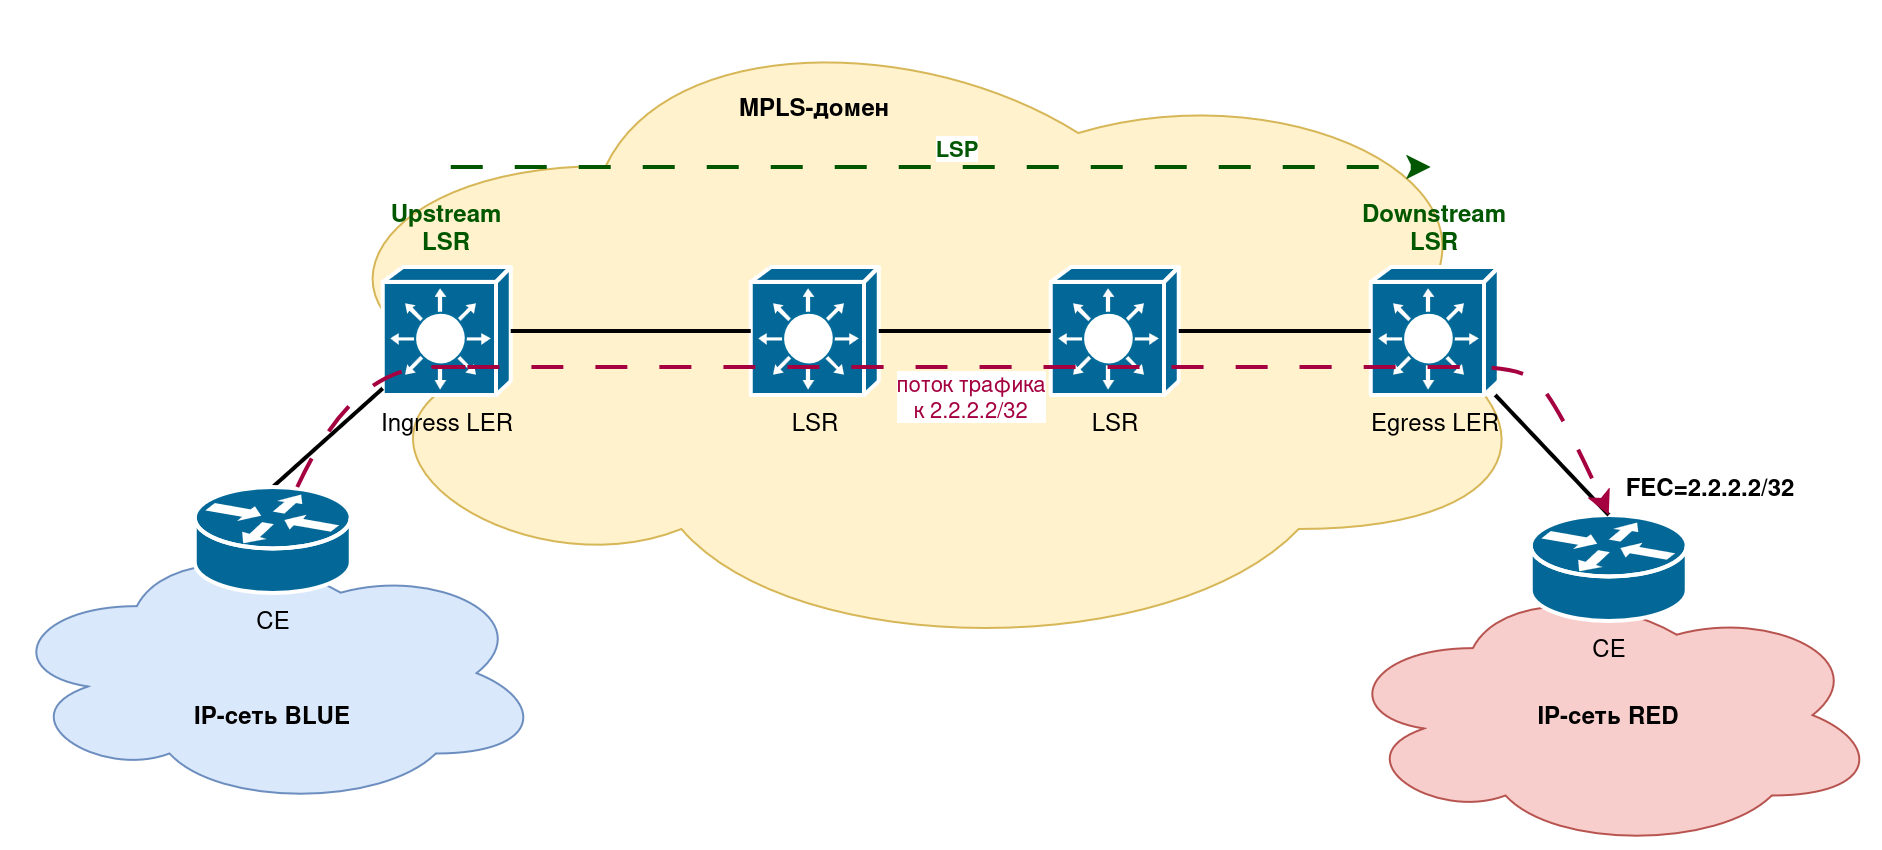
Пример MPLS-домена и ролей устройств:
В сети с использованием стека технологий MPLS передача IP-пакетов основана на коммутации по меткам:
- Коммутаторы, выполняющие пересылку IP-пакетов на основании MPLS-меток, называются LSR;
- Пограничные LSR, осуществляющие подключение к другим IP-сетям вне MPLS-домена, называются LER;
- Когда IP‑пакеты попадают в MPLS-домен, Ingress-LER анализирует пакеты, а затем добавляет к ним соответствующие метки;
- Все LSR в MPLS-домене коммутируют пакеты на основе меток;
- В процессе пересылки каждый LSR выполняет операции добавления, замены или удаления метки, в зависимости от своей роли;
- Когда IP‑пакеты покидают MPLS-домен, Egress-LER удаляет метки;
- Путь, по которому IP‑пакеты передаются между LSR, называется LSP;
- Совокупность LSR одной автономной системы, между которыми существуют непрерывные LSP, представляет собой MPLS-домен.
LSP — это однонаправленный путь в том же направлении, в котором проходят IP-пакеты одного потока. LSP может иметь только один входящий (Ingress-LER) и один исходящий узел (Egress-LER) в MPLS-домене, транзитных узлов (Transit-LSR) может быть несколько или не быть вовсе.
В LSP пакеты отправляются от Ingress-LER к Egress-LER. В прямом направлении передачи Ingress-LER является вышестоящим узлом (Upstream-LSR) по отношению к последующим LSR, а последующие LSR — нижестоящими узлами (Downstream-LSR) по отношению к Ingress-LER. Аналогично, все LSR являются Upstream-LSR по отношению к Egress-LER, а Egress-LER является Downstream-LSR по отношению к остальным LSR.
FEC и MPLS-метки
Класс эквивалентности пересылки (FEC) — класс множества пакетов, имеющих одинаковый признак для пересылки относительно текущего узла MPLS-домена. В текущей реализации идентификатором класса является адресный префикс назначения (IPdest-адрес), все потоки, принадлежащие одному классу (одному FEC), используют один LSP. Пакеты одного FEC пересылаются одинаково в сети MPLS.
В текущей версии ПО коммутаторы Eltex MES определяют в качестве FEC только IPv4-подсети назначения с длиной префикса 32 (IPdest-адреса loopback-интерфейсов удаленных LSR).
MPLS-метка (MPLS-Label) — короткий идентификатор фиксированной длины (20 бит), значимый только локально. Метка определяет FEC, к которому принадлежит пакет. В некоторых случаях, например при балансировке нагрузки, один FEC может быть сопоставлен с несколькими входящими метками. Однако каждая метка на устройстве представляет только один FEC. MPLS-метка передается вместе с IP-пакетом в составе 4‑байтового MPLS-заголовка. MPLS-заголовок располагается между заголовками канального и сетевого уровней.
Формат MPLS-заголовка:
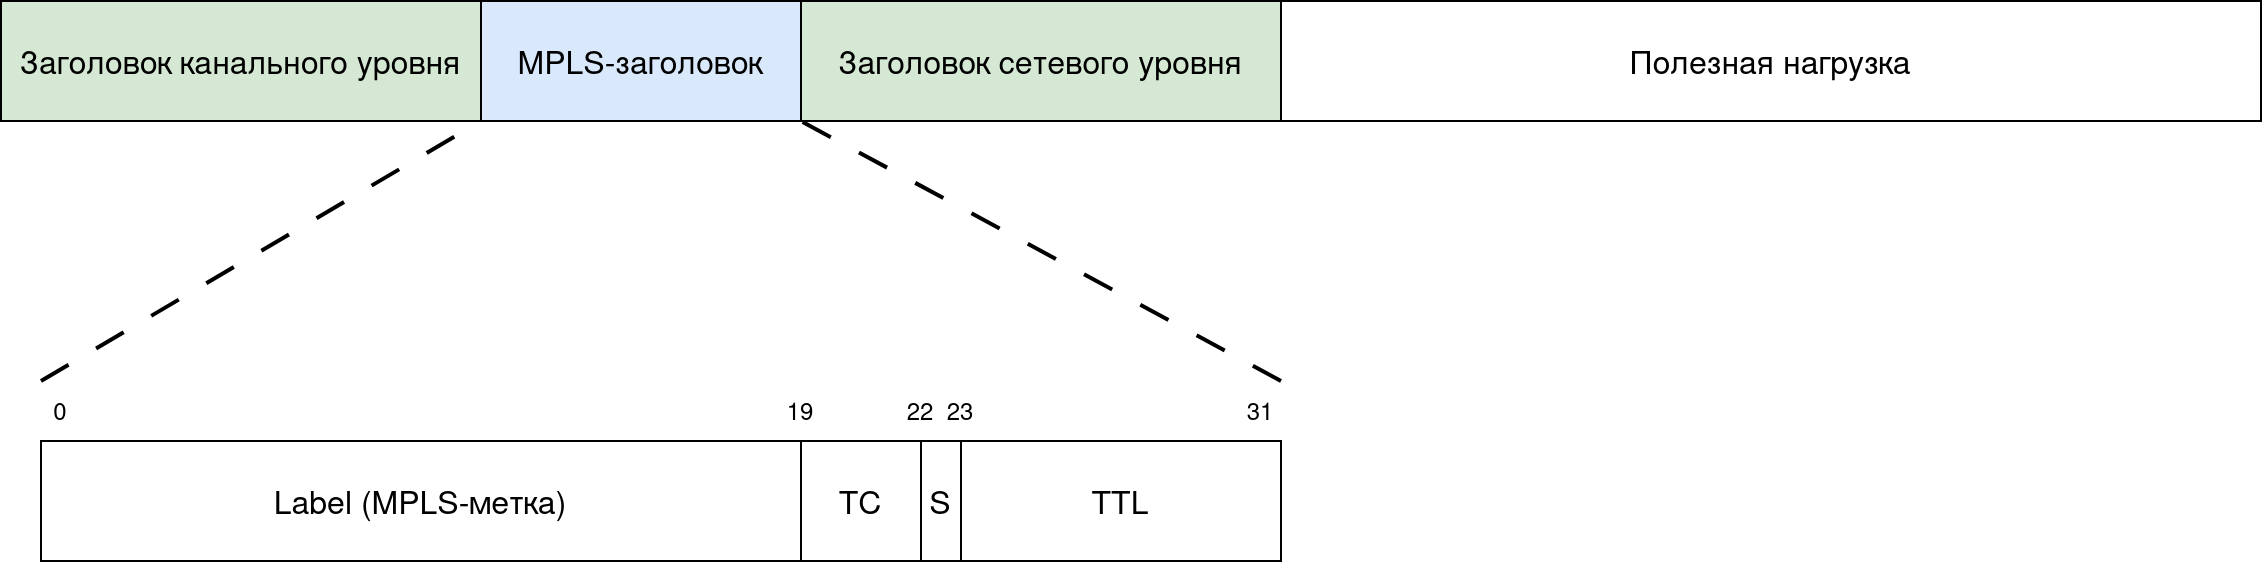
- Label — 20‑битное значение MPLS-метки — от 0 до 1 048 575;
- TC — 3‑битное поле, используемое для указания класса трафика и применения политик качества обслуживания при возникновении перегрузки;
- S — 1‑битное значение, указывающее на нижнюю часть стека меток. MPLS поддерживает вложение нескольких меток. Если поле S равно 1, метка находится в нижней части стека;
- TTL — время жизни (8 бит), роль и функция аналогичны полю TTL в IP‑пакетах.
Стек меток (Label Stack) — это упорядоченное расположение MPLS-заголовков со своими MPLS-метками:
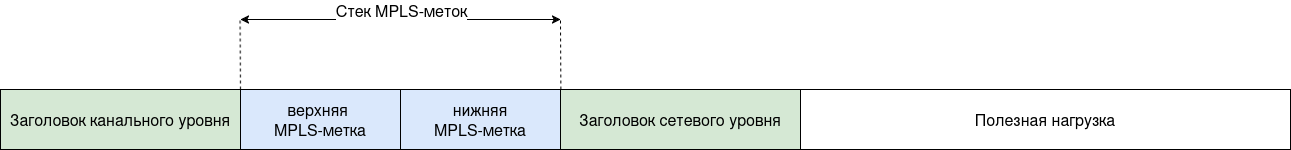
MPLS-метки в стеке обрабатываются сверху стека по принципу LIFO (Last‑In, First‑Out).
Пространство всех значений MPLS-меток можно разделить на два диапазона:
- 0–15: специальные служебные метки:
- 16–1048575: метки для динамического выделения протоколами LDP и MP-BGP.
Таблица значений MPLS-меток:
| Значение метки | Название | Назначение |
|---|---|---|
| 0 | IPv4 Explicit NULL | Показывает, что метку нужно удалить, дальнейшая пересылка будет выполняться по IPv4. |
| 1 | Router Alert | Пакет требует обработки локальным ПО, аналогично опции Router Alert в IP. |
| 2 | IPv6 Explicit NULL | Показывает, что метку нужно удалить, дальнейшая пересылка будет выполняться по IPv6. |
| 3 | Implicit NULL | Указывает предпоследнему LSR удалить метку перед отправкой трафика на Egress-LER. |
| 4–13 | Reserved | Зарезервировано. |
| 14 | OAM Router Alert | Для пакетов OAM (мониторинг LSP). |
| 15 | Reserved | Зарезервировано. |
| 16–1048575 | Dynamic assignment | Диапазон меток для динамического выделения протоколами LDP и MP-BGP. |
В текущей версии ПО отсутствует поддержка статического указания используемого диапазона MPLS-меток.
LDP и MP-BGP выделяют метки с начала диапазона и итеративно, на этапе экспорта и обработки маршрутов из протоколов маршрутизации.
Построение LSP с помощью LDP
Для построения LSP и осуществления пересылки пакетов LSR должны определить FEC и назначить им MPLS-метки. Построение LSP может выполняться административно (статически) или с помощью динамических протоколов распределения меток.
Коммутаторы Eltex для определения FEC, распределения MPLS-меток и построения динамических LSP используют протокол LDP.
LDP — это протокол с установлением соединений, использующий UDP для рассылки Hello и TCP для обмена сообщениями Session, Advertisement и Notification, что позволяет LSR MPLS-домена быстро обнаруживать соседей и надежно обмениваться информацией о метках для построения LSP по алгоритму hop-by-hop, в соответствии с информацией от протоколов маршрутизации.
В текущей версии ПО на коммутаторах Eltex реализована работа протокола LDP в следующих режимах:
- Basic discovery — механизм обнаружения соседей в LDP, при котором LSR периодически отправляют многоадресные Link Hello-сообщения, если LSR получает LDP Link Hello-сообщение на интерфейсе, устройство подключается к LDP-пиру через этот интерфейс;
- Downstream Unsolicited Label Advertisement Mode — режим анонсирования MPLS-меток, при котором Downstream-LSR активно распространяет информацию о метках для FEC через Label Mapping-сообщение без получения Label Request-сообщений от upstream-LSR;
- Independent Label Distribution Control Mode — режим распространения меток, при котором LSR уведомляет upstream-LSR о метке и связанном FEC, не дожидаясь метки от downstream-LSR;
- Liberal Label Retention Mode — режим удержания меток, при котором LSR сохраняет метку, полученную от LDP-соседа, независимо от того, является ли этот LSR nexthop-ом для известных FEC, это позволяет быстро восстановить LSP при перестроениях топологии и в Underlay-сети.
Базовая схема построения LSP:
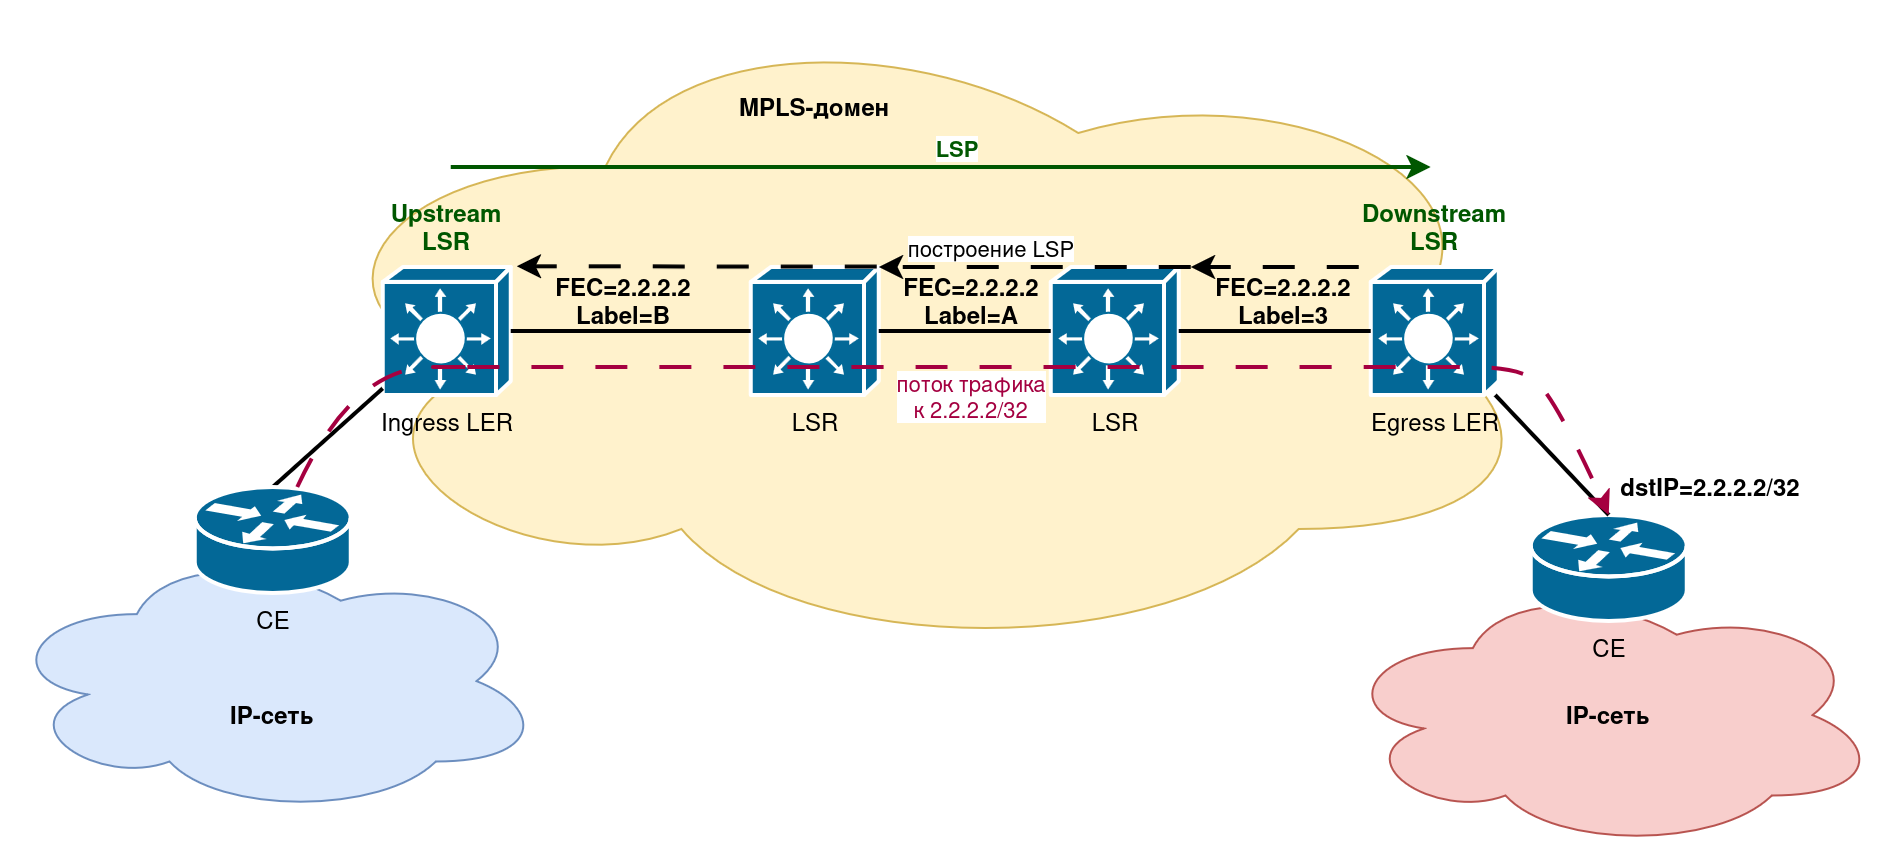
При построении LSP FEC и MPLS-метки определяются и распределяются от Downstream-LSR к Upstream-LSR (от Egress-LER к Ingress-LER), таким образом можно сказать, что построение LSP (распространение информации о FEC и MPLS-метках) происходит навстречу потоку данных (навстречу FEC):
Downstream-LSR определяет FEC на основе таблицы IP‑маршрутизации, назначает метку для каждого FEC и записывает соответствие между метками и FEC в специальную таблицу плоскости управления (LIB). Затем Downstream-LSR инкапсулирует это соответствие в Advertisement-сообщение и отправляет его Upstream-LSR. По мере выполнения этого процесса LIB создаются и наполняются на всех LSR MPLS-домена и на их основе возможно заполнение аппаратных таблиц коммутации меток (LFIB) для передачи MPLS-трафика по LSP.
В текущей версии ПО отсутствует поддержка статической конфигурации LSP. Построение LSP возможно только динамически, с помощью протокола LDP.
Базовый процесс коммутации пакетов по меткам в MPLS-домене
Для успешной коммутации MPLS-трафика необходима согласованная работа базовых механизмов и протоколов маршрутизации с протоколами MPLS-стека, а также консистентное заполнение аппаратных и программных таблиц, формируемых в результате работы протоколов на устройстве.
С точки зрения архитектуры сетевых устройств механизмы и протоколы могут быть выделены в две основные группы, также называемые плоскостями:
- Плоскость управления (Control Plane) — генерирует и поддерживает информацию об IP-маршрутах и MPLS-метках, топологическую информацию, информацию о лучших путях;
- Плоскость передачи данных (Data Plane) — отвечает за передачу IP- и MPLS-пакетов на основании результатов работы протоколов и механизмов плоскости управления.
Плоскость управления решает задачи построения IP/MPLS-топологии сети, обмена маршрутной информацией между устройствами домена, выбора лучших путей передачи трафика. На этой плоскости работают протоколы маршрутизации IGP: OSPF, IS-IS и протокол назначения и распространения меток — LDP. Результаты работы протоколов плоскости управления помещаются в программные таблицы:
- RIB-таблица (Routing Information Base) — таблица информации об IP-маршрутах, формируется протоколами IP-маршрутизации (IGP, BGP), содержит все известные протоколам маршруты и используется для выбора лучших маршрутов;
- LIB-таблица (Label Information Base) — таблица информации о метках, формируется протоколом LDP и используется для управления MPLS-метками и FEC.
Плоскость передачи данных на основании результатов работы протоколов плоскости управления обслуживает аппаратные элементы чипа коммутации и механизмы аппаратного ускорения инкапсуляции/декапсуляции трафика, MTU, TTL, QoS, PHP и т. д. для обеспечения пересылки IP- и MPLS-пакетов на скоростях, близких к максимальным возможностям физических интерфейсов (wire-speed). Данная плоскость выполняет программирование CAM, TCAM, LPM, ingress/egress очередей матрицы коммутации, буферов, интерфейсов и иных элементов чипа коммутации. Результаты работы механизмов плоскости передачи данных помещаются в аппаратные таблицы:
- FIB (Forwarding Information Base) — таблица передачи, которая формируется на основе информации о лучших маршрутах, полученной из RIB, и используется для передачи IP-пакетов в плоскости передачи данных.
- LFIB (Label Forwarding Information Base) — таблица передачи по меткам, которая формируется на основе информации о FEC и MPLS-метках из LIB и используется для передачи MPLS-пакетов в плоскости передачи данных.
Архитектура MPLS в плоскости управления и в плоскости передачи данных:
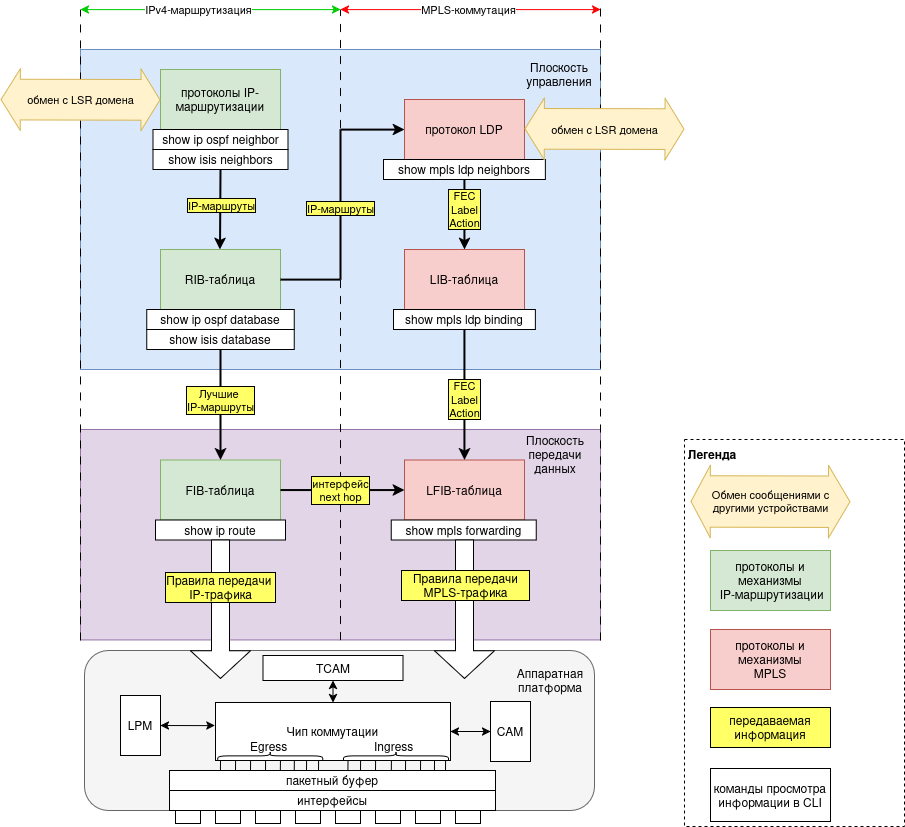
Выше приведена диаграмма, кратко описывающая основные элементы архитектуры — плоскости, протоколы, таблицы и их взаимодействие в рамках устройства.
Также указаны базовые команды CLI, позволяющие распечатать таблицы, формируемые основными протоколами обеих плоскостей.
Penultimate Hop Popping
В целях оптимизации процесса коммутации, на LSR MPLS-домена применяется функция PHP (Penultimate Hop Popping): на предпоследнем транзитном LSR в LSP (Penultimate-LSR) MPLS-заголовок, содержащий верхнюю MPLS-метку в стеке, удаляется из пакета, передаваемого на Egress-LER. Egress-LER пересылает IP-пакет напрямую согласно правилам IP-маршрутизации из FIB или пересылает пакет, используя следующую метку в случае стека меток. Это позволяет разгрузить Egress-LER от повторной обработки трафика и исключает перерасход аппаратных ресурсов для инкапсуляции/декапсуляции MPLS-заголовков непосредственно соединенными LSR.
Egress-LER по умолчанию выделяет для FEC и передает Penultimate-LSR служебную метку со значением 3, таким образом, для входящего на LER трафика всегда будет выполняться PHP на вышестоящем LSR.
В процессе коммутации LSR MPLS-домена выполняют базовые операции с MPLS-метками — push, swap и pop, в зависимости от роли LSR в LSP (Ingress/Transit/Penultimate/Egress):
Push (добавление) — выполняется для IP-пакета на Ingress-LER при входе в MPLS-домен, также MPLS-заголовок с новой меткой может быть добавлен в начало стека меток при наличии MPLS-заголовка в передаваемом пакете;
Swap (замена) — в процессе передачи MPLS-пакета по LSP все следующие за ingress-LER транзитные downstream-LSR, кроме последнего LSR перед Egress-LER, выполняют замену метки в начале стека меток MPLS-пакета на метку, выделенную следующим узлом, в соответствии с LFIB;
Pop (удаление) — удаление метки из MPLS-пакета выполняется на Egress-LER при выходе пакета из MPLS-домена в non-PHP режиме передачи или на Penultimate-LSR в LSP в PHP-режиме передачи.
Базовая схема коммутации MPLS-пакетов по меткам:
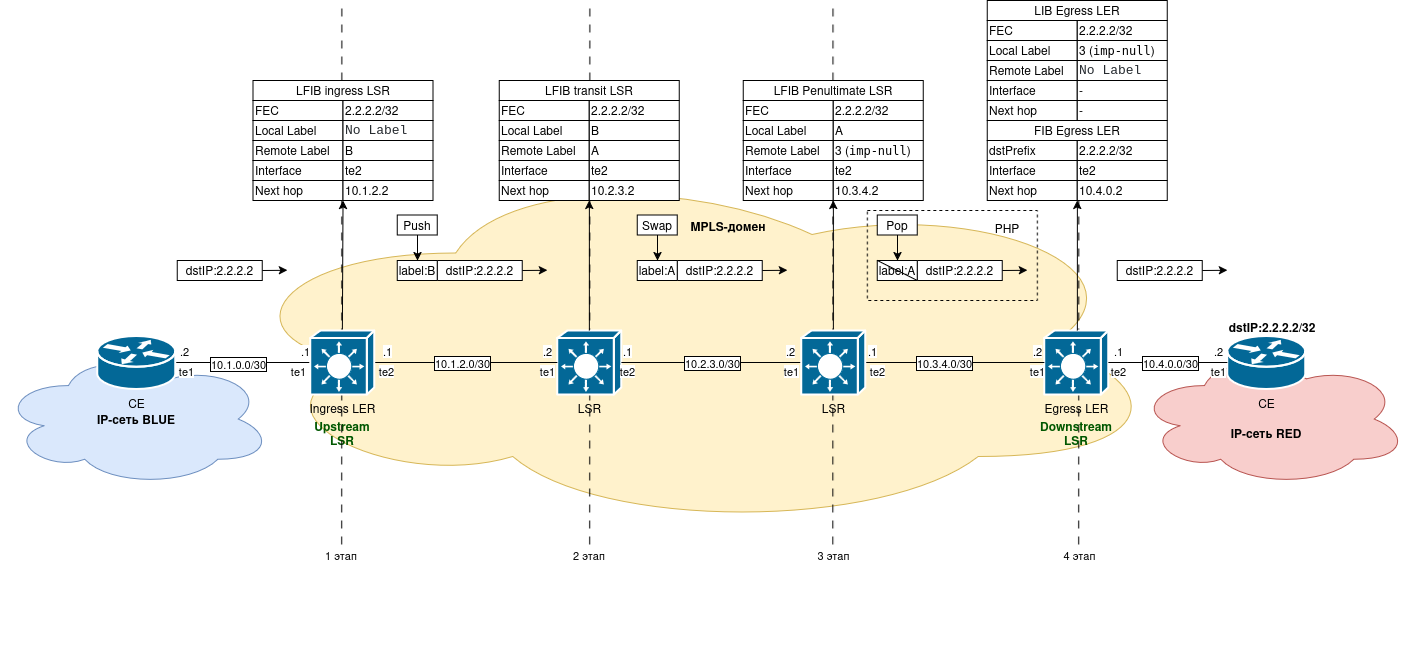
На схеме выше поэтапно представлен базовый процесс коммутации в MPLS-домене с Egress-LER в PHP-режиме:
1 ЭТАП:
Ingress-LER получает IP-пакет, предназначенный для 2.2.2.2, согласно информации из LFIB выполняет операцию push и добавляет MPLS-заголовок с меткой «B», полученной от downstream-LSR.
2 ЭТАП:
Транзитный LSR получает пакет с меткой и при передаче нижестоящему LSR согласно информации из LFIB выполняет операцию swap, заменяя в MPLS-заголовке метку «B» на метку «A».
3 ЭТАП:
Penultimate-LSR получает пакет с меткой «A» и согласно информации из LFIB удаляет MPLS-заголовок, поскольку Egress-LER работает в режиме PHP и для FEC 2.2.2.2 распространяет информацию о служебной MPLS-метке со значением «3», соответственно данные на Egress-LER передаются декапсулированными, как «обычный» IP-пакет.
4 ЭТАП:
Egress-LER получает IP-пакет и пересылает его в сторону IP-сети назначения согласно информации из FIB.
Базовая архитектура MPLS L3 VPN
Стек технологий MPLS позволяет строить наложенные и изолированные друг от друга частные виртуальные сети (VPN) — Overlay-сети поверх базовой IP-сети (Underlay-сеть).
Для построения overlay L3 VPN сетей используются функциональности IP VRF и MP-BGP:
- IP VRF (IP Virtual Routing and Forwarding) — позволяет создавать и работать с несколькими изолированными экземплярами таблиц маршрутизации на одном устройстве;
- MP-BGP (Multiprotocol BGP) — позволяет BGP работать с дополнительными типами семейств адресов и расширенными комьюнити, что позволяет устройствам гибко управлять VPN-маршрутами и обмениваться ими между собой в рамках автономной системы.
Согласованное использование обеих функций позволяет организовать автоматический обмен маршрутной информацией с помощью MP-BGP между VRF только на пограничных устройствах MPLS-домена, без необходимости изоляции трафика с помощью VRF на промежуточных устройствах MPLS-домена, в отличие от т. н. VRF-Lite варианта использования функции VRF, при котором изоляция IP-маршрутов требует развертывания экземпляров VRF и настройки протоколов маршрутизации в каждом экземпляре на каждом устройстве сети.
В текущей версии ПО поддержана работа MP-BGP AF VPNv4 Unicast и Extended BGP Communities, реализована поддержка построения overlay IPv4 VPN сетей с помощью стека технологий MPLS на устройствах одной автономной системы.
Underlay IP/MPLS-сеть строится с использованием IGP-протоколов маршрутизации (OSPF, IS-IS) и LDP и может быть выделена в отдельную логическую структуру в рамках устройства — транспортную плоскость.
Стек Overlay-технологий, в частности MP-BGP и VRF, может быть выделен в отдельную логическую структуру в рамках устройства — сервисную плоскость.
Стек технологий BGP/MPLS L3 VPN позволяет организовать сервис изолированных частных виртуальных сетей, поверх базовой IP/MPLS-сети. VPN-маршруты изолированы от маршрутов базовой транспортной IP/MPLS-сети, а маршруты экземпляров VPN изолированы друг от друга.
Базовая структура сети с задействованием BGP/MPLS L3 VPN:
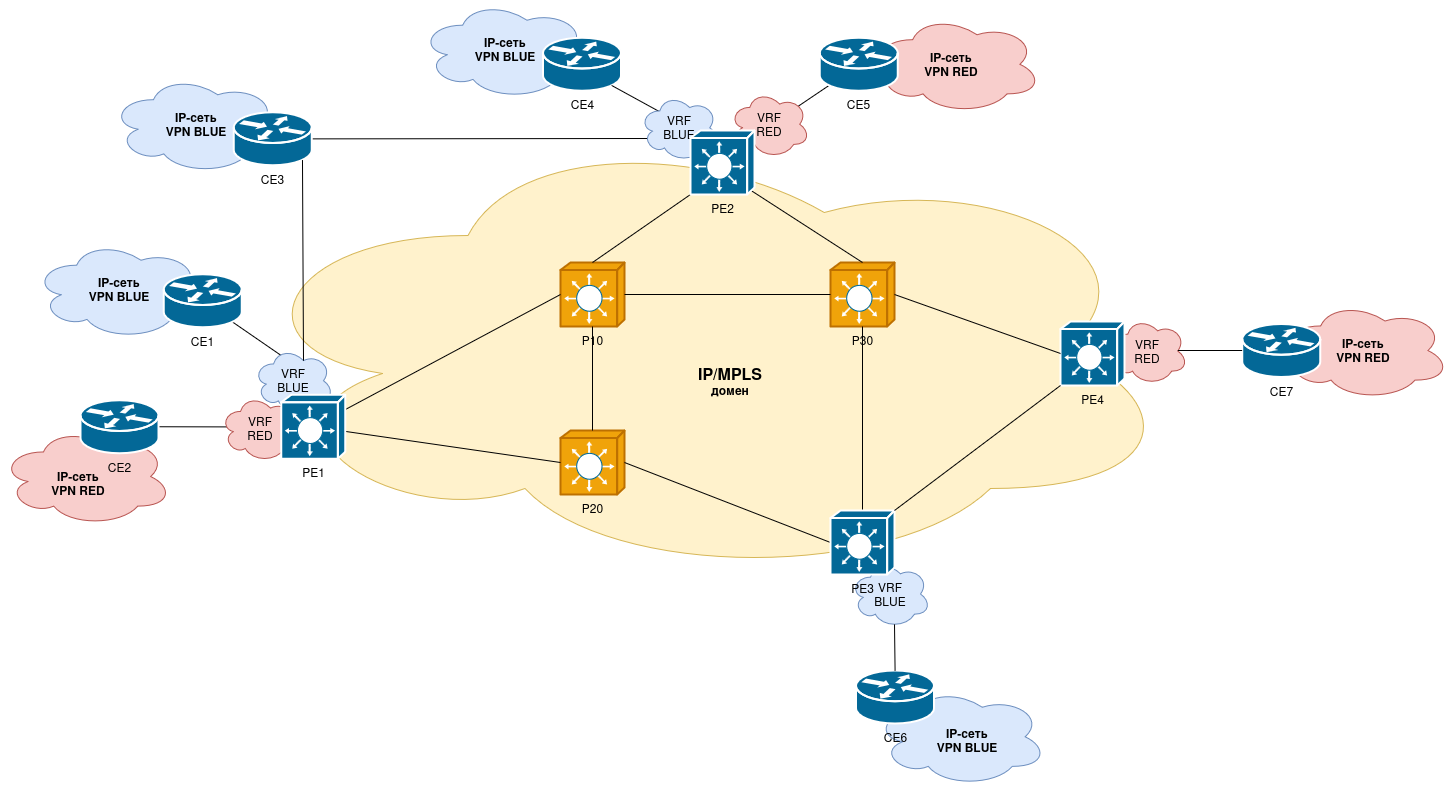
На схеме выше приведен пример теоретической IP/MPLS-сети с развернутыми BGP/MPLS L3 VPN-сервисами, устройства именованы согласно их роли в представленной сети:
CE (Customer Edge) — пограничное устройство IP-сети, подключаемой к L3 VPN: маршрутизатор, коммутатор или хост, который не является участником MPLS-домена;
PE (Provider Edge) — пограничный маршрутизатор MPLS-домена, выполняет функции сервисной плоскости: терминирует IP-интерфейсы в VRF для подключения CE к соответствующим L3 VPN сетям, также может выполнять функции транспортной плоскости при передаче транзитных MPLS-пакетов;
- Ingress-PE — первый PE-маршрутизатор на пути исходящего трафика от CE-источника, отвечает за инкапсуляцию VPN-трафика в MPLS;
- Egress-PE — последний PE-маршрутизатор на пути VPN-трафика к CE-назначения, отвечает за декапсуляцию MPLS и передачу IP-трафика к CE;
P (Provider) — маршрутизатор MPLS-домена, выполняющий функции транспортной плоскости по передаче транзитных MPLS-пакетов, не выполняет функций сервисной плоскости, соответственно не терминирует на себе VPN-сервисы, не обрабатывает и не хранит VPN-маршруты.
Исходя из ролей устройств и представленной схемы, сеть будет иметь следующие свойства:
- Сервисы L3 VPN и их изоляцию друг от друга:
- Сервис IP VPN RED, в рамках которого CE2 может взаимодействовать только с CE5 и CE7, IP-сети, обслуживаемые этими узлами, взаимодействуют аналогично;
- Сервис IP VPN BLUE, в рамках которого CE1 может взаимодействовать только с CE3, CE4 и CE6, IP-сети, обслуживаемые этими узлами, взаимодействуют аналогично;
- Интерфейсы и маршруты IP VPN RED и IP VPN BLUE на PE-маршрутизаторах PE1-PE4 изолированы как друг от друга, так и от маршрутов и интерфейсов в глобальной таблице маршрутизации — GRT, за счет использования функциональности VRF.
- Совмещение функций P и PE на маршрутизаторах:
- Маршрутизатор PE3 совмещает функции P- и PE на маршрутизаторах;
- Любой из PE-маршрутизаторов схемы может одновременно выполнять функции P и PE при отказах прямых линков.
- Оптимальное использование аппаратных ресурсов:
- P-маршрутизаторы P10–P30 не терминируют на себе VPN-сервисы, не обрабатывают и не хранят VPN-маршруты.
Схемы подключения CE к PE
Выбор схемы подключения (стыка) CE к PE зависит от типа CE-устройства и его функциональных возможностей, стека протоколов, используемых на стыке, требований к масштабируемости и резервированию, часто планируется с учетом существующей инфраструктуры сети.
В зависимости от типа CE и его функциональных возможностей можно выделить следующие виды схем подключения CE к PE, со своими особенностями и требованиями:
- Схема подключения на L2 — Ethernet-стык (L2-стык):
- Требует терминации L3 VPN-сервиса на PE на SVI (Switch Virtual Interface) — логическом IP-интерфейсе с привязкой к VLAN и настройкой коммутируемых портов/LAG на PE;
- Подразумевает изоляцию сервисов по VLAN на коммутируемых портах в режимах access/trunk/general, позволяет производить манипуляции/мутации с VLAN-ID на интерфейсе;
- Позволяет задействовать на стыке протоколы группы xSTP, механизмы контроля и управления трафиком BUM (Broadcast, Unknown Unicast, Multicast) и т. п.;
- Подходит для подключения к PE существующей L2-инфраструктуры и использования в качестве CE-устройств L2-коммутаторов и оконечных устройств.
- Схема подключения на L3 — IP-стык (L3-стык):
- Допускает терминацию L3 VPN-сервиса на PE как на физическом интерфейсе/LAG, так и на SVI;
- Позволяет использование непосредственно присоединенных сетей, статической маршрутизации или протоколов динамической маршрутизации — OSPF, eBGP;
- Подходит для подключения существующей L3-инфраструктуры и использования в качестве CE-устройств L3-коммутаторов, маршрутизаторов и оконечных устройств.
- Смешанная схема подключения:
- Допускает терминацию L3 VPN-сервиса на PE как на физическом интерфейсе/LAG, так и на SVI;
- Позволяет задействовать протоколы и функции L2- и L3-уровня;
- Подходит для подключения существующей смешанной инфраструктуры и различных CE-устройств, в т. ч. для подключения CE к нескольким VPN-сервисам.
В зависимости от требований к масштабируемости и резервированию можно выделить следующие виды схем подключения CE к PE:
- Single-homing — CE-устройство имеет только одно физическое или логическое соединение с одним PE:
- Простая схема подключения, может быть осуществлена со стыками любого типа;
- Возможно резервировать линк между CE и PE и масштабировать его пропускную способность с помощью функциональности агрегации каналов (LAG);
- Имеет единую точку отказа — PE;
- Multi-homing — CE-устройство имеет несколько независимых физических или логических соединений с разными PE;
- Dual-homing — разновидность схемы multi-homing, при которой CE-устройство имеет два независимых физических или логических соединения с разными PE. Данная схема имеет два основных режима работы:
- Active-Active — все каналы находятся в активном состоянии и одновременно обрабатывают трафик:
- Требует использования L3-стыков CE с PE, поддержки со стороны CE-устройства протоколов динамической маршрутизации и механизма ECMP;
- Позволяет максимально эффективно использовать доступную полосу пропускания между CE и PE;
- Позволяет минимизировать потери трафика при выходе из строя одного из каналов при использовании BFD на каналах.
- Active-Standby — только один канал является активным и обрабатывает весь трафик, второй канал находится в резервном (ожидающем) состоянии и не несет нагрузки:
- Допускает использование L2-стыков при терминации L3 VPN-сервиса на PE и задействовании VRRP;
- Для L2-стыков возможно дополнительно резервировать линк между CE и PE и масштабировать его пропускную способность с помощью функционала M-LAG (VPC);
- Снижает требования к функциональности CE-устройств для L3-стыков за счет возможности использования более простых, базовых механизмов маршрутизации.
- Active-Active — все каналы находятся в активном состоянии и одновременно обрабатывают трафик:
Базовые принципы работы транспортной плоскости
Обеспечение транспортных функций устройств в Underlay-сети реализуется за счет следующих механизмов:
- Построение базовой IP сети с использованием динамических протоколов маршрутизации OSPF, IS-IS, позволяющее обеспечить рекурсивную маршрутизацию трафика между loopback-интерфейсами устройств в GRT:
- Построение MPLS-домена с использованием протокола LDP и построение MPLS-туннелей между loopback-интерфейсами устройств в глобальной таблице маршрутизации — GRT для последующего построения overlay сети и передачи сервисного трафика.
Настройка IP-связности и IGP на Underlay-сети
Для построения базовой IP-связности необходимо:
- Распределить согласно адресному плану линковые подсети и настроить IP-интерфейсы на портах маршрутизаторов;
- Распределить согласно адресному плану подсети loopback-интерфейсов и настроить IP-интерфейсы на loopback маршрутизаторов;
- Запустить процесс IGP-протокола и произвести его настройку: Router-ID, ассоциацию интерфейсов, параметры редистрибуции, настройки таймеров сходимости;
- Для оперативного детектирования отказов рекомендуется использование функциональности BFD на интерфейсах линковых сетей.
В целях повышения стабильности и предсказуемости работы Underlay-сети для IP-интерфейсов (линковых, Loopback) LSR, используемых при построении MPLS-туннелей, рекомендуется строгое описание в IGP-процессе и использование internal-типа маршрутов для распространения в MPLS-домене.
Для корректного построения LSP рекомендуется обязательное использование редистрибуции connected-маршрутов в AF LDP.
В текущей версии ПО не поддержана совместная работа MPLS и dot1q на одном интерфейсе.
Корректная работа MPLS возможна только с трафиком без заголовков dot1q (VLAN).
Настройка LDP на Underlay-сети
Для построения базовой IP/MPLS-связности необходимо:
- Запустить процесс LDP глобально и выполнить настройку Router-ID (LSR-id) и параметров редистрибуции маршрутов из IGP в LDP;
- Включить функциональность MPLS IP на линковых IP-интерфейсах маршрутизаторов.
Для корректного построения LSP между loopback-интерфейсами LSR MPLS-домена настройка редистрибуции connected-маршрутов в LDP AF IPv4 Unicast обязательна.
Для ускорения сходимости LDP и стабильности его работы рекомендуется редистрибутировать в LDP только те типы IGP-маршрутов, с помощью которых действительно будет распространяться информация о FEC, например internal-маршруты.
Базовая структура Underlay IP/MPLS-сети:
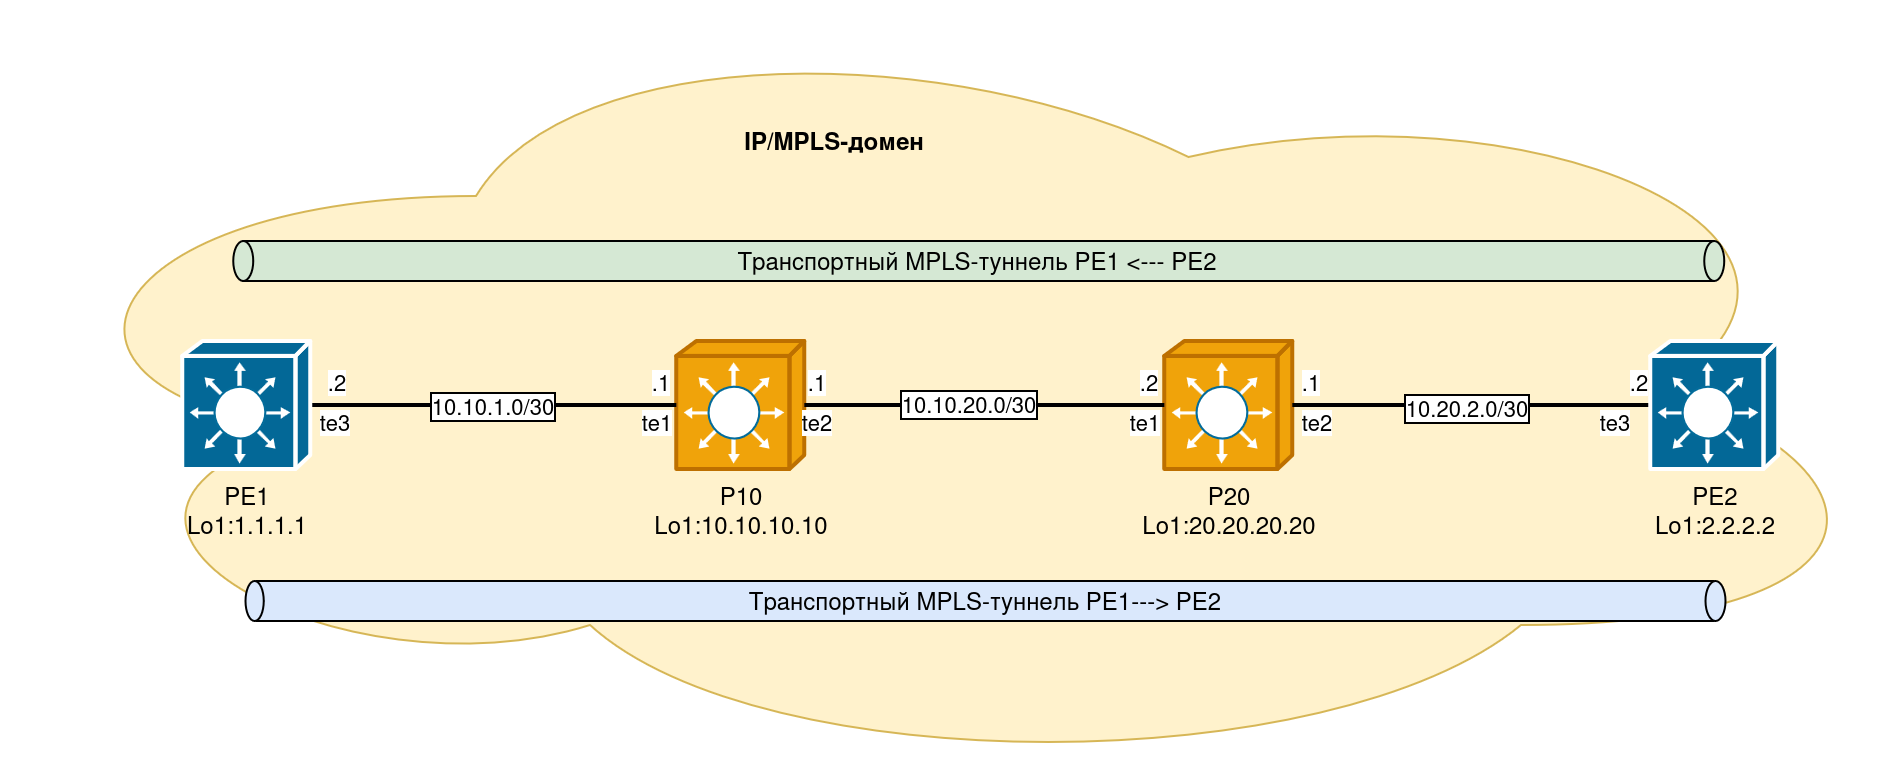
Как видно из рисунка выше, между loopback-интерфейсами PE1 и PE2 будут построены два однонаправленных MPLS-туннеля во встречных направлениях. Данные транспортные MPLS-туннели будут использоваться для обеспечения работы Overlay-протоколов и передачи VPN-трафика между PE-маршрутизаторами.
В текущей версии ПО не поддержана функциональность LDP IGP Synchronization (RFC 5443).
Возможны последовательные перестроения LSP на этапах сходимости протоколов в MPLS-домене и возникновение последовательных перерывов сервиса при перестроениях L3-топологии сети, ввиду возникновения рассинхронизации IGP- и LDP-протоколов.
Так как IGP (OSPF/IS-IS) имеет более высокую скорость сходимости, чем LDP, это может приводить к потерям трафика (Blackholing):
- При появлении нового линка в топологии сходимость IGP происходит быстрее, чем LDP строит LSP и пакеты отбрасываются, пока LDP не «догонит» IGP;
- При сбое LDP-сессии, но штатной работе IGP MPLS-трафик будет продолжать продвигаться по сети, но может перестать корректно обрабатываться.
Для добавления задержки на установку OSPF-маршрутов в FIB до полной сходимости в OSPF-топологии при перезапуске маршрутизаторов рекомендуется использовать функциональность max-metric router-lsa on-startup.
Использование ECMP на Underlay IP/MPLS-сети
Для повышения отказоустойчивости в сети зачастую необходимо иметь несколько эквивалентных альтернативных путей между маршрутизаторами. Для оптимального использования пропускной способности в таких сетях используется технология ECMP (Equal Cost Multipath), позволяющая передавать и балансировать трафик до одного узла или группы узлов назначения по нескольким альтернативным равнозначным путям за счет построения альтернативных LSP. Совокупность равнозначных альтернативных путей (LSP) до узла назначения (FEC) формирует ECMP-группу.
В текущей версии ПО поддержана только статическая аллокация IP ECMP-ресурсов для MPLS LSP. Во избежание перерасхода и дефицита аппаратных ресурсов устройства рекомендуется устанавливать значение ip maximum-paths не более 4 альтернативных путей.
Балансировка трафика выполняется по потокам per-flow, формирование потоков возможно на основании значений SIP, DIP, Proto, SPort, DPort — 5-Tuple. Tuple или кортеж — это набор из нескольких полей пакета, используемый для идентификации потока данных. Пакеты с совпадающими значениями классифицируются как один поток (flow) и отправляются по одному пути.
Для реализации per-flow балансировки на основании кортежей используется процедура хеширования — получение результата работы Hash-функции (хэш-функции) от значения кортежа. Хэш-функция — это математическая функция, служащая для преобразования входных числовых данных переменной длины в числовую строку фиксированной длины, которая обладает следующими свойствами:
- Детерминированность (постоянство) — результат работы хэш-функции не изменяется для одного и того же набора входных данных при любом числе повторений вычислений;
- Фиксированный размер — длина строки результата работы функции не зависит от длины строки входных данных;
- Необратимость — по результату работы функции невозможно восстановить исходные данные.
Выбор пути для различных потоков будет разрешаться на основании остатка от деления по модулю результата хеширования для того или иного потока на количество альтернативных путей в ECMP-группе. Пакеты с одинаковым набором значений полей используемого кортежа будут иметь одинаковый результат хеширования, дадут одинаковый остаток от деления на число активных альтернативных путей и будут направлены по одному и тому же пути.
На коммутаторах MES возможно изменение алгоритма балансировки путем изменения набора полей для кортежа. Алгоритм балансировки изменяется глобально и является единым как для балансировки коммутируемого L2-трафика по портам LAG, так и для ECMP-балансировки маршрутизируемого IP-трафика.
В L3 VPN ECMP-группы используются на входном PE-маршрутизаторе для распределения трафика между несколькими туннелями (LSP) к одному и тому же удаленному PE.
Базовая структура Underlay IP/MPLS-сети с ECMP:
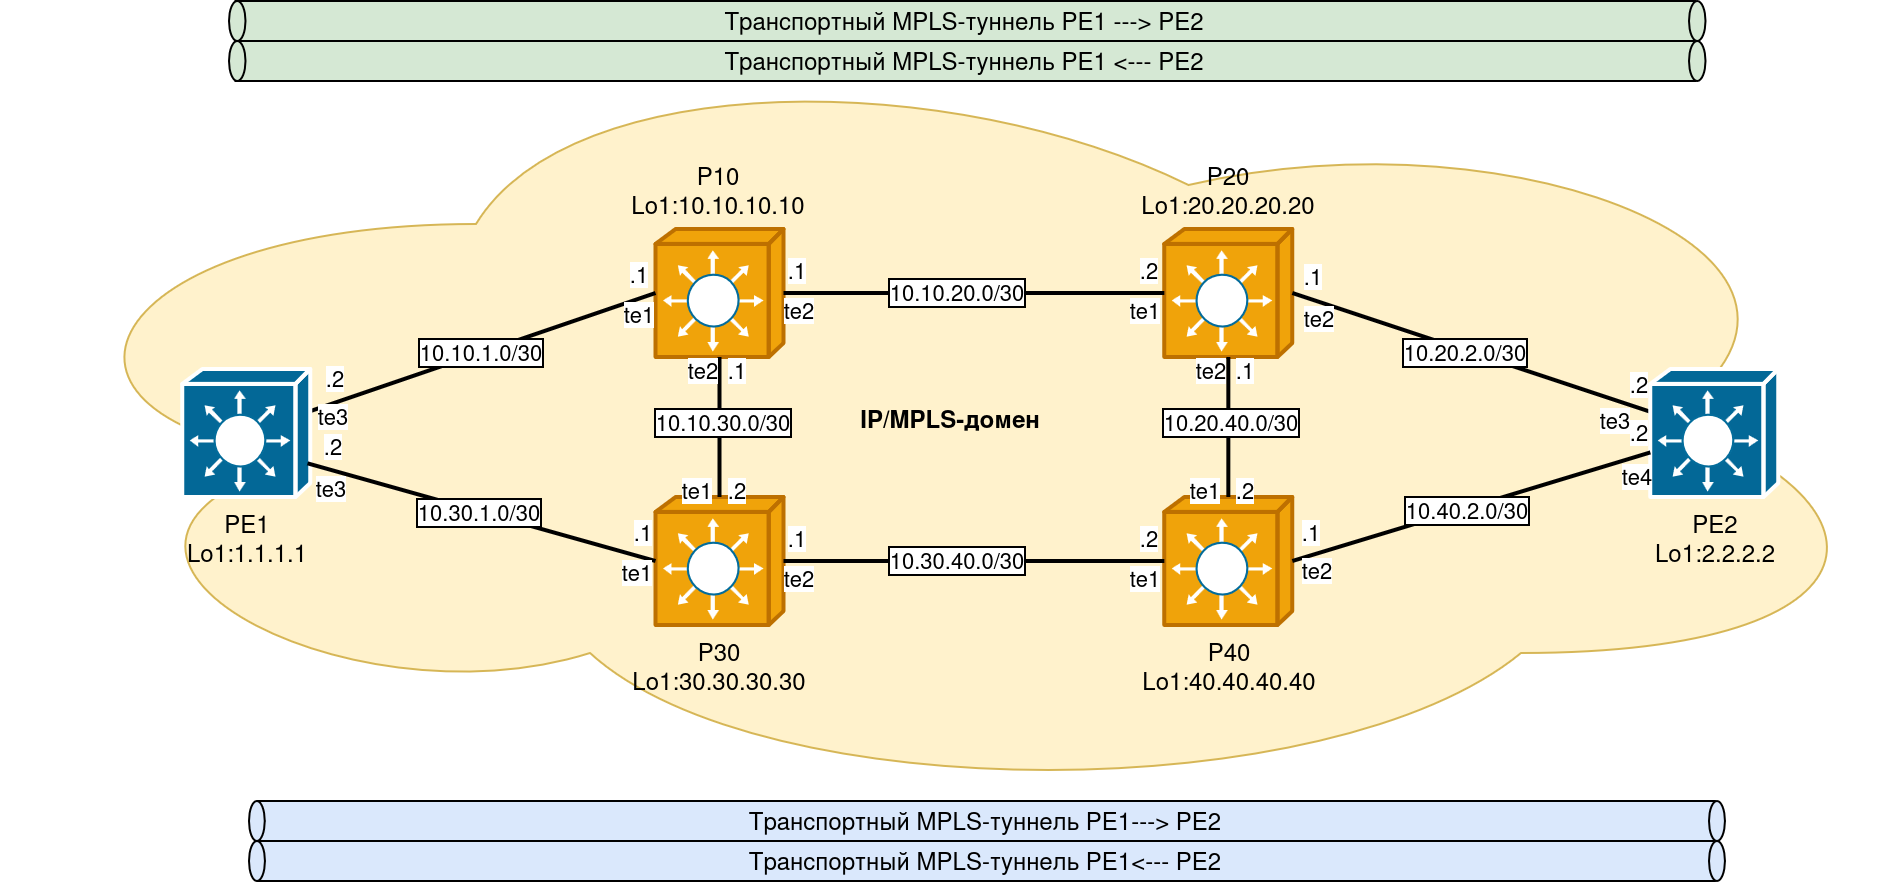
Как видно из рисунка выше, PE1 и PE2 имеют по 2 равнозначных альтернативных пути друг к другу, соответственно, между loopback-интерфейсами PE1 и PE2 будут построены два набора равнозначных однонаправленных MPLS-туннелей во встречных направлениях.
Транспортные MPLS-туннели будут использоваться для обеспечения работы Overlay-протоколов и последующей передачи VPN-трафика между PE-маршрутизаторами.
Альтернативным LSP будут выделяться одинаковые локальные MPLS-метки, но для каждого из них может быть получена своя удаленная MPLS-метка. Балансировка трафика по альтернативным путям будет выполняться на основании решений IP-маршрутизации для того или иного потока данных. Балансировка будет выполняться и для VPN-трафика, т. к. инкапсуляция MPLS-заголовков происходит уже после принятия решения о балансировке.
В текущей версии ПО балансировка VPN-трафика может выполняться только на PE-маршрутизаторе.
Эффект поляризации трафика и параметры hash-функций
Детерминированность алгоритмов хеширования, используемых для балансировки на схожем оборудовании, при его каскадном включении в сети будет приводить к возникновению эффекта поляризации — последовательной балансировке трафика одного потока по одним и тем же путям на всем протяжении пути по сети.
Диаграмма поляризации per-flow-трафика при использовании ECMP:
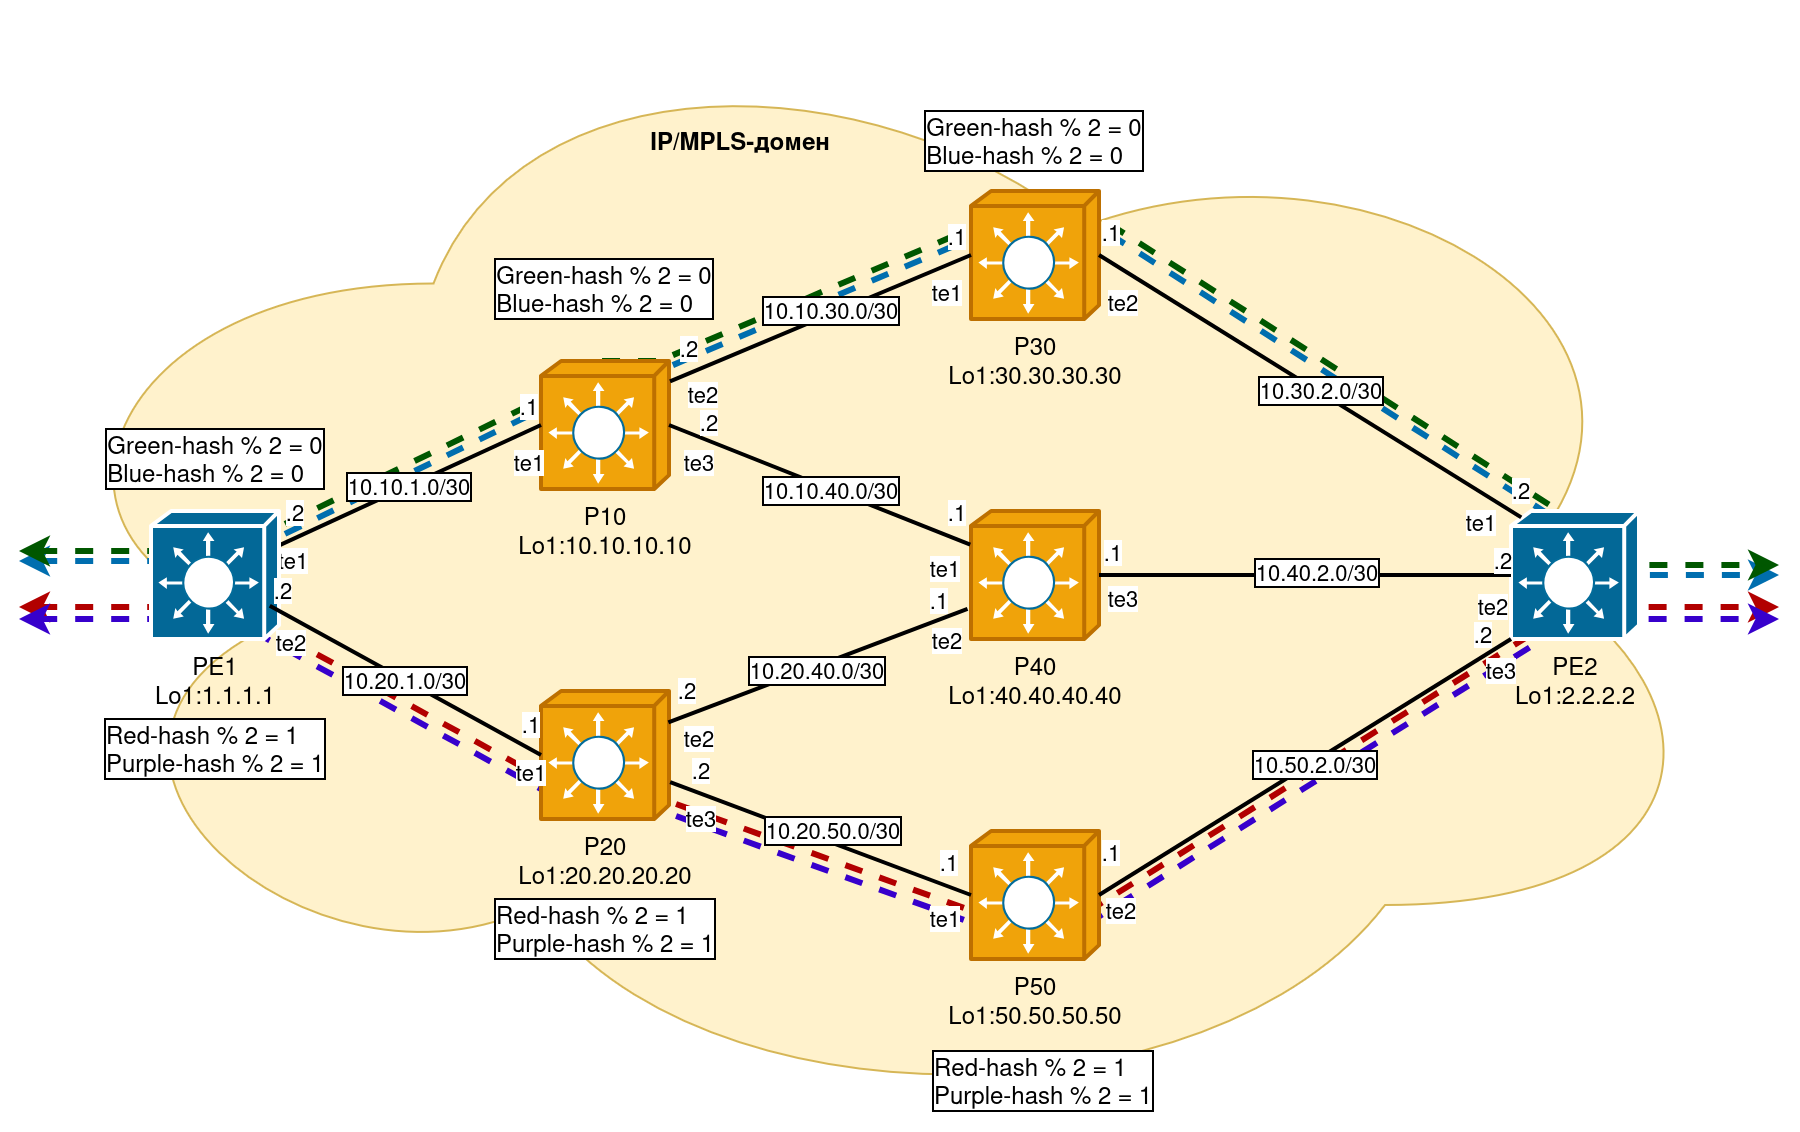
В целях борьбы с поляризацией трафика на схожем оборудовании в сетях с каскадной структурой имеется возможность изменения двух параметров hash-функции, которая используется в механизме балансировки трафика: salt и seed.
Salt (соль) — случайное число, которое добавляется к кортежу перед вычислением хэша, используется для рандомизации выбора пути, чтобы избежать направления одного и того же потока трафика на один и тот же путь в ECMP-группе.
Seed (зерно) — начальное число (инициализатор) для хэш-функции: при одном и том же значении Seed хэш-функция всегда будет выдавать один и тот же результат для одинаковых входных данных.
Оба параметра могут иметь числовое значение в диапазоне от 1 до 4294967295, по умолчанию равны 0 (не влияют на расчет хэш-функции). При изменении параметров хэш-функции на коммутаторе можно влиять на балансировку трафика в пределах ECMP-групп. Настройка разных значений этих параметров на разных устройствах позволяет получать для одного и того же пакета разный результат на выходе хэш-функции. Соответственно может быть принято решение о балансировке пакета в другой линк из состава LAG для балансировки коммутируемого L2-трафика или на другой путь в составе ECMP-группы при балансировке коммутируемого MPLS-трафика и маршрутизируемого L3-трафика.
При архитектуре с каскадным включением LSR в MPLS-домене рекомендуется устанавливать уникальные значения salt и seed на каждом LSR домена. Рекомендуется использовать единую формулу расчета значений для всего домена и использовать в ней router-id как безусловно уникальный атрибут любого LSR в домене.
Например:
salt = uint32(router-id), т.е. полное 32-битное значение router-id;
seed = router-id XOR 0xDEADBEEF.
Базовые принципы работы сервисной плоскости
Для организации сервиса L3 VPN внутри транспортных MPLS-туннелей поверх базовой IP/MPLS-сети одной автономной системы между PE-маршрутизаторами MPLS-домена строится Overlay-сеть на базе расширенного протокола MP-BGP.
PE-маршрутизаторы используют MP-BGP для обмена маршрутной информацией в сервисной плоскости. В отличие от BGP AF IPv4 Unicast, работающего только с уникальными IPv4-маршрутами, MP-BGP расширяет возможности протокола за счёт семейства VPNv4 Unicast, которое предназначено для передачи маршрутов L3 VPN.
BGP AF VPNv4 Unicast использует 12-байтовый формат адресов, состоящий из 8-байтового Route Distinguisher (RD) и 4-байтового IPv4-префикса. Наличие RD позволяет BGP различать маршруты с одинаковыми IP-адресами, но принадлежащими разным VPN.
Route Reflector
Так как PE-маршрутизаторы принадлежат одной автономной системе, взаимодействие между ними будет производиться по Underlay-адресам loopback-интерфейсов в режиме iBGP, который требует полносвязной топологии между всеми участниками. Для масштабирования сети и эффективного использования ресурсов маршрутизаторов рекомендуется выделение одного или нескольких маршрутизаторов домена под роль центрального узла для распространения маршрутной информации с помощью MP-BGP и обмена маршрутной информацией.
В автономной системе с RR iBGP-маршрутизаторы будут иметь две роли:
- RR (Route Reflector) — центральный узел для распространения маршрутной информации с помощью отражения MP-BGP маршрутов, к которому строят BGP-сессии все BGP-маршрутизаторы домена;
- RR-клиент (Route Reflector Client) — «обычный» BGP-маршрутизатор домена, строящий BGP-сессию только до RR-маршрутизатора и обменивающийся маршрутной информацией только с ним.
Маршрутизатор с ролью Route Reflector работает по правилам отражения маршрутов:
- При отражении маршрутов клиентов BGP-атрибут «
NEXT_HOP» остается неизменным; - При отражении маршрутов RR добавляет в маршрут атрибут «
CLUSTER_LIST» и дополняет его со своим cluster-id (по умолчанию равен router-id); - При получении маршрутов со своим cluster-id в «
CLUSTER_LIST» RR отбрасывает эти маршруты; - Маршруты, полученные от клиента, отражаются другим клиентам и non-client iBGP-соседям (другим RR);
- Маршруты, полученные от non-client, отражаются клиентам;
- Маршруты, полученные от eBGP-соседей, отражаются всем клиентам и non-client.
Если cluster-id не настроен явно, каждый RR по умолчанию использует в качестве идентификатора свой router-id.
В целях повышения отказоустойчивости рекомендуется использовать более одного RR на группу PE (каждый PE такой группы строит сессию со всеми RR группы) и устанавливать non-client iBGP-соседства между всеми RR одной группы.
Для предотвращения переотражения маршрутов между RR группы при изменениях топологии рекомендуется явно задавать одинаковый cluster-id на всех RR группы — объединять RR в кластер.
В качестве общего cluster-id рекомендуется использовать минимальный из router-id RR кластера. Уникальность router-id в пределах AS при этом обязательна.
Формат и особенности VPNv4-маршрутов
VPNv4-маршрут — маршрут специального формата, используемый MP-BGP для распределения маршрутной информации L3 VPN между PE-маршрутизаторами.
В отличие от стандартного IPv4-маршрута (4 байта), VPNv4-маршрут имеет длину 12 байт и состоит из двух частей:
- Route Distinguisher (RD) — 8 байт, уникальный идентификатор, обеспечивающий глобальную уникальность маршрута;
- IPv4-префикс — 4 байта, стандартный IP-адрес назначения с маской подсети.
Диаграмма состава RD:
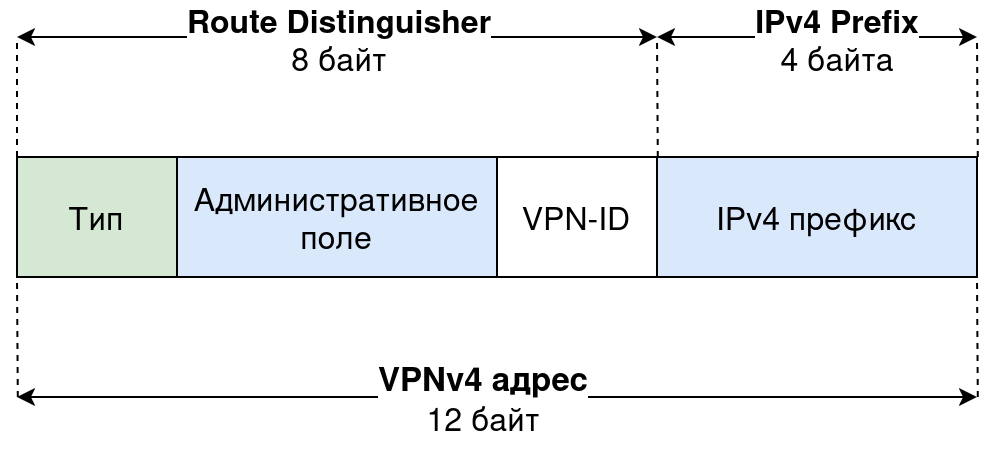
Комбинация RD + IPv4-префикс гарантирует, что два маршрута к одному и тому же IP-адресу из разных VPN будут восприниматься BGP как разные маршруты, что позволяет VPN использовать пересекающиеся (overlapping) пространства IP-адресов.
VRF и BGP Extended Communities
Каждый L3 VPN на PE-маршрутизаторе ассоциируется с отдельным экземпляром VRF, который содержит собственную таблицу маршрутизации, набор интерфейсов, Route Distinguisher и правила импорта/экспорта маршрутов. Это обеспечивает строгую изоляцию трафика различных VPN на одном физическом устройстве.
Для управления распределением VPN-маршрутов между PE-маршрутизаторами используются BGP Extended Communities — расширение стандартного атрибута BGP Communities, предоставляющее 8-байтовое пространство значений вместо 4-байтового. Формат BGP Extended Communities используется для кодирования Route Target (RT).
Диаграмма типов BGP Extended Communities:
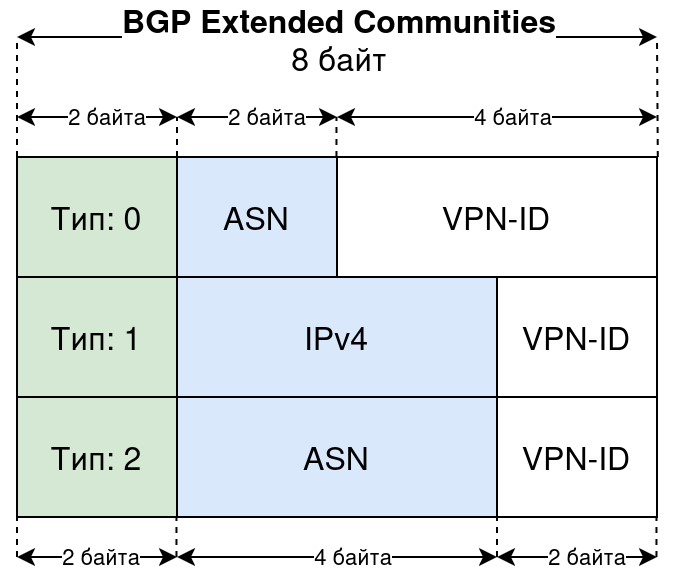
BGP Extended Communities состоит из трех полей:
- Type — поле типа длиной 2 байта, первый байт указывает на тип значений поля Administrator, второй байт — подтип communities (Route Target или Route Origin);
- Administrator — Административное поле — это поле в зависимости от типа длиной 2 или 4 байта, содержит значение IP-адреса или номера AS;
- Assigned Number — Выделенный номер - это поле в зависимости от типа длиной 2 или 4 байта, содержит уникальный в рамках сети идентификатор VPN.
Route Distinguisher
RD не является BGP Extended Communities, хоть и имеет схожий с ним формат, но не несёт в себе маршрутной информации и не используется для принятия решений о пересылке пакетов. RD служит исключительно для создания уникального NLRI (Network Layer Reachability Information) в MP-BGP для VPN-маршрутов, т. е. выполняет функцию уникального маршрутного разделителя для IPv4-префиксов пересекающихся адресных пространств.
Соответственно, существует три типа RD:
- Тип 0 + Administrator (2 байта, номер AS) + Assigned Number (4 байта), пример: 65500:100;
- Тип 1 + Administrator (4 байта, IP-адрес) + Assigned Number (2 байта), пример: 1.1.1.1:100;
- Тип 2 + Administrator (4 байта, 32-битный AS) + Assigned Number (2 байта), пример: 65500.65500:100.
Каждый VRF на PE-маршрутизаторе конфигурируется с уникальным RD, который прикрепляется ко всем IPv4 Unicast маршрутам, импортированным в этот VRF, при экспорте в MP-BGP. Также PE-маршрутизатор удаляет RD при импорте VPNv4 Unicast маршрутов из MP-BGP в VRF.
Применение RD для резервирования маршрутов
В сценариях, когда для обеспечения отказоустойчивости CE-устройство может быть одновременно подключено к VPN на двух PE-маршрутизаторах (dual-homing), при экспорте IPv4 Unicast маршрутов из VRF одного VPN в MP-BGP рекомендуется использовать уникальные RD типа 1 на каждом PE-маршрутизаторе данного VPN. Таким образом, один и тот же IPv4-префикс клиентской сети, анонсируемый с основного и резервного PE, будет представлен в MP-BGP как два разных VPNv4-маршрута с разными RD. В режиме dual-homing active-standby это уменьшит время переключения трафика на альтернативный путь, в режиме dual-homing active-active является обязательным для установки альтернативных путей и корректной работы ECMP.
Ниже подробно рассматриваются два примера с общими условиями:
- CE1 и CE2 являются non-MPLS-устройствами, между которыми организована L3 VPN-связность;
- PE1, PE2 и PE3 являются пограничными устройствами IP/MPLS сети и обмениваются BGP/MPLS VPN-маршрутами от CE с IPv4-префиксом 192.168.0.0/24 на PE;
- CE1 одновременно подключен к PE1, PE2 для обеспечения схемы резервирования dual-homing active-standby;
- PE1 передает VPN-маршрут от CE1 с IPv4-префиксом 192.168.0.0/24 на PE3;
- PE1 также выполняет функцию RR и отражает VPN-маршрут с IPv4-префиксом 192.168.0.0/24 от PE2 к PE3.
Одинаковый RD в схеме с dual-homing active-standby резервированием для CE1:
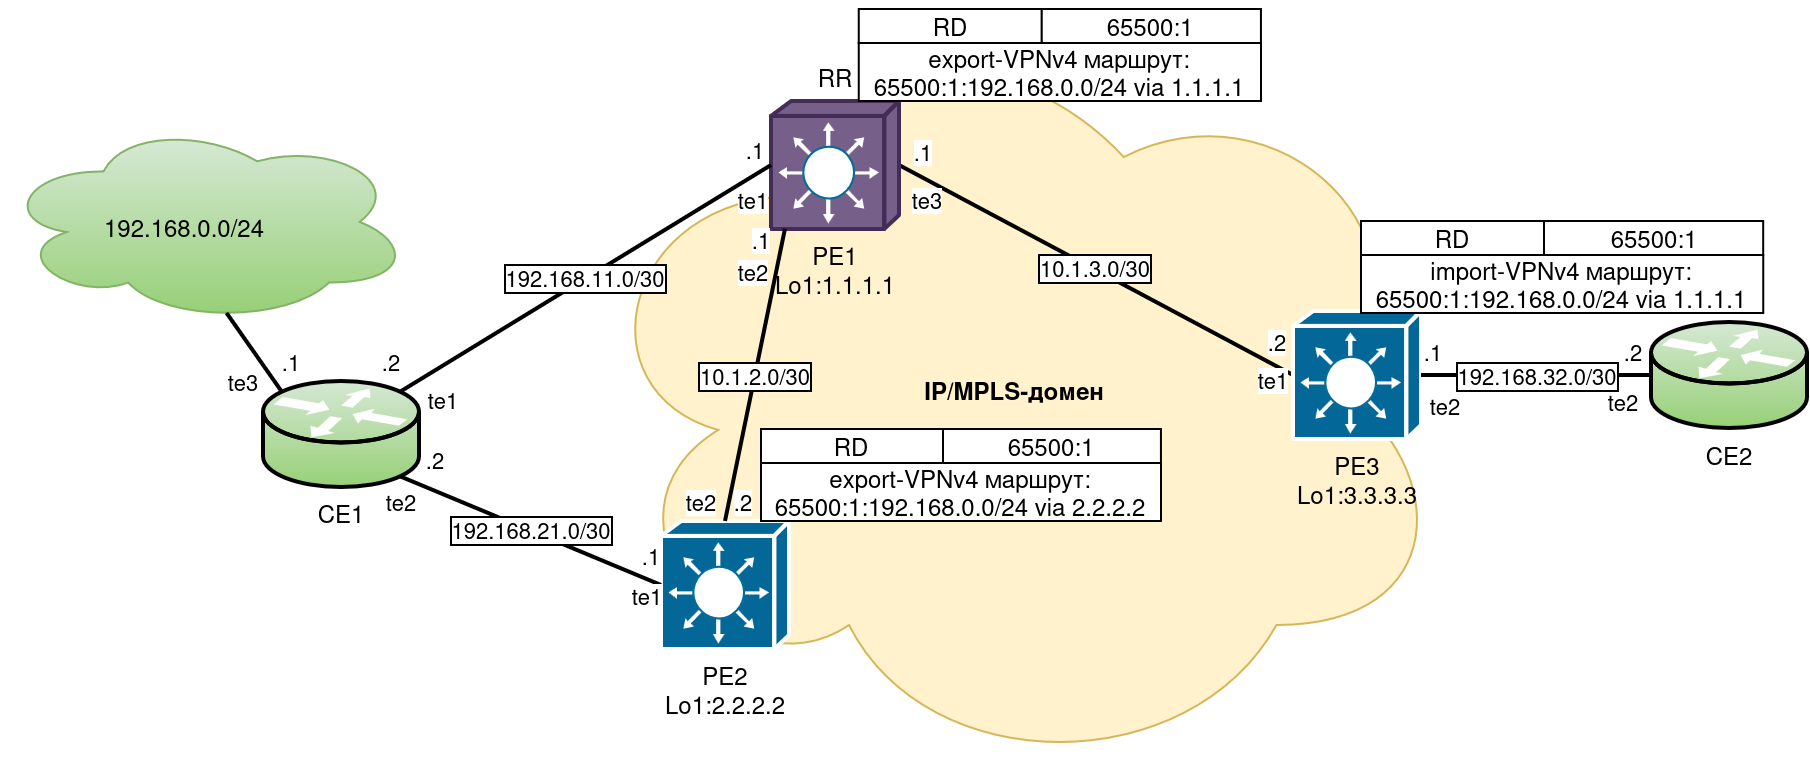
Если в VPN на PE1 и PE2 используется одинаковый разделитель маршрута (RD), то оба VPN-маршрута к IPv4-подсети 192.168.0.0/24 будут иметь один и тот же адрес назначения. В результате PE3 получит от PE1 только один VPN-маршрут к 192.168.0.0/24: CE1 → PE1 → PE3;
Если прямая связь между PE1 и CE1 выходит из строя, PE1 отправляет BGP-Update с Withdrawn-записью для 192.168.0.0/24 и PE3 удаляет VPN-маршрут. После этого необходимо установить другой VPN-маршрут к 192.168.0.0/24 для пересылки VPN-трафика по пути: CE2 → PE3 → PE1 → PE2 → CE1. На время установки нового VPN-маршрута пропуск трафика между CE2 и CE1 будет прерван.
Разный RD в схеме с dual-homing active-standby/active-active-резервированием для CE1:
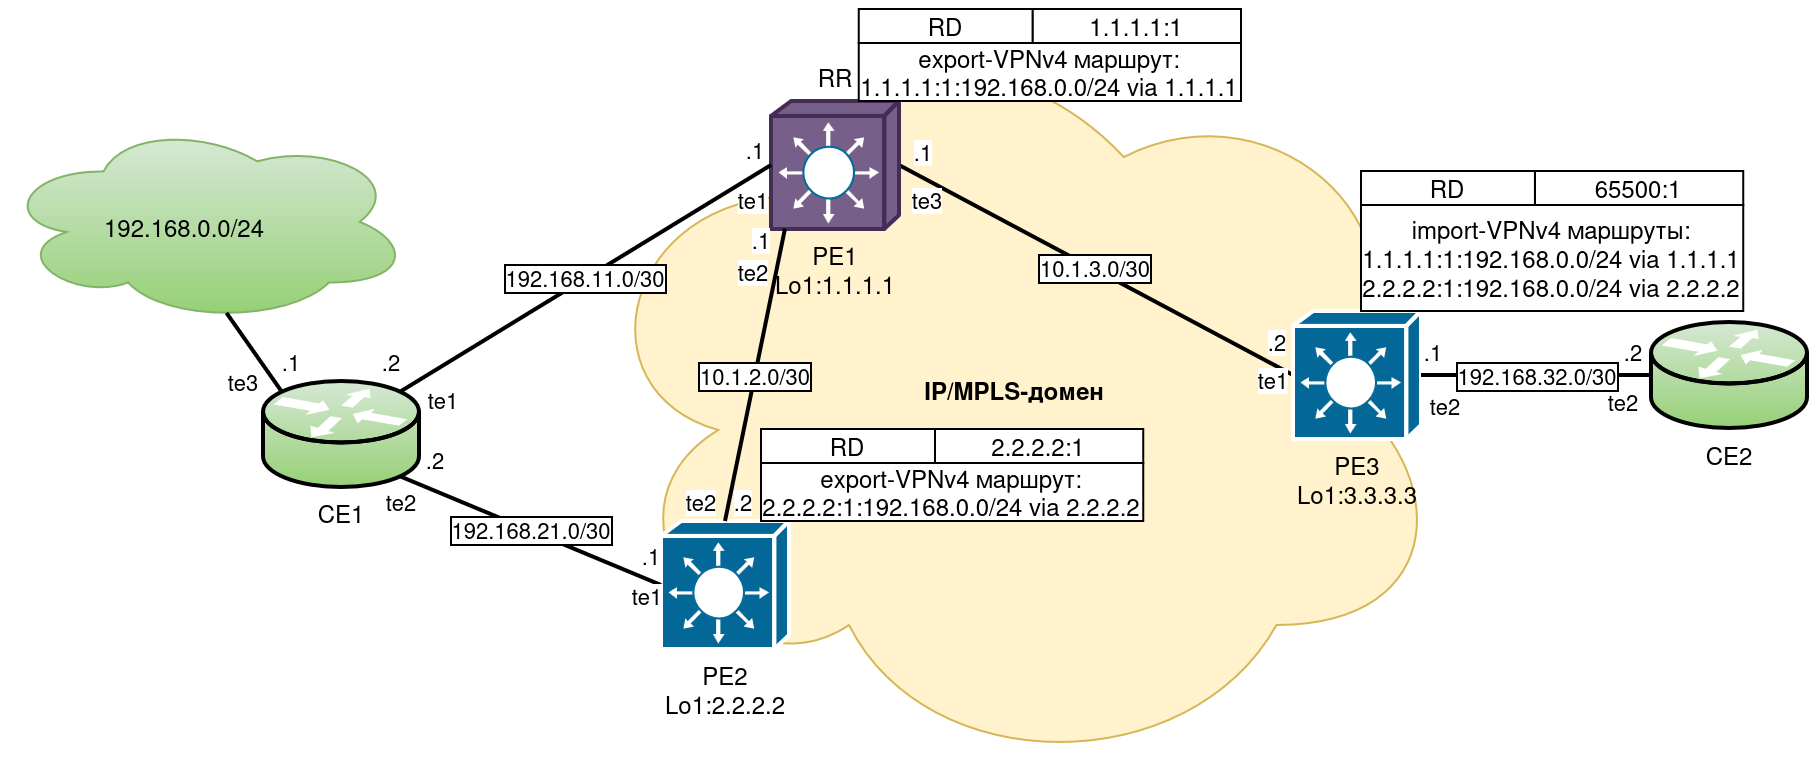
Если в VPN на PE1 и PE2 используются разные RD, то VPN-маршруты от каждого из PE к 192.168.0.0/24 будут иметь разные адреса назначения, следовательно, PE3 получает от PE1 два VPN-маршрута к 192.168.0.0/24 с разными RD. Когда любое соединение между PE1 или PE2 и CE1 выходит из строя, PE3 удаляет только соответствующий VPN-маршрут. Это сократит время переключения на альтернативный путь при передаче трафика между CE2 и CE1, предназначенного для 192.168.0.0/24 при режиме работы active-standby, при режиме работы active-active и использовании функциональности ECMP это позволит установить для маршрута два активных пути, при условии их равнозначности.
В текущей версии ПО не поддержана работа с dn-bit и domain-tag в OSPF. При использовании OSPF для взаимодействия между CE и PE-маршрутизаторами в dual-homing схемах во избежание зацикливания маршрутов через CE рекомендуется увеличение административной дистанции для OSPF Inter-AS маршрутов относительно BGP Intra-AS маршрутов в VRF на PE.
Route Target
RT — это 8-байтовый атрибут BGP Extended Communities, определяющий правила импорта и экспорта VPN-маршрутов между VRF на различных PE-маршрутизаторах. В отличие от RD, который обеспечивает уникальность маршрута, RT непосредственно управляет политикой распределения VPN-маршрутов: данное BGP Extended Communities определяет, какие VPN-маршруты будут установлены в конкретный VRF, и тем самым контролирует, какие сайты VPN могут обмениваться трафиком.
Существуют RT трех типов:
- Тип 0 + Administrator (2 байта, номер AS) + Assigned Number (4 байта), пример: 65500:100;
- Тип 1 + Administrator (4 байта, IP-адрес) + Assigned Number (2 байта), пример: 1.1.1.1:100;
- Тип 2 + Administrator (4 байта, 32-битный AS) + Assigned Number (2 байта), пример: 65500.65500:100.
Каждый VRF на PE-маршрутизаторе конфигурируется или двумя независимыми наборами RT, или одним RT для импорта и экспорта:
- route-target export — набор RT, который PE прикрепляет к VPN-маршрутам при экспорте из VRF в MP-BGP как атрибут BGP Extended Communities;
- route-target import — набор RT, по которым PE фильтрует получаемые из MP-BGP маршруты при импорте в конкретный VRF;
- route-target both — набор RT, который PE прикрепляет к VPN-маршрутам при экспорте из VRF в MP-BGP и по которому PE фильтрует получаемые из MP-BGP маршруты при импорте в конкретный VRF.
Один VRF и VPN-маршруты могут иметь множество RT. VPN-маршруты из VRF на PE-маршрутизаторе, экспортированные в MP-BGP с определёнными route-target export или route-target both, будут импортированы только в те VRF на других PE-маршрутизаторах, у которых будут присутствовать эти определенные RT в списке route-target import или route-target both. Если совпадений нет, маршрут в MP-BGP будет проигнорирован и не будет установлен ни в один VRF на других PE-маршрутизаторах.
При конфигурировании RT в контексте VRF на коммутаторах MES export/import и both — два ключа для одной команды route-target, export/import — разные значения одного ключа.
Ввод двух команд route-target export + route-target import с одним значением RT и команды route-target both не является эквивалентным действием, при последовательном применении команд первая введенная команда будет перезаписана последующей:
console(config-vrf)#route-target export 1:1
console(config-vrf)#route-target import 1:1
console(config-vrf)#do show running-config
ip vrf 1
route-target import 1:1
exit
Ключ export/import в команде route-target используется для настройки уникальных значений RT для правил импорта или экспорта VPN-маршрутов.
Ключ both в команде route-target используется для настройки одинакового значения RT для правил импорта и экспорта VPN-маршрутов.
В текущей версии ПО для одного VRF рекомендуется использовать не более 64 уникальных route-target.
Управление топологией VPN с помощью Route Target
Использование нескольких RT в одном VRF позволяет гибко комбинировать политики экспорта и импорта VPN-маршрутов и строить различные топологии связности между точками терминации VPN на PE — VPN-сайтами.
В BGP/MPLS L3 VPN, с помощью манипуляций импортом и экспортом Route Target, возможно построение множества вариантов топологий. Из них выделяют три базовые топологии.
Полносвязная топология (Full Mesh)
Диаграмма VPN-сервиса с полносвязной топологией:
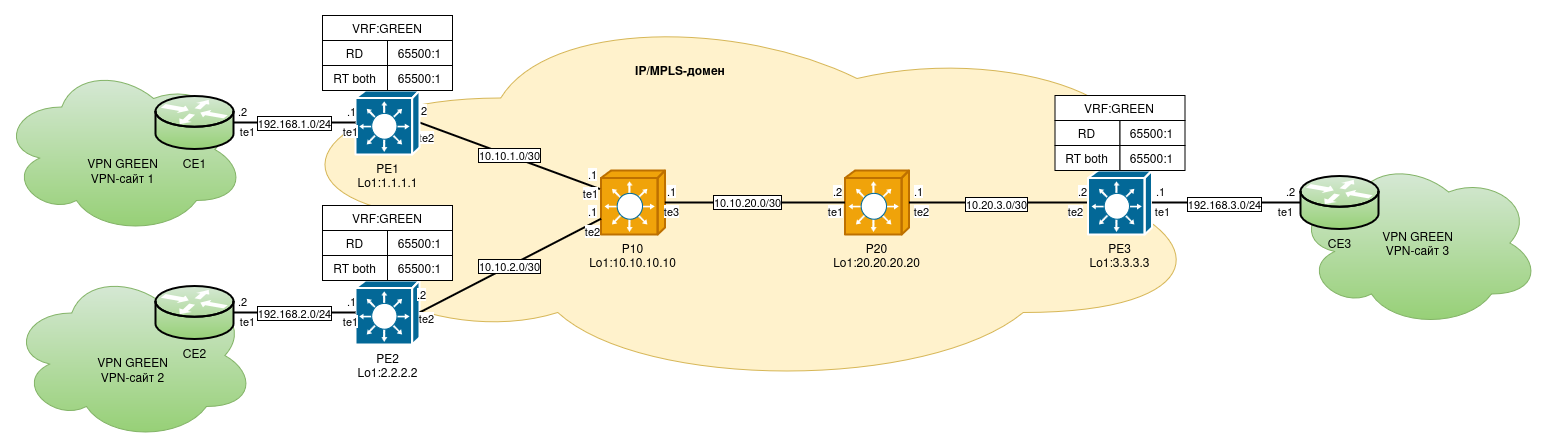
При полносвязной топологии все VRF всех VPN-сайтов используют один и тот же RT и для экспорта, и для импорта — route-target both 65500:1.
Любой сайт может обмениваться трафиком с любым другим сайтом напрямую:
Смешанная топология (Overlapping VPNs/Extranet)
При смешанной топологии возможна организация одновременного доступа нескольких VPN, каждый из которых со своим набором RT для импорта и экспорта, к общим ресурсам через общий VPN, имеющий оба набора RT.
Диаграмма VPN-сервиса со смешанной топологией:
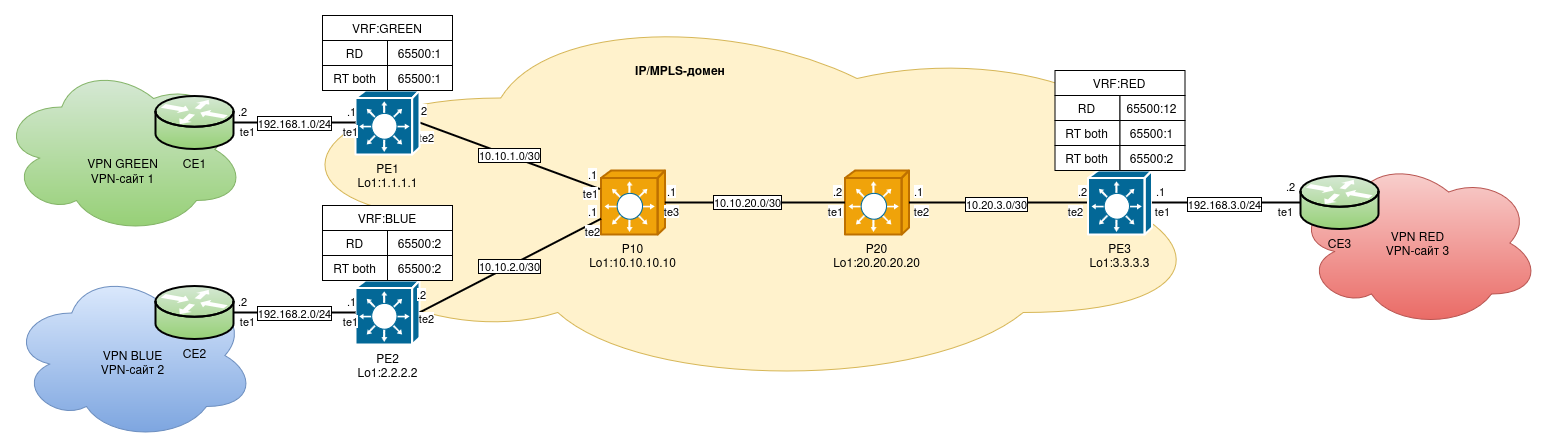
В данной смешанной топологии VRF VPN1 и VPN2 имеют разные наборы RT — route-target both 65500:1 и 65500:2, соответственно, а VRF VPN3 имеет оба набора RT:
PE3 может получать VPN-маршруты, анонсируемые PE1 и PE2.
PE1 и PE2 могут получать VPN-маршруты, анонсируемые PE3.
Таким образом, VPN-сайт 1 и VPN-сайт 3 могут обмениваться маршрутами и трафиком друг с другом, аналогичным образом — и VPN-сайт 2, и VPN-сайт 3.
При этом PE3 не передаёт VPN-маршруты, изученные от PE1 в сторону PE2, и не передаёт маршруты от PE2 в сторону PE1, следовательно, VPN-сайт 1 и VPN-сайт 2 не могут напрямую общаться друг с другом, так как обмен маршрутами между ними отсутствует.
Топология "звезда" (Hub and Spoke)
Топология Hub and Spoke используется при необходимости организации строгого пропуска трафика от SPOKE-CE — "лучей звезды", только через HUB-CE — "центр звезды". Spoke-сайт анонсирует свои маршруты HUB-сайту, а HUB-сайт, в свою очередь, передаёт эти маршруты другим SPOKE-сайтам. SPOKE-сайты не обмениваются маршрутами напрямую друг с другом. HUB-сайт полностью контролирует взаимодействие между всеми удалёнными сайтами.
Диаграмма VPN-сервиса с топологией "звезда":
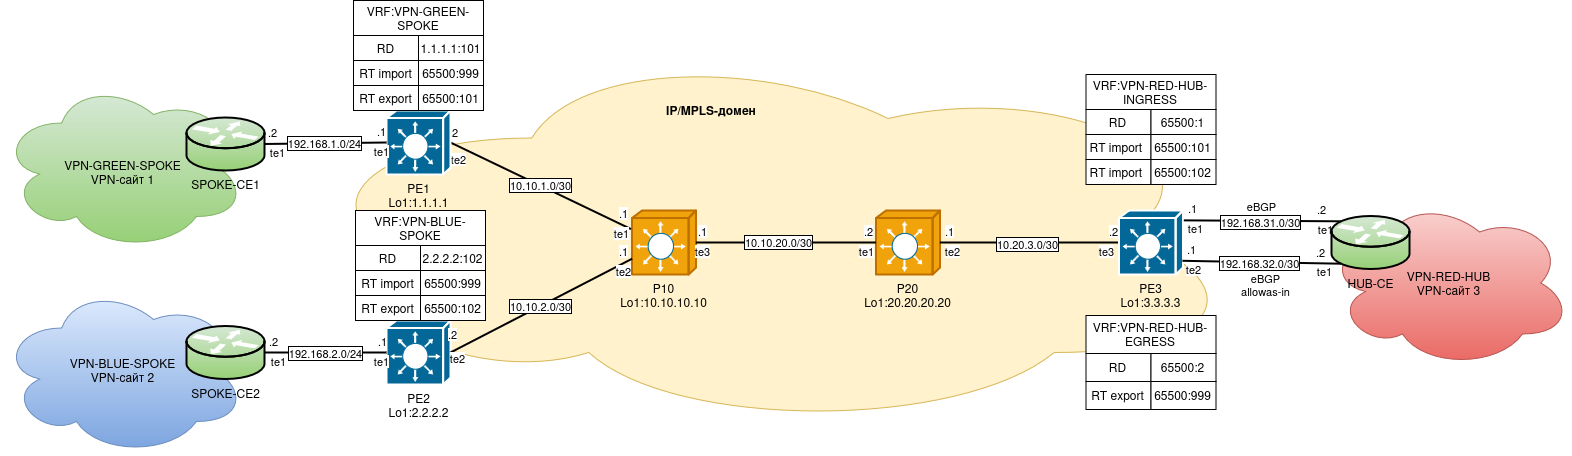
В топологии Hub and Spoke на PE3 (HUB-PE) потребуется использование двух VRF, которые служат для разделения потоков трафика, избегания зацикливания маршрутов и асимметрии трафика:
- VPN-RED-HUB-INGRESS для импорта VPN-маршрутов от SPOKE-сайтов (Upstream/Ingress);
- VPN-RED-HUB-EGRESS для экспорта VPN-маршрутов к SPOKE-сайтам (Downstream/Egress).
HUB-сайт использует один RT (HUB-RT) для экспорта в VRF VPN-RED-HUB-EGRESS для исходящего трафика в сторону SPOKE-сайтов и множество RT (SPOKE-RT) для импорта маршрутов от SPOKE в VRF VPN-RED-HUB-INGRESS. Каждый SPOKE-сайт использует свой RT для экспорта и HUB-RT для импорта. Это позволяет SPOKE-сайтам отправлять трафик только в HUB, а HUB — в любой SPOKE, при этом прямая связность между SPOKE-сайтами исключена.
Для реализации схемы обмена маршрутами между PE3 и HUB-CE необходимо использовать два отдельных интерфейса или саб-интерфейса для входящего и исходящего трафика в VPN.
Для большей гибкости рекомендуется использовать eBGP взаимодействие между PE3 и HUB-CE.
Для корректного перетекания через HUB-CE VPN-маршрутов от SPOKE между VRF VPN-RED-HUB-INGRESS и VPN-RED-HUB-EGRESS на HUB-PE потребуется использование опции allowas-in для eBGP соседства со стороны HUB-PE в VRF VPN-RED-HUB-EGRESS. Данная опция позволит HUB-PE принять обратно свои собственные маршруты, которые он отправил на HUB-CE в рамках eBGP соседства в VRF VPN-RED-HUB-INGRESS и которые HUB-CE возвращает обратно в рамках eBGP соседства с VRF VPN-RED-HUB-EGRESS. Без этой опции маршруты будут отброшены из-за обнаружения петли по AS_PATH.
Обмен маршрутной информацией в BGP/MPLS L3 VPN
В базовом сценарии применения BGP/MPLS L3 VPN анонсированием VPN-маршрутов занимаются PE-маршрутизаторы, RR-маршрутизатор при этом выполняет функции маршрутного отражателя и отвечает за обмен VPN-маршрутами между PE. RR-маршрутизатор может не выполнять функций по пропуску VPN-трафика, но строго не ограничен своей ролью и может являться P/PE-маршрутизатором.
CE-устройства находятся вне MPLS-домена и анонсируют свои IPv4-маршруты в соответствующие VRF на PE-маршрутизаторах. Взаимодействие PE- и CE-маршрутизаторов для анонса IPv4-unicast маршрутов может быть построено как с помощью статической маршрутизации, так и с помощью динамических протоколов: OSPF или eBGP. Независимо от того, какой протокол маршрутизации используется, маршруты, анонсируемые между CE и PE, являются стандартными IPv4-маршрутами. Таким образом, BGP/MPLS L3 VPN сеть является «прозрачной» L3 связностью для CE-маршрутизаторов и подключенных за ними хостов и IP-сетей.
P-маршрутизаторы должны поддерживать только маршруты транспортной плоскости Underlay-сети, не зная о VPN-маршрутах и выполняя функции передачи трафика по транспортным MPLS-меткам.
В классической реализации все VPN-маршруты поддерживаются на устройствах PE.
В текущей версии ПО поддержан только Per-VRF режим выделения сервисных MPLS-меток в MP-BGP.
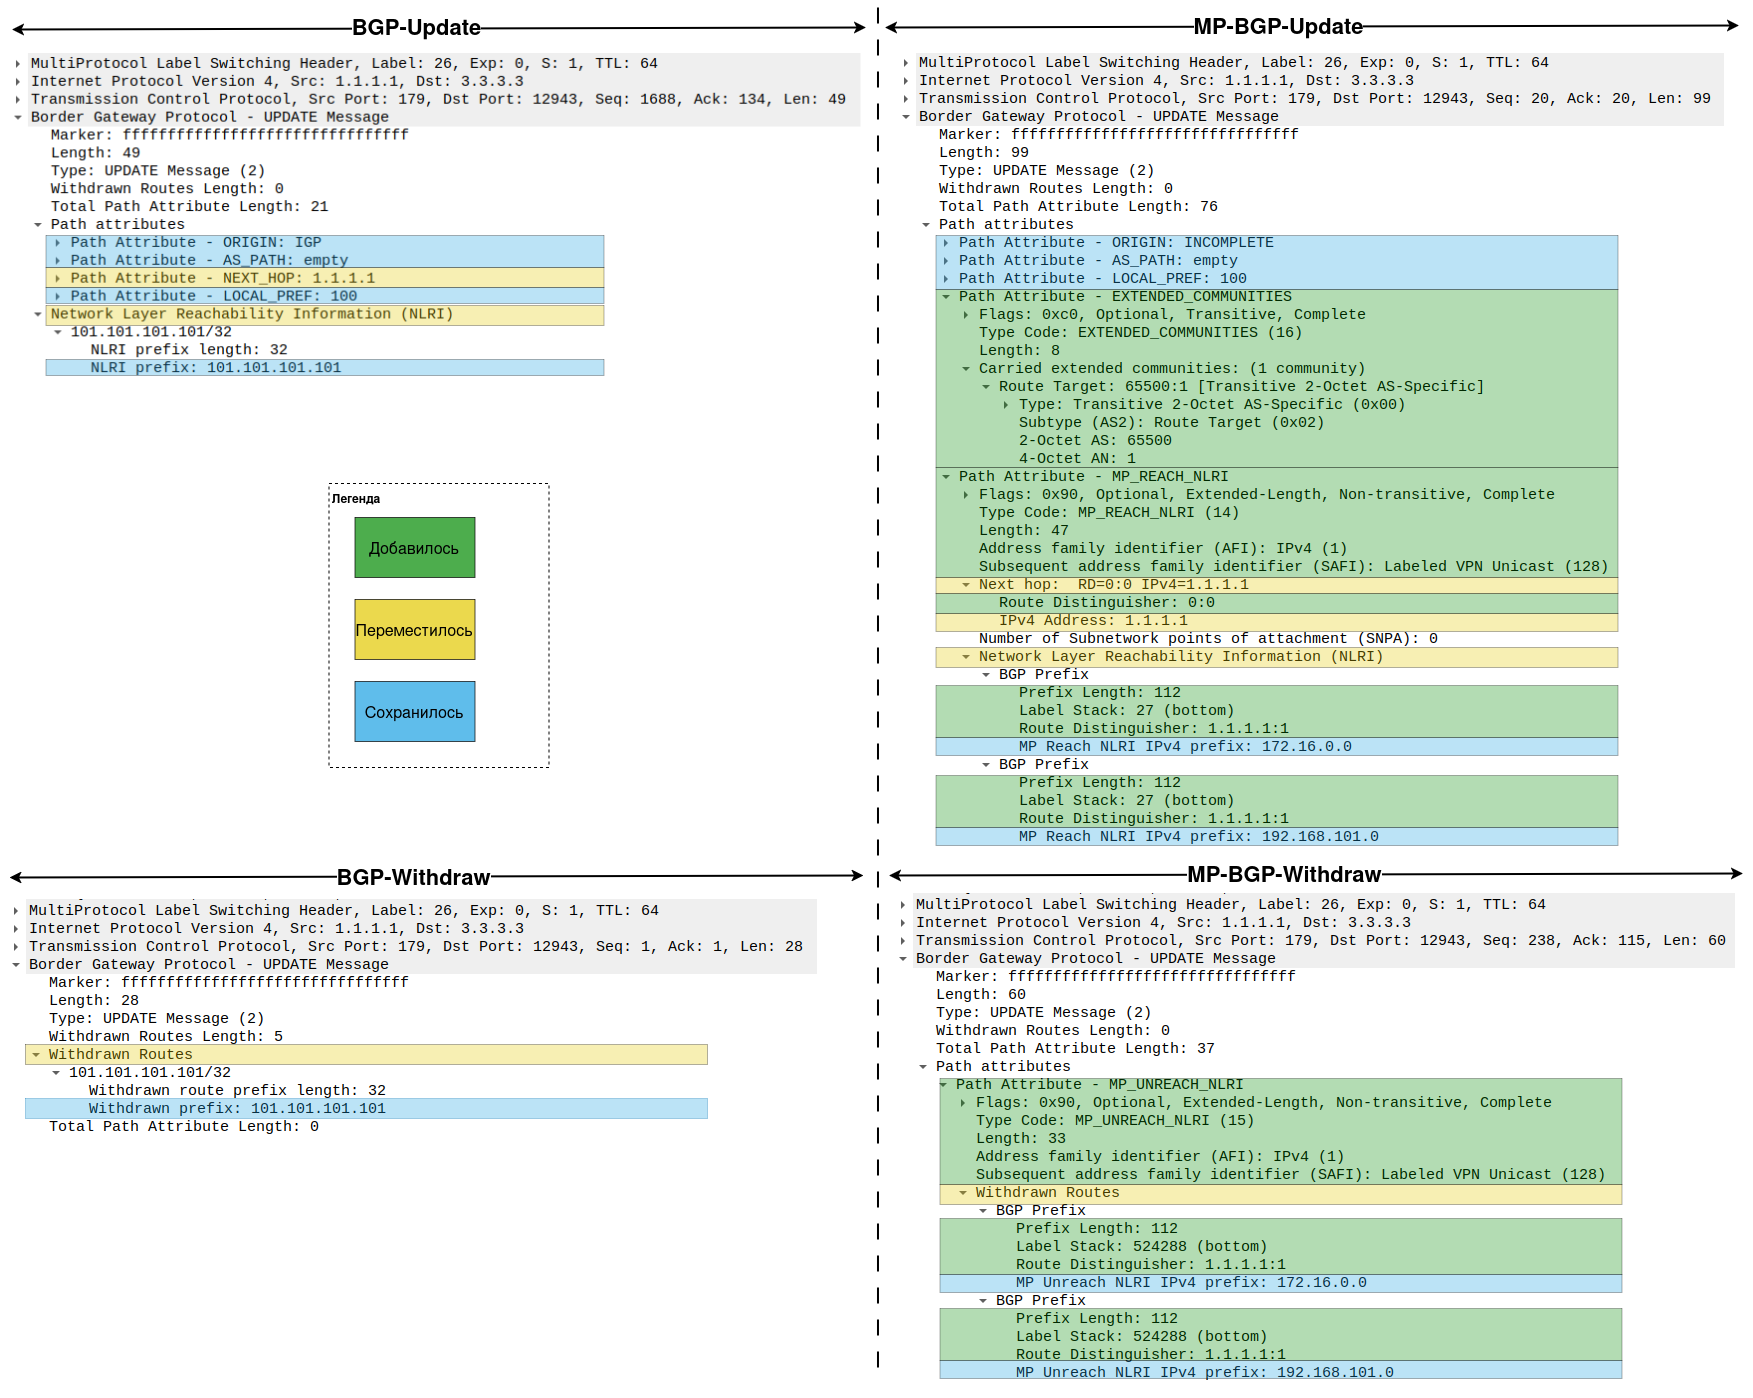
Для анонсирования VPNv4 Unicast-маршрутов MP-BGP использует свой формат BGP-Update-сообщений с расширенной логикой маршрутизации VPN-трафика.
В MP-BGP-Update-сообщениях отсутствуют поля NEXT_HOP и NLRI в классическом понимании, вместо них передается один специальный атрибут MP_REACH_NLRI, внутри которого передаются все данные о VPN-маршрутах и NextHop. MP_REACH_NLRI выступает контейнером для маршрутной информации и служит для объявления VPN-маршрутов другим PE.
MP_REACH_NLRI для VPNv4 Unicast адресов будет иметь следующую структуру:
- Идентификаторы семейства адресов (AFI/SAFI) — VPNv4 Unicast как AFI = 1 (IPv4), SAFI = 128 (MPLS-labeled VPN address), по ним принимающий BGP-пир будет классифицировать тип маршрутной информации;
- NextHop адрес (Network Address of Next Hop) — loopback-адрес PE (т. е. loopback-адрес PE-источника VPN-маршрутов) в формате VPNv4-адреса с RD=0:0;
- NLRI (Network Layer Reachability Information) — список анонсируемых VPN-маршрутов в формате VPNv4 (RD+IP-prefix) и информация о сервисной MPLS-метке для идентификации целевого VRF.
Также MP-BGP-Update-сообщение содержит атрибут Extended Communities с информацией об экспортных политиках (RT) для VPN-маршрутов, определяющих, в какие VRF на принимающем PE-роутере будет импортирован данный маршрут.
Для отзыва VPN-маршрутов используется специальный атрибут MP_UNREACH_NLRI, содержащий AFI/SAFI и список отзываемых VPNv4-префиксов. Принимающий PE-маршрутизатор, получив MP-BGP-Update с этим атрибутом, удаляет соответствующие маршруты из RIB BGP-таблицы и, как следствие, из FIB-таблицы VRF.
Диаграмма изменений состава BGP-Update-сообщений:
Базовый пример обмена информацией о VPN-маршрутах в BGP/MPLS L3 VPN-сети рассмотрен на диаграмме ниже
Диаграмма анонсирования маршрутов в BGP/MPLS L3 VPN:
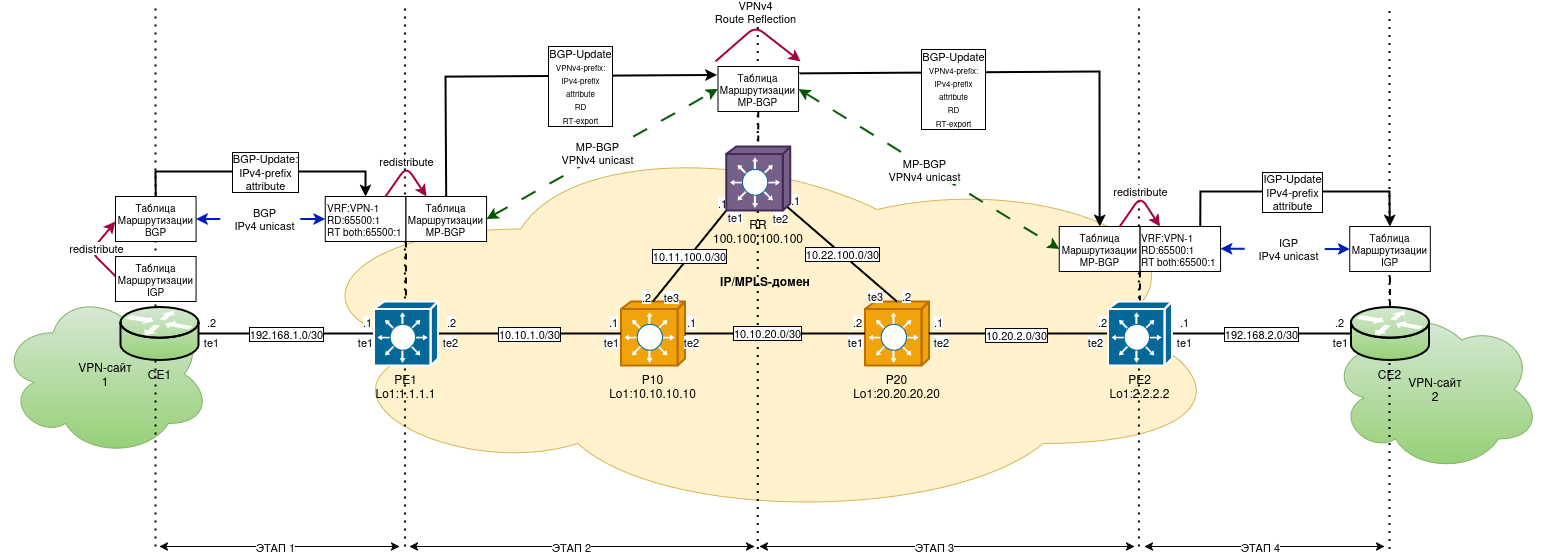
Состав стенда диаграммы:
- CE1 взаимодействует с PE1-маршрутизатором по eBGP;
- PE1 является точкой терминации VPN-сервиса для CE1 и преобразует IPv4 Unicast маршруты в VPNv4 Unicast для взаимодействия с PE2;
- P1 и P2 маршрутизаторы выполняют транспортные функции, не взаимодействуют с VPN-маршрутами;
- RR поддерживает обмен VPN-маршрутами между PE1 и PE2;
- PE2 выполняет функции, аналогичные PE1;
- CE2 взаимодействует с PE2-маршрутизатором по IGP протоколу.
ЭТАП 1
Маршруты VPN-сайта 1 на CE1 редистрибутируются в BGP AF IPv4 Unicast;
CE1 анонсирует маршруты PE1 при помощи eBGP-Update данными о IPv4-префиксах и атрибутами;
PE1 получает eBGP-Update от CE1 в определенный для VPN VRF и помещает запись в соответствующую RIB таблицу IPv4 Unicast данной VRF, после выполнения процедур фильтрации на основании заданных правил и атрибутов маршрут может быть установлен в FIB заданной VRF-таблицы;
PE1 преобразует IPv4 Unicast маршрут в VPNv4 Unicast-маршрут путем добавления ассоциированного с VRF RD к IPv4-префиксу и устанавливает его в RIB-таблицу маршрутизации MP-BGP.
ЭТАП 2
- PE1 выделяет сервисную MPLS-метку для VRF с уникальным RD. Эта MPLS-метка закрепляется за всеми VPNv4-маршрутами, импортируемыми из VRF-таблицы с соответствующим уникальным RD;
- PE1 формирует MP-BGP Update:
- Создает атрибут MP_REACH_NLRI, в котором передает информацию об используемых AFI SAFI и в качестве NextHop указывает свой loopback IPv4-адрес в формате VPNv4-префикса с RD=0:0;
- Внутри MP_REACH_NLRI создает NLRI с информацией о сервисной MPLS-метке, RD и IPv4-prefix VPN маршрута;
- Добавляет к MP-BGP Update атрибут BGP Extended Communities, содержащий все наборы route-target export и both для заданного VRF.
- PE1 отправляет сообщение MP-BGP Update RR-маршрутизатору в рамках установленного соседства;
- RR принимает MP-iBGP Update от PE1 и выполняет установку VPNv4-маршрута в RIB-таблицу MP-BGP.
ЭТАП 3
- RR передает MP-iBGP Update в сторону PE2;
- PE2 принимает MP-BGP Update от RR, выполняет установку VPNv4-маршрута в RIB-таблицу MP-BGP;
- PE2 проводит проверку на совпадение полученных в BGP Extended Communities значений route-target с имеющимися в конфигурации локальных VRF наборами route-target import и both, в случае наличия совпадений PE2 приступает к преобразованию VPNv4 Unicast маршрутов в IPv4 Unicast и установке этих маршрутов в соответствующие FIB-таблицы соответствующих VRF;
- Для установки в FIB-таблицы соответствующих VRF преобразованных IPv4 Unicast-маршрутов PE2 выполняет поиск (lookup) транспортного MPLS-туннеля до Nexthop импортируемого VPN-маршрута, в случае успешного lookup-а маршрут будет установлен в FIB, в случае неуспеха — проигнорирован до момента появления актуального транспортного MPLS-туннеля.
ЭТАП 4
Полученные по MP-BGP и преобразованные в IPv4 Unicast маршруты конкретной VRF, установленные в FIB, PE2 редистрибутирует в RIB IGP-протокола для взаимодействия с CE2;
PE2 анонсирует IPv4 Unicast-маршруты в сторону CE2 согласно настройкам IGP-протокола для взаимодействия;
- CE2, получив анонсы, устанавливает маршруты в RIB, также возможна установка в FIB CE2 и/или последующая редистрибуция согласно конфигурациям IGP VPN-сайта.
Аналогично будет распространена маршрутная информация от CE1 к CE2, таким образом, VPN-сайт 1 и VPN-сайт 2 получат достаточную и консистентную маршрутную информацию и смогут прозрачно взаимодействовать друг с другом по протоколу IP посредством L3 VPN.
Передача L3 VPN трафика и процесс коммутации пакетов по меткам
В базовых сценариях применения BGP/MPLS L3 VPN в рамках одной AS VPN-пакеты пересылаются с двумя метками:
Внешняя MPLS-метка (транспортная MPLS-метка): коммутируется на транспортной плоскости Underlay-сети IP/MPLS, идентифицирует LSP от одного PE-маршрутизатора до другого удалённого PE-маршрутизатора. Данный транспортный MPLS-туннель обеспечивает доставку VPN-пакетов до удаленных PE через этот LSP.
Внутренняя метка (сервисная MPLS-метка): используется при отправке VPN-пакетов до удалённого PE-маршрутизатора и идентифицирует конкретный L3 VPN, которому направляются VPN-пакеты. Удалённое устройство PE находит исходящий интерфейс для VPN-пакетов к CE-устройству конкретного L3 VPN на основании сервисной MPLS-метки.
Схема передачи L3 VPN-трафика и процесс коммутации пакетов по меткам:
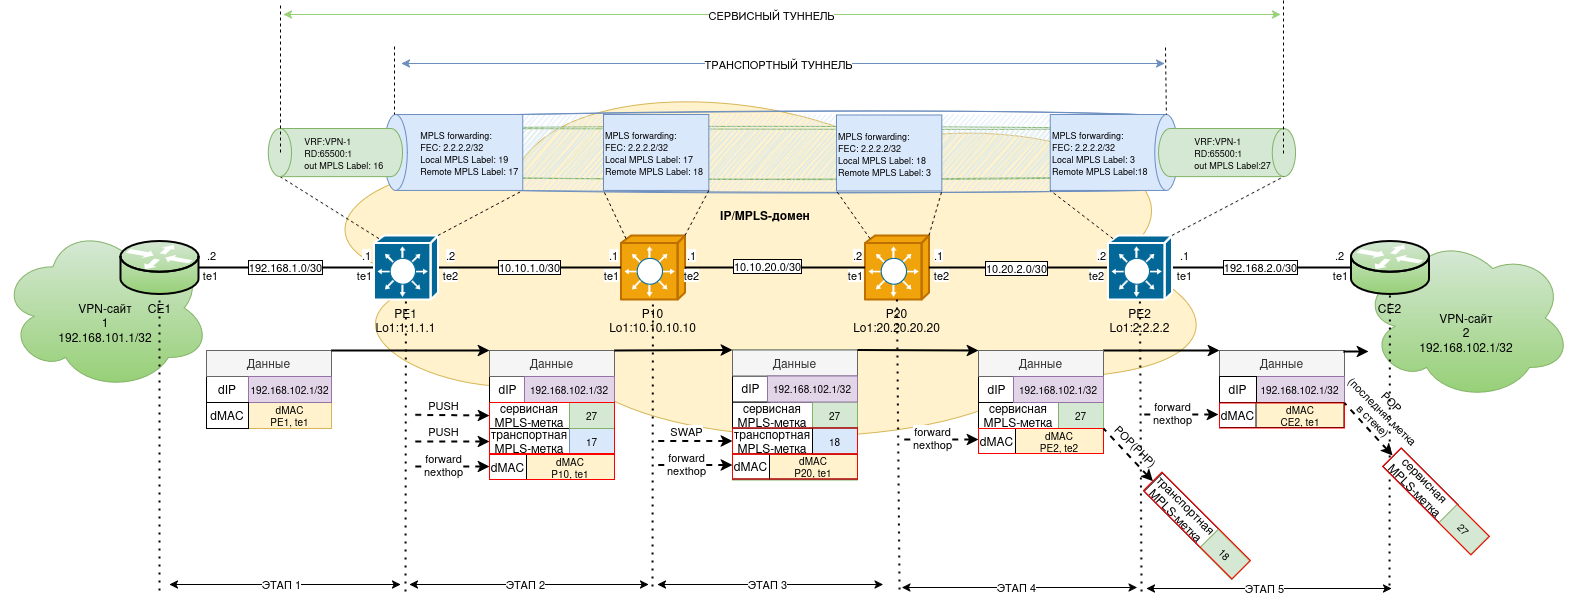
При поэтапном рассмотрении процесса коммутации IP-пакета по меткам в MPLS L3 VPN принято, что все протоколы плоскости управления и передачи данных сошлись и во всех таблицах имеется достаточная для передачи информация согласно представленной схеме, а на транспортной и сервисных плоскостях Underlay- и Overlay-сетей построены соответствующие MPLS-туннели. На каждом этапе коммутации маршрутизатор может идентифицировать только одну верхнюю MPLS-метку стека.
ЭТАП 1
- CE1 выполняет поиск по своей FIB-таблице и на основании LPM находит актуальный nexthop к PE1;
- CE1 выполняет поиск актуального dMAC и исходящего интерфейса по таблице ARP для nexthop к PE1;
- CE1 отправляет полностью сформированный IP-пакет к хосту назначения 192.168.102.1/32 VPN-сайта 2 в сторону PE1.
ЭТАП 2
- PE1 после получения IP-пакета на интерфейсе, привязанном к экземпляру VRF соответствующего VPN, выполняет следующие действия:
Добавляет к заголовкам IP-пакета сервисную MPLS-метку в соответствии с VRF и выполняет поиск соответствующего транспортного туннеля по LFIB для получения значения транспортной MPLS-метки;
Добавляет к заголовкам VPN-пакета транспортную MPLS-метку и сопоставляет транспортный туннель актуальному для него nexthop к следующему LSR для поиска актуального dMAC по таблице ARP;
- PE1 отправляет полностью сформированный MPLS-пакет в сторону P10.
ЭТАП 3
- P10 после получения MPLS-пакета от PE1 на основании значения транспортной MPLS-метки выполняет поиск по LFIB-таблице для определения необходимого действия коммутации MPLS-пакета к соответствующему FEC (2.2.2.2);
- P10 выполняет операцию swap, производит замену транспортной MPLS-метки на значение, полученное от следующего LSR в LSP, и сопоставляет LSP актуальному для него nexthop к следующему LSR для поиска актуального dMAC и исходящего интерфейса по таблице ARP;
- P10 отправляет полностью сформированный MPLS-пакет в сторону P20.
ЭТАП 4
- P20 после получения MPLS-пакета от P10 на основании значения транспортной MPLS-метки выполняет поиск по LFIB-таблице для определения необходимого действия коммутации MPLS-пакета к соответствующему FEC (2.2.2.2);
- P20 выполняет операцию pop и производит удаление транспортной MPLS-метки, т. к. является Penultimate-LSR и получил от нижестоящего LSR в LSP MPLS-метку 3 (Implicit NULL), затем сопоставляет LSP актуальному для него nexthop к следующему LSR для поиска актуального dMAC и исходящего интерфейса по таблице ARP;
- P20 отправляет полностью сформированный MPLS-пакет без транспортной MPLS-метки в сторону PE2.
ЭТАП 5
- PE2 после получения MPLS-пакета от P20 на основании значения сервисной MPLS-метки идентифицирует VRF назначения;
- PE2 на основании значения поля «S=1» в заголовке сервисной MPLS-метки выполняет удаление MPLS-заголовка, т. к. эта метка последняя в стеке;
- PE2 выполняет поиск nexthop для IPv4-адреса назначения на основании FIB-таблицы соответствующего VRF;
- PE2 выполняет поиск актуального dMAC и исходящего интерфейса по таблице ARP для nexthop к CE2;
- PE2 отправляет IP-пакет в сторону CE2;
- CE2 передает пакет адресату в соответствии с настройками IGP и общим процессом IP-маршрутизации.
Пакет успешно передан с CE1 на CE2 сквозь MPLS L3 VPN, структура MPLS-домена прозрачна как для CE-устройств, так и для прочих хостов соответствующих VPN-сайтов.
MTU в MPLS L3 VPN в процессе коммутации пакетов по меткам
При построении IP/MPLS и BGP/MPLS IP VPN-сетей необходимо учитывать возрастание размера пакетов за счет MPLS-инкапсуляции при продвижении VPN-пакета через MPLS-сеть.
В классической MPLS L3 VPN к пакету клиента добавляются как минимум:
Внутренняя метка (service label): 4 байта. Определяет, какому VPN (VRF) принадлежит пакет;
Внешняя метка (transport label): 4 байта. Используется для LSP транзитными маршрутизаторами.
Соответственно, в MPLS-домене можно выделить три основных вида MTU:
- L2 MTU — максимальный размер фрейма, включающий в себя Ethernet-заголовок (14B), заголовки верхних уровней и полезную нагрузку, но не включающий поле FCS (4B);
- MPLS MTU — максимальный размер пакета, включающий в себя все MPLS-заголовки (от 4B до 8B), заголовки верхних уровней и полезную нагрузку;
- IP MTU — максимальный размер пакета, включающий в себя IP-заголовок (20B), заголовки верхних уровней и полезную нагрузку.
В процессе передачи MPLS-пакет не подлежит фрагментации, поэтому необходимо обеспечить достаточный размер MTU на соответствующих участках передачи. Фрагментация «клиентского» IP-трафика от CE при инкапсуляции в MPLS-туннели также невозможна.
На коммутаторах MES возможно изменение следующих значений MTU в зависимости от типа трафика и его назначения:
- Default MTU — глобальное значение для транзитного коммутируемого трафика:
- Максимальный размер ethernet-фреймов (L2 MTU) для транзитных аппаратно-коммутируемых (bridged) unicast и multicast;
- Default protocol MTU — глобальное значение для принимаемых на CPU MES протоколов и транзитного IP MTU:
- Максимальный размер пакетов, формируемых и принимаемых на CPU протоколами 3 уровня и выше: IGMP, DHCP, RADIUS, TACACS+, протоколы динамической маршрутизации (глобально наследуется интерфейсами — port, vlan (SVI), Loopback при назначении на них IP-адреса);
- Максимальный размер пакетов, формируемых и принимаемых на CPU протоколами 2 уровня: LLDP, EAP, OAM на интерфейсах физических портов;
- Расчет аппаратных порогов для шейпинга трафика;
- Максимальный размер аппаратно-маршрутизируемых Unicast и Multicast IP-пакетов (IP MTU).
- Interface protocol MTU — локальное (per-Interface) значение для принимаемых на CPU MES протоколов:
- Максимальный размер пакетов, формируемых и принимаемых на CPU протоколами 3 уровня и выше: IGMP, DHCP, RADIUS, TACACS+, протоколы динамической маршрутизации (OSPF, BGP) для целевого интерфейса;
- Максимальный размер пакетов, формируемых и принимаемых на CPU протоколами 2 уровня: LLDP, EAP, OAM для целевого интерфейса.
Изменение значений Default MTU и Default protocol MTU возможно только глобально для всего коммутатора — с помощью команды изменения режима работы с Jumbo-фреймами. По умолчанию MES не поддерживает работу с Jumbo-фреймами Default MTU = 2048, а Default protocol MTU = 1500. После включения работы с Jumbo-фреймами Default MTU = 10240, а Default protocol MTU = 9000. Пример включения поддержки Jumbo-фреймов на MES описан в разделе "Настройки jumbo-frame и ECMP".
Значение Interface protocol MTU для всех интерфейсов автоматически наследуется от текущего значения Default protocol MTU и может быть изменено командой mtu <128-9000> в контексте конфигурации целевого интерфейса. Просмотр текущих значений Interface protocol MTU для списка интерфейсов возможен с помощью команды: show interfaces mtu.
Изменение Interface protocol MTU на интерфейсах устройства не приводит к изменению глобального значения Default protocol MTU и влияет только на работу протоколов плоскости управления. MTU в плоскости передачи данных может быть изменен только глобально, при включении/отключении поддержки работы с Jumbo-фреймами.
Базовая схема MPLS-инкапсуляции и возрастания MTU:
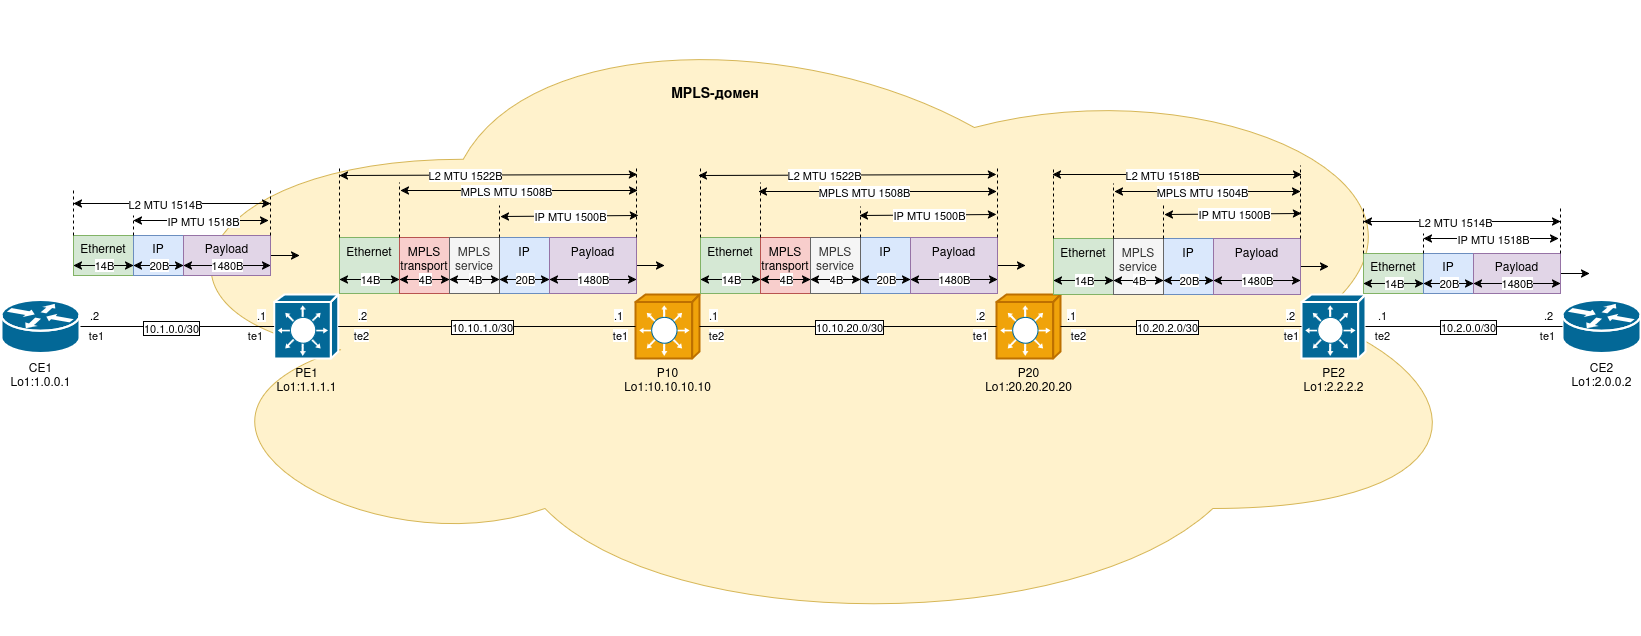
Коммутаторы MES могут выполнить маршрутизацию от/к CE и инкапсулировать/декапсулировать в MPLS IP-трафик, чей IP MTU не превышает текущего значения Default protocol MTU. Также возможен пропуск и коммутация MPLS-трафика через MPLS-домен, чей IP MTU не превышает текущего значения Default protocol MTU.
Рекомендуется учитывать ограничения реализации и использовать на CE-устройствах IP MTU, не превышающий минимального значения для всей схемы сети.
Для корректного установления соседства протоколов плоскости управления, требующих совпадения MTU на соседях, необходимо установить минимально возможный MTU для обоих соседей на интерфейсах соседства с помощью изменения Interface protocol MTU. Для OSPF возможно использование атрибута ip ospf mtu-ignore в контексте конфигурации IP-интерфейса соседства.
В текущей версии ПО изменение MPLS MTU глобально и на интерфейсах не поддержано, необходимо учитывать рекомендации руководства при настройке IP MTU на CE.
Рекомендуется включать поддержку Jumbo Frame на устройствах MPLS-домена.
Обработка TTL в процессе коммутации пакетов по меткам
Поле TTL в MPLS-заголовке имеет длину 8 бит и выполняет функции аналогично полю TTL в заголовке IP-пакета.
На коммутаторах Eltex реализован туннельный режим (Pipe mode) обработки TTL в MPLS-пакетах при их передаче, т. е. оригинальный IP TTL при прохождении пакетов через MPLS-домен уменьшается только на Ingress и Egress-LER.
Базовая схема режима обработки TTL при работе в Pipe mode:
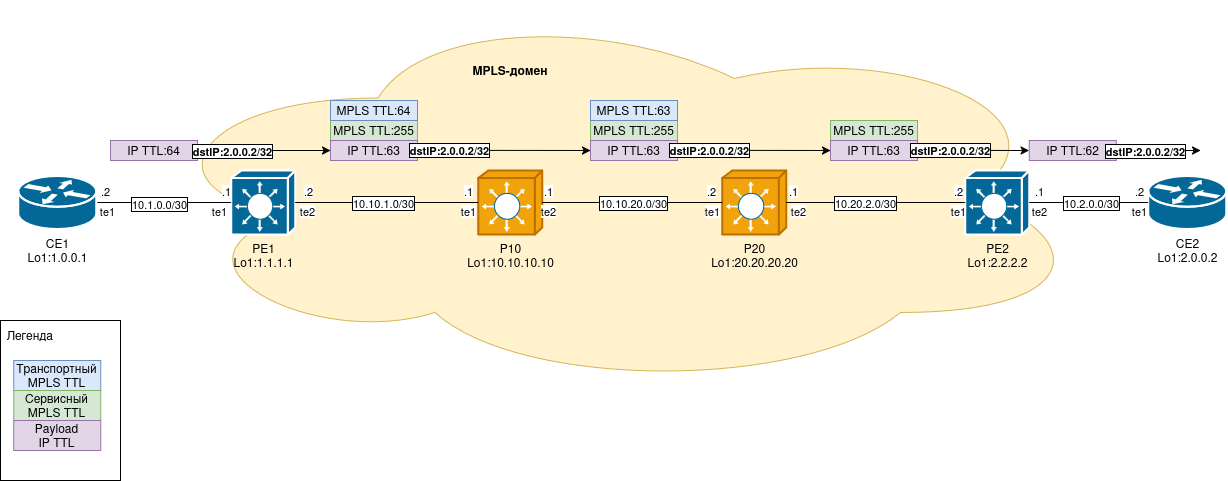
- Ingress-LER PE1 уменьшает IP TTL принятого IP-пакета на единицу перед коммутацией его по LSP через MPLS-домен, поле TTL выставляется в MPLS-заголовке перед передачей;
- Транзитные LSR P10 и P20 при пересылке пакета уменьшают MPLS TTL верхнего MPLS-заголовка стека на единицу, IP TTL не изменяется;
- Egress-LSR PE2 уменьшает IP TTL на единицу при передаче IP-пакета в IP-сеть назначения.
В текущей версии ПО поддержан только туннельный режим обработки TTL.
Проектирование архитектуры корпоративной сети на коммутаторах Eltex MES с использованием стека технологий MPLS L3 VPN
Проектирование архитектуры сети с использованием стека технологий MPLS L3 VPN позволяет объединить множество зданий, филиалов и удаленных кампусов в единую, безопасную и масштабируемую сеть.
Проектирование архитектуры сети рекомендуется разбить на этапы со строгим документированием результатов.
Ключевые этапы проектирования:
- Аудит и классификация:
- Определение всех групп пользователей и приложений, которые нуждаются в логической изоляции;
- Формирование и описание сервисной модели.
- Моделирование топологии сети и определение ролей устройств:
- Моделирование топологии — формирование карты узлов с учетом административного деления и группировки пользователей и планируемых сервисов, соединение узлов с учетом полосы пропускания, избыточности и резервирования путей;
- Планирование CE-узлов — выделение сегментов локальной сети и пограничных non-MPLS-устройств, что будут служить точкой входа в L3 VPN.
- Планирование PE-узлов — выделение ключевых узлов топологии и размещение на них маршрутизаторов границы MPLS-домена для терминации сервисов сегментов локальной сети и подключения ИТ-инфраструктуры;
- Планирование P-узлов — выделение транзитных узлов топологии с целью эффективного масштабирования соединений PE-маршрутизаторов;
- Выбор стека технологий для Underlay и Overlay-сетей:
- Подбор IGP-протокола для обеспечения базовой IP-связности между PE- и P-маршрутизаторами;
- Выбор Route Reflector MP-BGP-маршрутизаторов в сети;
- Планирование общих и согласованных политик маршрутизации для AS.
- Планирование механизмов высокой доступности:
- Подбор оптимальных параметров протокола BFD для различных типов связностей;
- Планирование избыточности связей и оптимальных параметров механизма ECMP.
- Сегментация сети с помощью VPN:
- Планирование отдельных VPN для каждого логического сегмента сети;
- Планирование топологии будущих L3 VPN-сервисов;
- Разработка единого плана IP-адресации для каждого VRF и схемы назначения идентификаторов RD и RT.
- Подбор оборудования и тестовое стендирование:
- Подбор оборудования для каждой роли устройств на основании сформированных потребностей в ресурсах;
- Подбор стека технологий и решений с учетом ограничений устройств и ПО.
- Пилотный запуск и масштабирование:
- Реализация пилотного проекта для двух-трех ключевых узлов в целях проверки всех сценариев маршрутизации и политик безопасности.
- Последовательное масштабирование по результатам тестового стендирования и пилотного запуска.
Результаты моделирования могут быть представлены в виде отдельных документов:
- HLD (High-Level Design) — высокоуровневый дизайн служит основой для общего понимания выбранной архитектуры, с упором на бизнес-требования;
- LLD (Low-Level Design) — низкоуровневый дизайн служит функциональной технической спецификацией и набором шаблонов конфигураций с детализацией, прямым руководством к действию для инженеров.
Сервисная модель
Сервисная модель — это комплексное абстрактное описание предоставляемых сетевых сервисов. Изначально операторский термин, позволяющий формализовать и стандартизировать описание услуг связи для оператора и клиента, но данный подход рационально заимствовать и для проработки сетевой архитектуры в корпоративной среде.
Использование подхода единой сервисной модели при проектировании новой или модернизации существующей сети позволяет выбрать оптимальную топологию сервисов, тип и схемы соединений non-MPLS-устройств с PE-устройствами на границе MPLS-домена, протоколы и механизмы при реализации того или иного сетевого сервиса.
Выделяют два вида сервисных моделей:
- Клиентская сервисная модель (Customer Service Model) — абстрактно описывает параметры сервиса, протоколы и механизмы с точки зрения клиента и не раскрывает внутреннее устройство сети оператора.
- Модель доставки услуги (Service Delivery Model) — описывает параметры сервиса, протоколы и механизмы организации сервиса с точки зрения оператора и конфигураций операторского оборудования.
В корпоративной среде возможно применение общей концепции построения сервисных моделей, но с незначительными корректировками ввиду отсутствия строгого деления зон ответственности клиент–оператор.
Предлагается следующая клиентская сервисная модель, под "клиентами" в данной модели понимаются CE-устройства и конечные хосты, т. е. non-MPLS-устройства VPN-сайтов. Видоизмененная модель состоит из нескольких абстрактных слоев:
- Слой базовых параметров сервиса (Service Identification) — описывает административные и адресные атрибуты сервиса:
- Идентификатор VPN-сервиса — уникальный номер или имя сервиса;
- Географическая адресная информация — конкретные физические адреса расположения оборудования;
- Количество VPN-сайтов.
- Слой структуры услуги (Service Functions) — описывает свойства сервиса с точки зрения VPN-сайтов:
- Уровень взаимодействия между устройствами VPN-сайтов — L3;
- Топология соединения VPN-сайтов — полносвязная, звезда, смешанная;
- Тип стыка CE–PE — L2, L3;
- Слой параметров производительности (Bandwidth & Performance) — описывает требования по полосе пропускания и параметрам качества обслуживания для сервиса:
- Полоса пропускания для сервиса;
- Параметры SLA — доступность, задержка, джиттер, потери.
- Слой интерфейсов и оборудования (UNI — User Network Interface) — описывает характеристики интерфейсов CE:
- Характеристики интерфейсов стыка CE и PE — тип интерфейсов: 1GE, 10GE, 25GE, 100GE, LAG, fiber/copper;
- L2-атрибуты линков, например режимы инкапсуляции и правила обработки меток (access, trunk, voice, native), значения vlan-id;
- L3-атрибуты линков — линковая IP-подсеть, directly connected IP-адрес.
Модель доставки услуги рассматривает задействованные стеки технологий и конфигурации устройств MPLS-домена, также видоизменена и разделена на несколько абстрактных слоев:
- Физический и канальный слой (Physical & Data-Link) — описывает характеристики интерфейсов MPLS-устройств:
- Идентификатор оборудования — hostname устройства;
- Идентификатор интерфейса — имена, индексы или иные идентификаторы интерфейсов устройств;
- Типы физических интерфейсов — FE, 1GE, 10GE, 25GE, 100GE, LAG, fiber/copper;
- Протокольный уровень используемого линка — L2, L3, MPLS;
- L1-атрибуты линков, например MTU;
- L2-атрибуты линков, например режимы инкапсуляции и правила обработки меток (access, trunk), значения vlan-id;
- L3-атрибуты линков — линковая IP-подсеть, directly connected IP-адрес.
- Сетевой топологический слой (Network Topology & Connectivity) — описывает используемые протоколы IP-Underlay сети и их параметры, атрибуты устанавливаемых соединений и свойства L3-топологии:
- Используемый IGP-протокол маршрутизации на IP-Underlay — OSPF, IS-IS;
- Типы и уровни сетевых соединений — OSPF-network (broadcast, NBMA, P2P, P2MP) или IS-IS-level (Level-1, Level-2, Level-1/2);
- Описание L3-топологии и маршрутных политик — зонирование, деление на уровни, маршрутные политики;
- Описание сопутствующих механизмов и протоколов оптимизации и защиты — выбор значений таймеров протоколов, использование BFD.
- Транспортный слой MPLS (Transport/MPLS Underlay) — описывает топологию, используемые протоколы и механизмы доставки трафика на MPLS-Underlay сети:
- Используемый протокол распространения информации о метках и построения LSP на MPLS-Underlay — LDP;
- Правила редистрибуции и фильтрации маршрутной информации, передаваемой протоколам распространения информации о метках для формирования FEC;
- Используемые диапазоны меток и их распределение по протоколам и плоскостям;
- Используемые режимы ассоциации, распространения и удержания меток в LDP.
- Сервисный слой MPLS (Service/MPLS Overlay) — описывает топологии, используемые протоколы и механизмы доставки VPN-трафика на MPLS Overlay-сети:
- Используемый Overlay-протокол и его атрибуты;
- Уровень VPN-сервиса — L3 VPN;
- Идентификаторы VRF и VPN-маршрутов — имя, выбор RD;
- Топология VPN-сервиса — выбор настроек import/export route-target в настройках VRF.
- Тип стыка PE–CE — L2, L3;
- Маршрутные политики на стыке с CE - import/export prefix-листы, манипуляции с Communities, анонс default-routes (0.0.0.0/0) или агрегация клиентских маршрутов в VPN;
- Слой высокой доступности и резервирования (High Availability/Resiliency) — описывает схему подключения, механизмы CE к PE с точки зрения отказоустойчивости, резервирования подключения к PE и взаимодействия CE между собой:
- Схема подключения к PE — single-homing (подключение к одному PE), dual-homing (подключение к двум PE);
- Режим передачи трафика при наличии резервирования — active-standby, active-active.
- Слой безопасности плоскости управления (Control Plane Security) — описывает требования к защите плоскости управления MPLS-домена:
- Аутентификация IGP-сессий (OSPF/IS-IS) между устройствами Underlay-сети;
- Ограничение области действия IGP-протоколов MPLS-домена только на интерфейсах Underlay-сети, passive-interface на прочих интерфейсах;
- Аутентификация MP-BGP-сессий между устройствами Overlay-сети;
- Ограничение объёма маршрутной информации, maximum-prefix для сессий для сессий PE–RR и импорта в VRF PE–CE;
- Единая ключевая политика домена, реестр ключей, ротация с применением механизмов key chain.
- Слой политик качества и безопасности (QoS & Security Policies) — описывает политики ограничения полосы, очередей, маркировки и перемаркировки трафика, фильтрации и механизмов контроля протоколов:
- Описание политик полисинга (ограничений полосы пропускания) для сервисов;
- Описание политик качества обслуживания (CoS/DSCP) для трафика;
- Политики фильтрации — описание конфигураций списков доступа (ACL);
- Описание применяемых механизмов сетевого контроля трафика на PE — storm-control, dhcp-snooping, arp-inspection, IPSG и т. п.
Клиентская сервисная модель отражает потребности и фиксирует требования к сетевым сервисам, которые необходимо предоставить с помощью той или иной архитектуры и стека протоколов, а также стыки с MPLS-сетью.
На основании клиентской сервисной модели формируется модель доставки услуг, выбирается топология и стек протоколов для сетевой архитектуры.
Общие рекомендации по планированию
Рекомендации для Underlay-сети:
- Учитывайте дополнительные MPLS-заголовки в MTU для каналов между MPLS-маршрутизаторами:
- Учитывайте невозможность фрагментации MPLS-пакетов.
Рекомендации по отказоустойчивости на транспортной и сервисной плоскостях:
- Разверните не менее двух Route Reflector в iBGP и объедините их в кластер — при отказе RR все PE потеряют возможность обмена VPN-маршрутами, необходимо резервирование данной роли;
- Используйте BFD на линковых интерфейсах Underlay-сети — субсекундное детектирование отказов линков, ускоренная сходимость транспортной плоскости;
- Планируйте ECMP-пути между PE для балансировки трафика и использования резервных линков;
- Планируйте разные значения salt/seed hash-функции для предотвращения поляризации трафика при каскадных соединениях устройств с ECMP;
- Учитывайте отсутствие LDP IGP Synchronization и кратковременные перерывы сервисов при перестроении L3-топологии из-за рассинхронизации IGP и LDP.
Рекомендации по масштабированию L3 VPN:
- Учитывайте ограничение количества RT на VRF;
- Учитывайте ограничение на число VRF на одном PE;
- Учитывайте ограничение на число маршрутов при больших таблицах и использовании ECMP.
Рекомендации по формированию адресного плана:
- Loopback-интерфейсы PE-/P-маршрутизаторов выделите в отдельный блок — они должны быть уникальны и стабильны, т. к. используются в качестве BGP/IGP Router-ID, nexthop для VPNv4 и FEC для LDP LSP;
- Для минимизации расхода адресного пространства используйте /30 (PTP) или /31 линковые подсети;
- Избегайте перекрытия VPN-префиксов с Underlay-префиксами. Хотя RD обеспечивает изоляцию маршрутов, пересекающиеся адреса затрудняют отладку и повышают риск ошибок конфигурации;
- Учитывайте возможное перекрытие IP-префиксов между разными VPN при отладке.
Рекомендации по защите плоскости управления:
- Устанавливайте лимит объёма маршрутов (maximum-prefix)На PE и RR-маршрутизаторах для каждого направления распространения маршрутной информации (PE-RR, PE-CE);
- Используйте единую политику для аутентификации сессий каждого протокола в домене (IGP-протоколов в Underlay-сети, MP-BGP в Overlay-сети, протоколов маршрутизации между PE и СЕ);
- Рекомендуется использовать цепочки ключей с периодами действия (key chain), что требует синхронизации времени на устройствах MPLS-домена;
- Учитывайте перекрытие по времени при ротации ключей, в момент замены должно одновременно действовать не менее двух активных ключей (старый и новый), смена ключей должна выполняться согласованно по всему MPLS-домену;
- Ведите реестр ключей в табличном виде для исключения коллизий при росте числа устройств и протоколов в MPLS-домене.
Рекомендации по формированию и планированию RD:
- Для AS < 65536 используйте RD Тип 0 (AS:VPN-ID), для упрощения отладки;
- В схемах dual-homing используйте уникальные RD типа 1 (IP-адрес:VPN-ID);
- Ведите реестр RD в табличном виде для исключения коллизий при росте числа VPN.
Рекомендации по формированию и планированию RT:
- Используйте единый формат RT для всей сети, согласованный с форматом RD, в целях минимизации ошибок при конфигурировании и упрощения аудита;
- Для полносвязной VPN-топологии используйте route-target both с одним значением RT для упрощения конфигурации;
- Для смешанных VPN-топологий и топологии «звезда» используйте раздельные import/export RT;
- Планируйте RT с учетом перспективы смешанных топологий, если в будущем потребуется частичная связность между VPN — заранее зарезервируйте RT-пространство.
Выбор salt и seed для исключения поляризации потоков в ECMP:
- Смена salt/seed на устройстве — глобальная операция и действует одновременно на ECMP и LAG;
- Смена salt/seed на LSR перестраивает маршрутизацию всех его потоков, в том числе транзитных;
- Задавайте индивидуальные salt и seed на каждом LSR с каскадным включением;
- Выводите значения из router-id по единой для домена формуле, для сохранения уникальности значений;
- Используйте значение router-id целиком, не "усекайте" его до части октетов;
- Объем одного потока не должен превышать ёмкости одного пути;
- Фиксируйте единую формулу и выбранные значения в проектной документации.
Настройка таймеров и интервалов BFD:
При выборе параметров BFD, особенно между географически разнесенными узлами, в целях минимизации ложных срабатываний протокола или срабатываний при единичных потерях пакетов, необходимо учитывать следующие факторы:
- Длину линии;
- Среднюю круговую задержку (RTT);
- Наличие джиттера;
- Надежность передачи и класс обслуживания.
Для минимизации рисков ложных и необоснованных детекций отказов BFD рекомендуется, чтобы минимальное безопасное время обнаружения отказа в несколько раз превышало максимальную RTT на канале.
Предлагаются следующие значения в зависимости от географической дистанции:
| Тип соединения | Минимальный рекомендуемый интервал (min-tx/rx), мс | Множитель (multiplier) | Итоговое время обнаружения отказа, мс |
|---|---|---|---|
| В пределах одного объекта/кампуса (intra-site/intra-campus) | 50/50 | 3 | 150 |
| В пределах одного города (Intra-metro) | 50/50 | 5 | 250 |
| В пределах одного региона (Intra-region) | 250/250 | 3 | 750 |
| Межрегиональные (Inter-region) | 250/250 | 5 | 1250 |
Рекомендуется использовать одинаковые значения интервалов и множителей на обеих сторонах BFD-сессии.
Пример сервисной модели сети на коммутаторах Eltex MES с использованием стека технологий MPLS L3 VPN
Пример схемы сервисного слоя модели доставки услуг для сети с четырьмя L3 VPN с полносвязной топологией, single-homing-включением клиентов на уровне доступа и dual-homing-включением сервисов на уровне ядра:
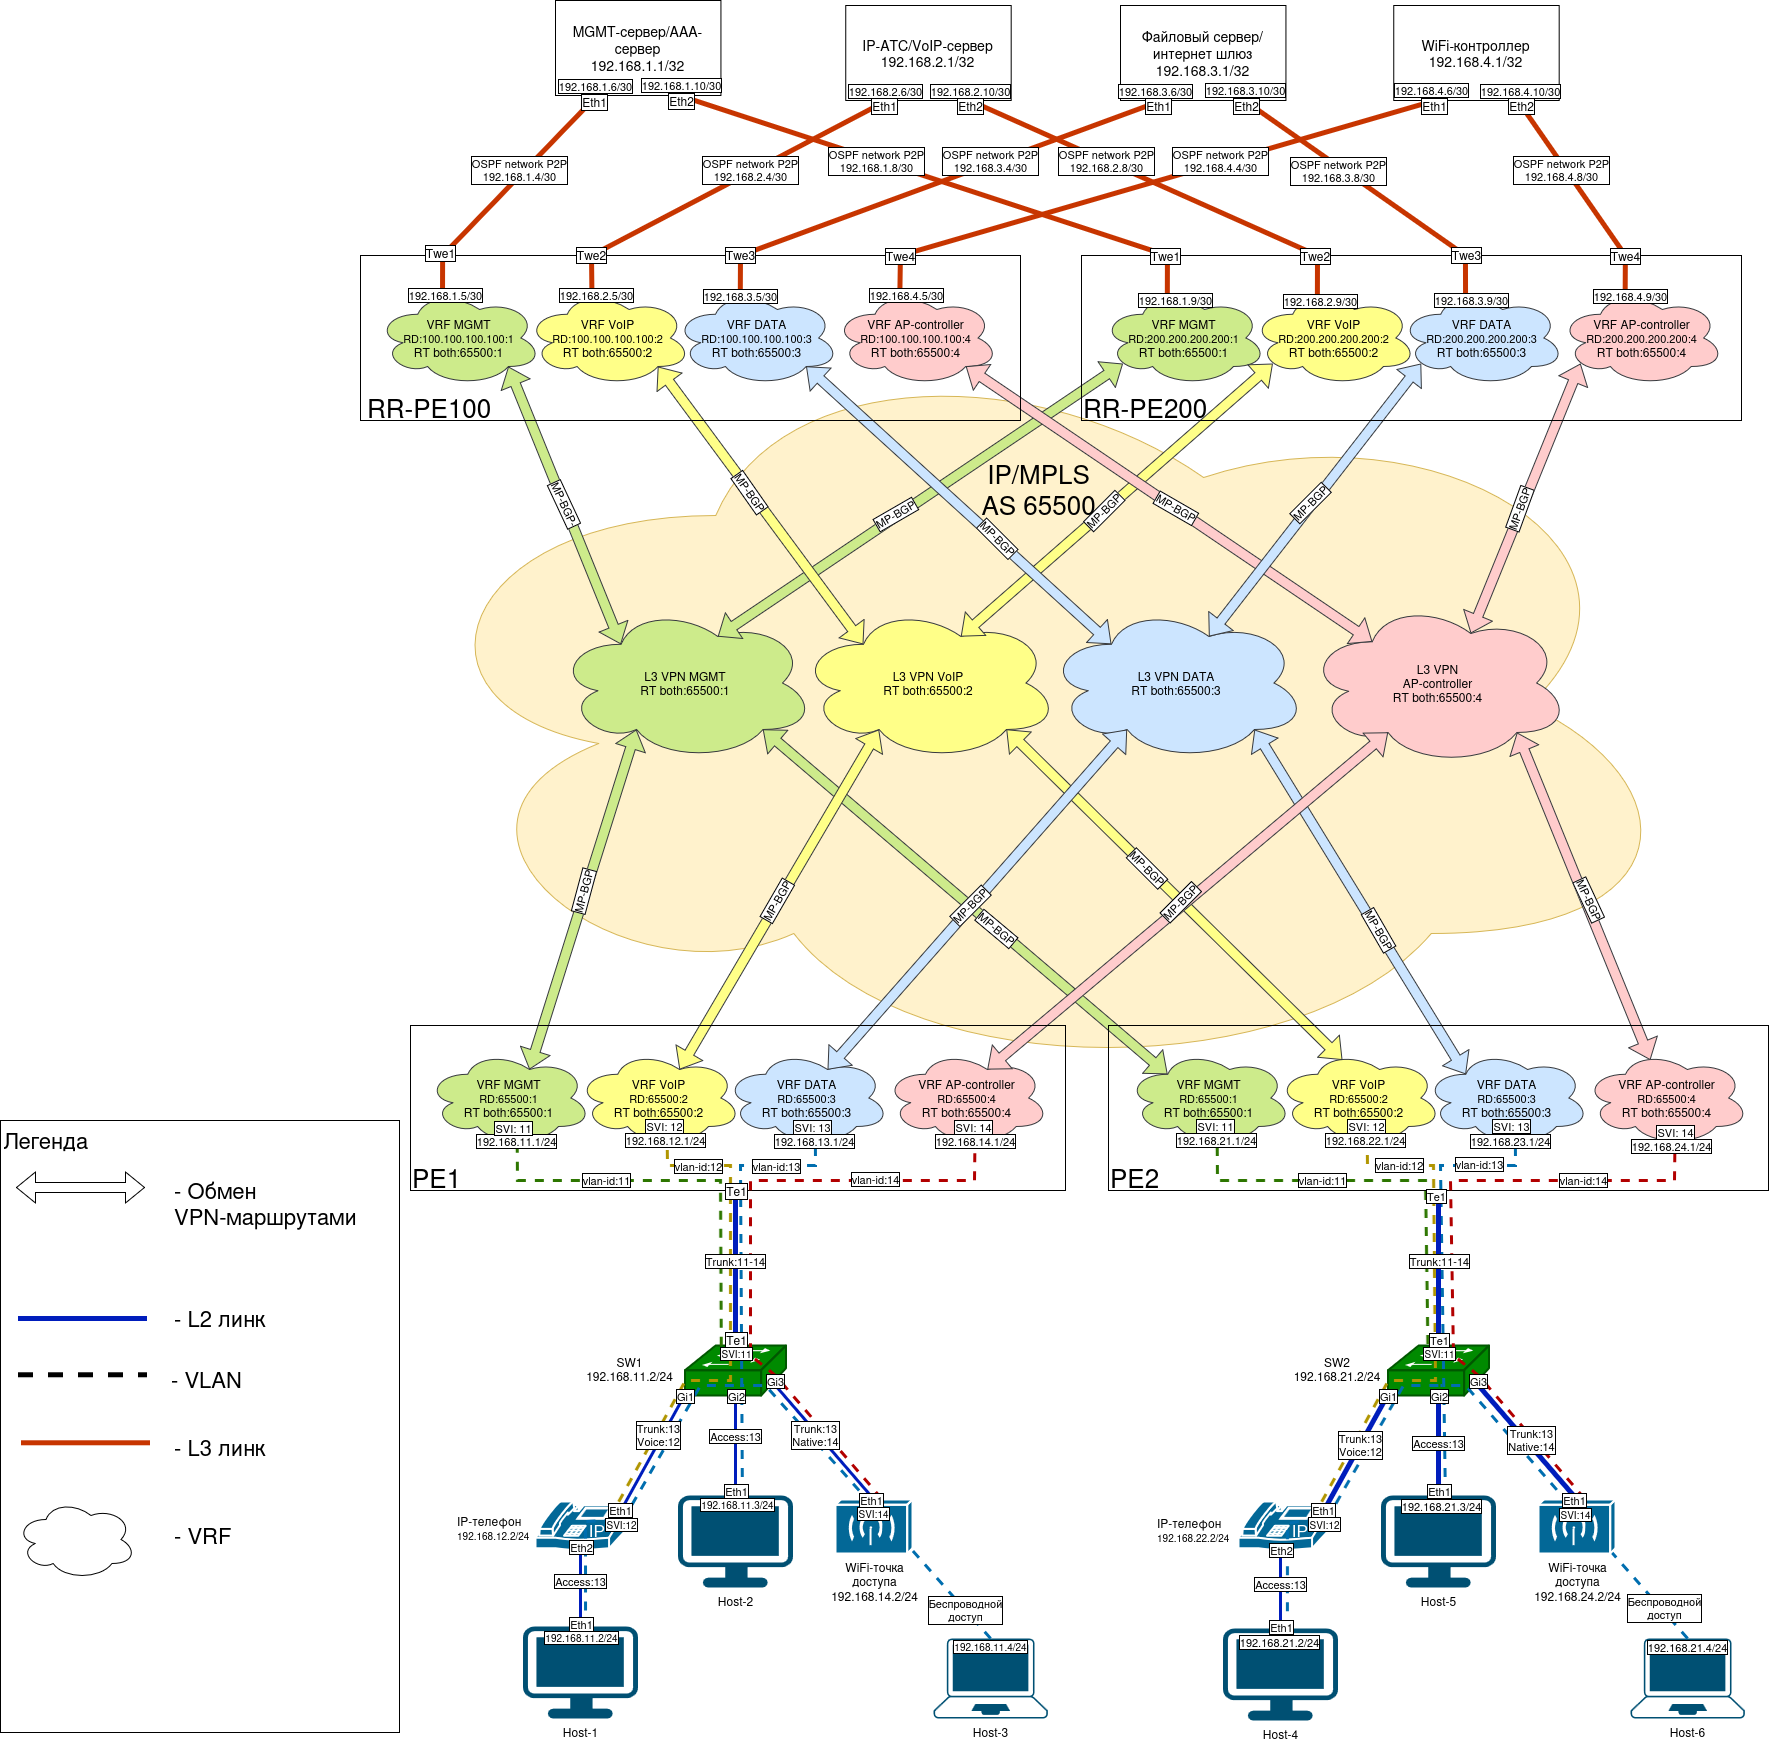
Пример сервисного слоя модели упрощен исходя из принципа наглядности для пояснения конфигурации L3 VPN-сервисов на PE-коммутаторах. Использование сервисной модели не является обязательной рекомендацией по планированию или архитектурным ограничением.
В рассматриваемой сервисной модели предполагается предоставление двух пользовательских и двух служебных сервисов:
- Общих сетевых ресурсов и доступа в Интернет;
- IP-телефонии;
- Изолированной сети управления устройствами;
- Изолированной сети управления точками доступа Wi-Fi.
Возможна поддержка функциональности DHCP-сервера на уровне серверов ядра, но она потребует наличие функциональности DHCP relay на PE-маршрутизаторах уровня агрегации доступа.
Со стороны ядра реализуется dual-homing-включение в PE для целевых серверов посредством L3-линков и протокола OSPF, что обеспечивает резервирование сервиса со стороны ядра.
Уровень доступа является классической L2-сетью с изоляцией трафика по VLAN и подключается к PE по схеме single-homing.
Схемой предполагается, что PE-коммутаторы будут иметь Loopback-интерфейсы в MGMT-VPN, в т. ч. для управления и реализации AAA-функций.
На L2-коммутаторах уровня доступа, в рамках сервисной модели, рекомендуется использование следующих функций:
- IP-интерфейса во VLAN управления для организации удаленного доступа по SSH, SNMP, для работы AAA-протоколов, протоколов синхронизации времени и передачи syslog-сообщений;
- Dot1x для аутентификации устройств в сети;
- Voice-vlan для vlan-маппинга IP-телефонов в свой сегмент сети по OUI;
- DHCP-snooping в сервисных VLAN с использованием DHCP;
- Изоляции на уровне портов для исключения взаимодействия клиентов в пределах одной VLAN.
IP-адресация, интерфейсы и атрибуты маршрутов используются в качестве примера, значения выбраны исходя из принципа наглядности и не являются рекомендацией по планированию сети.
Пример адресного плана и распределение идентификаторов, атрибутов, VLAN и интерфейсов:
| Хост | VRF name | RD | RT | Интерфейс | VLAN | IP-интерфейс |
|---|---|---|---|---|---|---|
| RR-PE100 | MGMT | 100.100.100.100:1 | import 65500:1 | Loopback 11 | - | 101.101.101.101/32 |
| export 65500:1 | Twe1/0/1 | - | 192.168.1.5/30 | |||
| VoIP | 100.100.100.100:2 | import 65500:2 | Loopback 12 | - | 102.102.102.102/32 | |
| export 65500:2 | Twe1/0/2 | - | 192.168.2.5/30 | |||
| DATA | 100.100.100.100:3 | import 65500:3 | Loopback 13 | - | 103.103.103.103/32 | |
| export 65500:3 | Twe1/0/3 | - | 192.168.3.5/30 | |||
| AP-controller | 100.100.100.100:4 | import 65500:4 | Loopback 14 | - | 104.104.104.104/32 | |
| export 65500:4 | Twe1/0/4 | - | 192.168.4.5/30 | |||
| RR-PE200 | MGMT | 200.200.200.200:1 | import 65500:1 | Loopback 11 | - | 201.201.201.201/32 |
| export 65500:1 | Twe1/0/1 | - | 192.168.1.9/30 | |||
| VoIP | 200.200.200.200:2 | import 65500:2 | Loopback 12 | - | 202.202.202.202/32 | |
| export 65500:2 | Twe1/0/2 | - | 192.168.2.9/30 | |||
| DATA | 200.200.200.200:3 | import 65500:3 | Loopback 13 | - | 203.203.203.203/32 | |
| export 65500:3 | Twe1/0/3 | - | 192.168.3.9/30 | |||
| AP-controller | 200.200.200.200:4 | import 65500:4 | Loopback 14 | - | 204.204.204.204/32 | |
| export 65500:4 | Twe1/0/4 | - | 192.168.4.9/30 | |||
| PE1 | MGMT | 65500:1 | import 65500:1 | Loopback 11 | - | 11.11.11.11/32 |
| export 65500:1 | Te1/0/1 | 11 | 192.168.11.1/24 | |||
| VoIP | 65500:2 | import 65500:2 | Loopback 12 | - | 12.12.12.12/32 | |
| export 65500:2 | Te1/0/1 | 12 | 192.168.12.1/24 | |||
| DATA | 65500:3 | import 65500:3 | Loopback 13 | - | 13.13.13.13/32 | |
| export 65500:3 | Te1/0/1 | 13 | 192.168.13.1/24 | |||
| AP-controller | 65500:4 | import 65500:4 | Loopback 14 | - | 14.14.14.14/32 | |
| export 65500:4 | Te1/0/1 | 14 | 192.168.14.1/24 | |||
| PE2 | MGMT | 65500:1 | import 65500:1 | Loopback 11 | - | 21.21.21.21/32 |
| export 65500:1 | Te1/0/1 | 11 | 192.168.21.1/24 | |||
| VoIP | 65500:2 | import 65500:2 | Loopback 12 | - | 22.22.22.22/32 | |
| export 65500:2 | Te1/0/1 | 12 | 192.168.22.1/24 | |||
| DATA | 65500:3 | import 65500:3 | Loopback 13 | - | 23.23.23.23/32 | |
| export 65500:3 | Te1/0/1 | 13 | 192.168.23.1/24 | |||
| AP-controller | 65500:4 | import 65500:4 | Loopback 14 | - | 24.24.24.24/32 | |
| export 65500:4 | Te1/0/1 | 14 | 192.168.24.1/24 |
Предлагаемая архитектура корпоративной сети на коммутаторах Eltex MES с использованием стека технологий MPLS L3 VPN
Предлагаемое решение представляет собой вертикальную четырехуровневую архитектуру, служащую для надежной передачи вертикального и горизонтального трафика и предоставления доступа клиентов к общим сетевым сервисам, а также обмена между собой.
Архитектура состоит из следующих уровней:
- Уровень ядра — коммутаторы с PE-ролью, служат для подключения сетевых сервисов к L3 VPN;
- Уровень дистрибуции — коммутаторы с P-ролью, служат для масштабирования подключений нижестоящих уровней к ядру;
- Уровень агрегации сервисов — коммутаторы с PE-ролью, служат для терминации L3 VPN для уровня доступа;
- Уровень доступа — L2 или L3 сеть доступа для подключения конечных потребителей к L3 VPN.
Архитектура участка сети на коммутаторах Eltex с использованием функциональности MPLS L3 VPN:
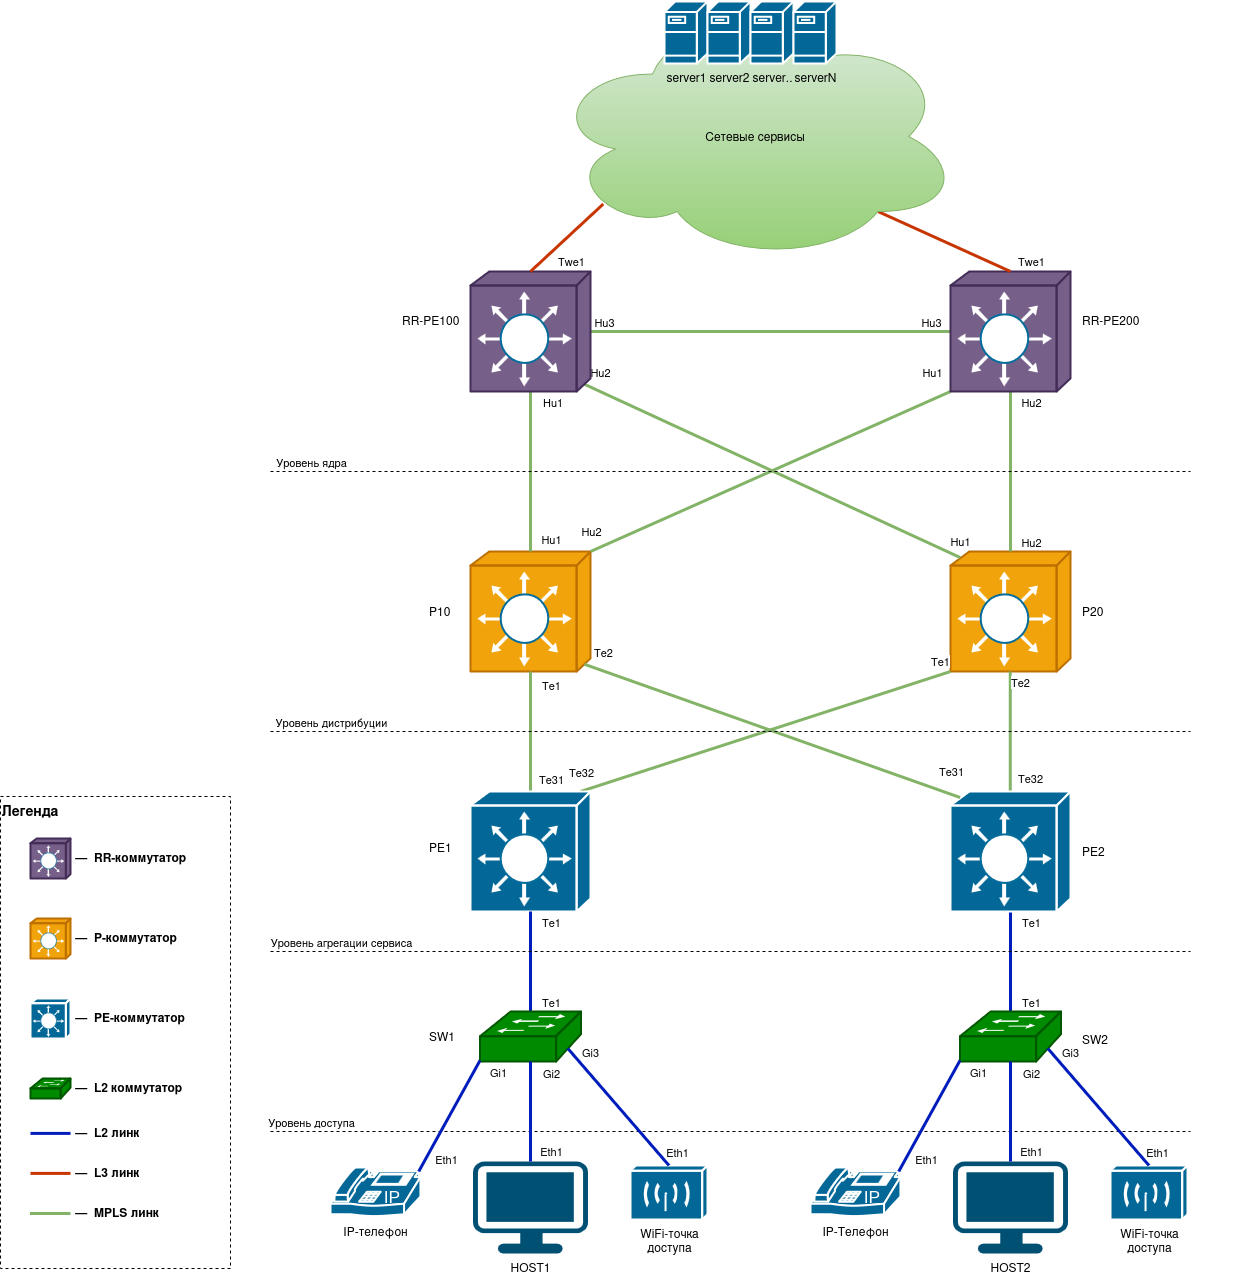
Свойства предлагаемой архитектуры
Использование подобной архитектуры позволяет обеспечить следующие свойства для проектируемой сети:
- Географическое разнесение узлов:
- Все MPLS-коммутаторы по вертикальной оси могут быть географически разнесены и дублировать функционал друг друга;
- Уровень дистрибуции может иметь сложную топологию, а MPLS-коммутаторы быть разнесены в т. ч. и горизонтально.
- Резервирование и отказоустойчивость:
- Использование полносвязной схемы включений на уровне ядра повышает отказоустойчивость и доступность сетевых сервисов;
- Использование BFD для IGP и MP-BGP соседств позволяет оперативно детектировать отказы и предотвращать потери трафика;
- Dual-homing-включение коммутаторов уровня дистрибуции и агрегации позволяет обеспечить наличие резервных путей при отказах;
- Коммутаторы с ролями P и PE в сложных топологиях могут включаться более чем двумя линками — до четырех альтернативных равноценных путей при использовании ECMP.
- Масштабируемость и быстрое развертывание:
- Коммутаторы с ролью P имеют простую типовую конфигурацию в транспортной плоскости и легко масштабируются как горизонтально, так и вертикально;
- Коммутаторы с ролью PE имеют простую типовую конфигурацию в транспортной и сервисной плоскостях и легко масштабируются как горизонтально, так и вертикально;
- Коммутаторы с ролью PE могут выполнять функции P-коммутатора для транзитного трафика и масштабироваться вертикально.
- Эффективное использование пропускной способности сети:
- Использование функциональности ECMP позволяет строить альтернативные LSP до LSR назначения через равноценные линки;
- Возможность балансировать VPN-трафик на Ingress-PE по всем равноценным альтернативным LSP позволяет эффективно использовать доступную емкость сети.
Выбор устройств в предлагаемой архитектуре
К устройствам на разных уровнях архитектуры применяются различные требования по числу интерфейсов и количественным характеристикам в плоскостях управления и передачи данных.
В зависимости от ролей устройства можно разделить на три общие группы:
- RR и PE-коммутаторы;
- P-коммутаторы;
- L2-коммутаторы.
Коммутаторы RR и PE — к данным устройствам предъявляются требования по производительности, количеству маршрутов и количеству VRF, необходимых для рефлексии MP–BGP маршрутов в сети и терминации сетевых сервисов, а также числу транспортных и сервисных MPLS-туннелей из расчета на все LSR MPLS-домена.
P-коммутаторы должны отвечать требованиям по производительности, числу маршрутов и транспортных туннелей и быть достаточными для обеспечения IP/MPLS-связности на Underlay-сети.
L2-коммутаторы должны отвечать требованиям по производительности, количеству MAC-адресов и функционалу, необходимых для подключения конечных устройств согласно сервисной модели.
В данной главе руководства рассматриваются рекомендации для выбора возможных продуктовых решений для устройств первых двух групп.
Функциональность MPLS и BGP на коммутаторах Eltex предоставляется по лицензии.
Функциональность MP-BGP AF VPNv4 Unicast доступна только при наличии лицензий на функциональности BGP и MPLS.
Рекомендуется учитывать следующие моменты при выборе оборудования с поддержкой MPLS:
- Лицензирование:
- RR и PE-коммутаторы требуют наличия лицензий на функционал BGP и MPLS;
- P-коммутаторам, в классической схеме с IGP-протоколами в Underlay-сети, достаточно лицензии на MPLS.
- Типы интерфейсов:
- Тип и число интерфейсов для подключения общих сетевых ресурсов;
- Тип и число интерфейсов для подключения устройств уровня дистрибуции;
- Количество маршрутов:
- Суммарное количество Underlay- и Overlay-маршрутов в FIB для топологии;
- Умножение числа маршрутов на число равноценных альтернативных путей в расчете числа Underlay-маршрутов при использовании ECMP;
- Умножение числа маршрутов в расчете числа Overlay-маршрутов при использовании одинаковых наборов route-target both и route-target import в нескольких разных VRF.
- Количество VRF:
- Потенциальная потребность в локальных и тестовых инстансах при расчете количества VRF;
- Удвоение необходимых VRF на HUB-PE для INGRESS и EGRESS VRF при использовании топологии Hub&Spoke.
- Количественные характеристики динамических протоколов:
- Число подключений к альтернативным RR при расчете максимального числа BGP-соседств для RR;
- Потребность в защите соседств динамических протоколов и критических сервисов при помощи BFD и число требуемых сессий;
- Ограничения устройств по числу процессов, при планировании включений в PE с использованием OSPF.
- Количественные характеристики MPLS-туннелей:
- Особенности разделения аппаратных ресурсов при использовании функционала MPLS-туннелирования;
- Удвоение транспортных MPLS-туннелей относительно числа LSR MPLS-домена при расчете их максимального числа, ввиду однонаправленности LSP;
- Ограничение на максимальное число активных альтернативных путей в Underlay-сети, при использовании ECMP;
- Умножение числа LSP на число равноценных альтернативных маршрутов при использовании ECMP;
- Рост числа сервисных туннелей соответственно числу уникальных RD в Overlay-сети, при использовании различных RD в VRF для одного VPN.
Возможные продуктовые решения Eltex на базе коммутаторов MES с поддержкой MPLS L3 VPN
Коммутаторы Eltex MES с поддержкой MPLS L3 VPN имеют унифицированное ПО и одинаковый набор сетевых функций.
Модели коммутаторов Eltex с поддержкой MPLS L3 VPN:
Модель коммутатора | Типы интерфейсов | Количество интерфейсов | Размер FIB, IPv4 Unicast маршруты | Количество VRF, шт | Количество BGP-соседств, шт | Количество OSPF-процессов, шт | Количество OSPF-соседств, шт | Количество IS-IS-соседств, шт | Количество BFD-сессий, шт | Количество транспортных MPLS-туннелей encaps/decaps, шт | Количество сервисных MPLS-туннелей, encaps/decaps, шт |
|---|---|---|---|---|---|---|---|---|---|---|---|
MES5316A1 | 1000BASE-X (SFP)/ 10GBASE-R (SFP+) | 16 | 16351 | 15 | 32 | 20 | 64 | 32 | 128 | 2048 | Инкапсуляция: 2048 |
| Декапсуляция: 15 | |||||||||||
MES5324A1 | 1000BASE-X (SFP)/ 10GBASE-R (SFP+) | 24 | 16351 | 15 | 32 | 20 | 64 | 32 | 128 | 2048 | Инкапсуляция: 2048 |
| Декапсуляция: 15 | |||||||||||
| MES5332A | 1000BASE-X (SFP)/ 10GBASE-R (SFP+) | 32 | 16351 | 15 | 32 | 20 | 64 | 32 | 128 | 2048 | Инкапсуляция: 2048 |
| Декапсуляция: 15 | |||||||||||
| MES5300-24 | 1000BASE-X (SFP)/ 10GBASE-R (SFP+) | 24 | 16351 | 15 | 32 | 20 | 256 | 32 | 128 | 2032 | Инкапсуляция: 2048 |
40GBASE-R4 (QSFP+)/ 100GBASE-R4 (QSFP28) | 6 | Декапсуляция: 15 | |||||||||
| MES5300-48 | 1000BASE-X (SFP)/ 10GBASE-R (SFP+) | 48 | 16351 | 15 | 32 | 20 | 256 | 32 | 128 | 2032 | Инкапсуляция: 2048 |
40GBASE-R4 (QSFP+)/ 100GBASE-R4 (QSFP28) | 6 | Декапсуляция: 15 | |||||||||
| MES5305-48 | 1000BASE-X (SFP)/ 10GBASE-R (SFP+) | 48 | 28639 | 15 | 32 | 20 | 256 | 32 | 128 | 2048 | Инкапсуляция: 2048 |
40GBASE-R4 (QSFP+)/ 100GBASE-R4 (QSFP28) | 6 | Декапсуляция: 15 | |||||||||
| MES5310-48 | 1000BASE-X (SFP)/ 10GBASE-R (SFP+) | 48 | 32735 | 250 | 64 | 20 | 256 | 32 | 128 | 2048 | Инкапсуляция: 2048 |
40GBASE-R4 (QSFP+)/ 100GBASE-R4 (QSFP28) | 6 | Декапсуляция: 250 | |||||||||
| MES5320-24 | 1000BASE-X (SFP)/ 10GBASE-R (SFP+)/ 25GBASE-R (SFP28) | 24 | 118756 | 250 | 64 | 20 | 256 | 32 | 128 | 2048 | Инкапсуляция: 2048 |
40GBASE-R4 (QSFP+)/ 100GBASE-R4 (QSFP28) | 2 | Декапсуляция: 250 | |||||||||
| MES5400-24 | 1000BASE-X (SFP)/ 10GBASE-R (SFP+) | 24 | 32735 | 250 | 64 | 20 | 256 | 32 | 128 | 2048 | Инкапсуляция: 2048 |
40GBASE-R4 (QSFP+)/ 100GBASE-R4 (QSFP28) | 6 | Декапсуляция: 250 | |||||||||
| MES5410-48 | 1000BASE-X (SFP)/ 10GBASE-R (SFP+)/ 25GBASE-R (SFP28) | 48 | 294884 | 250 | 64 | 20 | 256 | 32 | 128 | 2048 | Инкапсуляция: 2048 |
40GBASE-R4 (QSFP+)/ 100GBASE-R4 (QSFP28) | 6 | Декапсуляция: 250 | |||||||||
| MES5500-32 | 40GBASE-R4 (QSFP+)/ 100GBASE-R4 (QSFP28) | 32 | 294884 | 250 | 64 | 20 | 256 | 32 | 128 | 2048 | Инкапсуляция: 2048 |
| 10GBASE-R (SFP+) | 2 | Декапсуляция: 250 | |||||||||
| MES5600-24 | 40GBASE-R4 (QSFP+)/ 100GBASE-R4 (QSFP28) | 24 | 294884 | 250 | 64 | 20 | 256 | 32 | 128 | 2048 | Инкапсуляция: 2048 |
40GBASE-R4 (QSFP+)/ 100GBASE-R4 (QSFP28)/ 400GBASE-R8 (QSFP56-DD) | 8 | ||||||||||
| 10GBASE-R (SFP+) | 2 | Декапсуляция: 250 | |||||||||
| MES5700-32 | 40GBASE-R4 (QSFP+)/ 100GBASE-R4 (QSFP28)/ 400GBASE-R8 (QSFP56-DD) | 32 | 294884 | 250 | 64 | 20 | 256 | 32 | 128 | 2048 | Инкапсуляция: 2048 |
| 10GBASE-R (SFP+) | 2 | Декапсуляция: 250 | |||||||||
| MES5400-48 | 1000BASE-X (SFP)/ 10GBASE-R (SFP+) | 48 | 32735 | 250 | 64 | 20 | 256 | 32 | 128 | 2048 | Инкапсуляция: 2048 |
40GBASE-R4 (QSFP+)/ 100GBASE-R4 (QSFP28) | 6 | Декапсуляция: 250 |
1 Устройства на этапе EndOfSale.
Функциональные возможности и ограничения версий ПО
Реализованы следующие функциональные возможности:
| Версия ПО | Устройство | Ограничение |
|---|---|---|
| 6.6.13.4 | Все устройства с поддержкой MPLS | Поддержаны MP-BGP AF VPNv4 Unicast и Extended BGP Communities. |
| Поддержана работа LDP. | ||
| Поддержано построение Overlay IPv4 VPN сетей с помощью стека технологий MPLS на устройствах одной автономной системы. | ||
| Поддержано динамическое распределение MPLS-меток для процессов MP-BGP и LDP. | ||
| Поддержано определение в качестве FEC IPv4-подсети назначения с длиной префикса 32 (адреса loopback-интерфейсов) в LDP. | ||
| Поддержан Basic discovery режим установления соседства в LDP. | ||
| Поддержан Downstream Unsolicited Label Advertisement режим анонсирования MPLS-меток в LDP. | ||
| Поддержан Independent Label Distribution Control режим распространения MPLS-меток. | ||
| Поддержан Liberal Label Retention режим удержания MPLS-меток. | ||
| Поддержана статическая аллокация IP ECMP-ресурсов для MPLS LSP. | ||
| Поддержана балансировка исходящего VPN-трафика на PE-маршрутизаторе. | ||
| Поддержан Per-VRF режим выделения сервисных MPLS-меток в MP-BGP. | ||
| Поддержан Jumbo-Frame для MPLS LSP. | ||
| Поддержан туннельный режим обработки TTL. |
Существуют следующие ограничения:
| Устройство | Ограничение |
|---|---|
| Все устройства с поддержкой MPLS | Не поддержано статическое задание диапазона MPLS-меток. |
| Не поддержана статическая конфигурация LSP. | |
| Не поддержана совместная работа MPLS и dot1q (VLAN) на одном интерфейсе. | |
| Не поддержана функциональность LDP IGP Synchronization. | |
| Не рекомендуется устанавливать значение ip maximum-paths более 4 альтернативных путей. | |
| Балансировка VPN-трафика выполняется только на PE-маршрутизаторах. | |
| Не поддержана работа с dn-bit и domain-tag в OSPF для dual-homing-включений CE-PE. | |
| Не поддержано изменение MPLS MTU на интерфейсах. | |
| Не поддержана совместная работа MPLS и функциональности стекирования коммутаторов. | |
| Не поддержана совместная работа MPLS и EVPN+VXLAN. | |
| MES5410-48 MES5500-32 MES5700-32 | Не поддержана работа туннельных сервисов, в том числе MPLS, при использовании профиля распределения аппаратных ресурсов: min-l3-max-l2. |
Работу с VRF-Lite и MPLS L3 VPN поддерживают следующие функции коммутатора:
| Функция | Протокол/сервис | Поддержка работы в VRF-Lite | Поддержка работы в MPLS L3 VPN |
|---|---|---|---|
| Интерфейсы | OOB-интерфейс (Out Of Band) | + | - |
| Физический интерфейс | + | + | |
| VLAN (Switch Virtual Interface) | + | + | |
| Port-Channel | + | + | |
| loopback | + | + | |
| IP interface | + | + | |
| ICMP | Ping | + | + |
| Traceroute | + | + | |
| ICMP Type 3 | + | + | |
| Маршрутизация | Статическая маршрутизация | + | + |
| PBR (Policy-based routing) | + | - | |
| BGP | + | + | |
| OSPF | + | + | |
| IS-IS | - | - | |
| PIM | + | - | |
| AAA | TACACS+ клиент | + | + |
| RADIUS-клиент | + | + | |
| Управление | Telnet-сервер | + | + |
| SSH-клиент/сервер | + | + | |
| SNMPv2/v3-сервер | + | + | |
| HTTP-сервер | + | + | |
| HTTPS-сервер | + | + | |
| Мониторинг | sFlow | + | + |
| Syslog | + | + | |
| Отказоустойчивость | BFD (для OSPF и BGP) | + | + |
| VRRP | + | + | |
| IP SLA | + | + | |
| peer-detection (для VPC) | + | - | |
| Сервисы | NTP-клиент/сервер | + | + |
| SNTP-клиент | + | + | |
| RADIUS-клиент для dot1x | + | + | |
| DNS-клиент | + | + | |
| DHCP Relay | + | + | |
| Передача файлов | TFTP-клиент/сервер | + | + |
| SCP-клиент/сервер | + | + | |
| SFTP-клиент | + | + |
Выделение аппаратных ресурсов для MPLS-туннелей
Для выбора оптимально подходящей модели устройства на этапе планирования сети необходимо учитывать особенности выделения различных аппаратных ресурсов для различных видов MPLS-туннелей.
MPLS-туннели можно разделить на два вида в соответствии с выполняемой функцией, протоколами и плоскостью:
- Транспортные MPLS-туннели, формируемые в результате сходимости LDP на транспортной плоскости Underlay-сети:
- Сервисные MPLS-туннели, формируемые в результате экспорта IP-маршрутов из сервисных VRF в MP-BGP, конвертации их в VPN-маршруты на сервисной плоскости и распространения между всеми PE MPLS-домена в рамках Overlay-сети.
Каждый туннель любого вида решает одну из задач:
- Инкапсуляция трафика — процесс добавления MPLS-заголовка к IP-трафику (операции PUSH и SWAP) для его передачи через MPLS-домен;
- Декапсуляция трафика — процесс удаления MPLS-заголовка (операция POP) из MPLS-трафика для его передачи через IP-сеть.
Виды MPLS-туннелей непосредственно и неразрывно связаны с MPLS-метками и их стеком, каждая из MPLS-меток служит для идентификации назначения трафика и дальнейшего действия с ним, возможны следующие подвиды MPLS-туннелей:
- Транспортные MPLS-туннели:
- Исходящие транспортные туннели (Ingress-LSP) — служат для инкапсуляции исходящего с LSR в MPLS-домен трафика, идентифицируются значением MPLS-метки для FEC, полученным от downstream-LSR (Remote Label);
- Входящие транспортные туннели (Egress-LSP) — служат для декапсуляции на LSR входящего из MPLS-домена трафика, идентифицируются значением MPLS-метки для FEC, назначенным текущим LSR (Local Label);
- Транзитные MPLS-туннели (transit-LSP) — служат для транзитной передачи MPLS-трафика следующему LSR, идентифицируются значением MPLS-метки для FEC, назначенным текущим LSR (Local Label).
- Сервисные MPLS-туннели:
- Исходящие сервисные туннели — служат для инкапсуляции исходящего с Ingress-PE в MPLS-домен трафика, идентифицируются значением MPLS-метки для RD (Out Label) и VPN-маршрута назначения, полученного по MP-BGP от удаленного Egress-PE для VPN-маршрута назначения;
- Входящие сервисные туннели — служат для декапсуляции на Egress-PE входящего из MPLS-домена трафика от удаленных Ingress-PE, идентифицируются значением MPLS-метки для RD (Out Label), назначенным на текущем PE для всех локальных VPN-маршрутов конкретного VRF, импортированных в MP-BGP и анонсируемых на RR (Local Label).
В зависимости от конфигурации MPLS-протоколов, роли устройства в топологии сети и его типа (P и/или PE), потребуется различный расход аппаратных ресурсов, что необходимо учитывать при проектировании сети и выборе устройств.
Функциональность MPLS, предоставляемая с соответствующими лицензиями, требует для своей работы предварительного бронирования части аппаратных ресурсов, выделение и занятие ресурсов происходит на этапе инициализации устройства в процессе его загрузки.
Для обеспечения функционирования MPLS-туннелей выделяются и занимаются ресурсы аппаратных TCAM- и ARP-таблиц — это отражается на количественных характеристиках других сетевых сервисов.
Функции инкапсуляции и декапсуляции трафика для транспортных и сервисных MPLS-туннелей используют общие, разделяемые между туннелями всех видов, ресурсы.
Занятие ресурсов выполняется двумя методами:
- Статически, из расчета на максимальные количественные характеристики функций туннелирования и без возможности совместного использования прочими сетевыми сервисами;
- Динамически, с возможностью совместного использования прочими сетевыми сервисами.
Для декапсуляции в MPLS-туннелях задействуются ресурсы TCAM. Блоки по 512 стандартных правил (30B) занимаются статически, сразу под максимальное количество туннелей всех видов и не могут быть разделены с прочими сетевыми сервисами.
Для инкапсуляции в MPLS-туннелях используются ресурсы ARP-таблицы, 1 MPLS-туннель потребляет ресурсы, эквивалентные 4 ARP-записям:
- Для транспортных MPLS-туннелей занимаются статически, сразу для максимума возможных туннелей;
- Для сервисных MPLS-туннелей занимаются динамически, по мере установки туннелей в аппаратные таблицы.
Для детального анализа различных сетевых топологий и подсчета количества LSP рекомендуется использовать методики, по аналогии с описанными в RFC 5439.
В этом документе рассматривается пример расчета на малой топологии с указанием возможных нюансов реализации функциональности на коммутаторах MES.
Задействование функциональности ECMP приводит к умножению числа требуемых аллокаций аппаратных ресурсов для всех видов туннелей на число настроенных альтернативных путей и статическому бронированию этих ресурсов при инициализации устройства, вне зависимости от наличия или отсутствия альтернативных путей в аппаратных таблицах.
Пример расчета выделения аппаратных ресурсов для транспортных MPLS-туннелей
Расчет количества транспортных MPLS-туннелей выполняется для всех LSR MPLS-домена.
При расчете количества требуемых аппаратных ресурсов для транспортных MPLS-туннелей необходимо учитывать следующие факторы:
- Основой транспортного туннеля является LSP;
- LSP — всегда однонаправленный канал между двумя LSR;
- LSP строится «навстречу» продвижению потока трафика (FEC), но сам является сонаправленным каналом;
- Функция PHP на коммутаторах MES выполняется безусловно и не может быть отключена;
- LDP на коммутаторах MES использует режим распространения меток downstream-unsolicited;
- Установка LSP в LFIB и выделение для него аппаратных ресурсов происходят только при наличии в FIB актуального маршрута в конечной точке LSP — FEC loopback-интерфейса Egress-LSR.
При режиме распространения меток в LDP downstream-unsolicited все подвиды транспортных туннелей формируются в процессе построения Ingress-LSP (исходящих транспортных туннелей) на всех LSR MPLS-домена. При отсутствии у LSR downstream-соседей для дальнейшего распространения информации о FEC, локальная MPLS-метка может не выделяться и не бронироваться. Следовательно, на «тупиковых» LER MPLS-домена не будет возникать «паразитных» Ingress-LSP, для которых на данном LER выполняется PHP.
Безусловное выполнение PHP на всех устройствах схемы исключает перерасход аппаратных ресурсов для инкапсуляции/декапсуляции MPLS-заголовков непосредственно соединенными LSR (между ними трафик передается механизмами IP-маршрутизации). Для формирования входящих MPLS-туннелей при работе механизма PHP используется специальная MPLS-метка — 3 (imp-null), за счет чего операция с MPLS-меткой для входящего LSP "сдвигается" на один LSR "вверх", и задействуются ресурсы предпоследнего LSR.
В общем случае, для передачи VPN-трафика, необходимо корректное построение пар входящих–исходящих транспортных туннелей между всеми LSR домена, кроме непосредственно подключенных друг к другу (LSR-LSR).
Транзитные MPLS-туннели будут требовать ресурсы в соответствии с выполняемой операцией над меткой, необходимой для передачи MPLS-трафика следующему LSR в LSP:
- Используют ресурсы декапсуляции для выполнения операции POP(PHP);
- Используют ресурсы инкапсуляции для выполнения операции SWAP.
Диаграмма построения LSP и формирования транспортных туннелей в Underlay-сети:
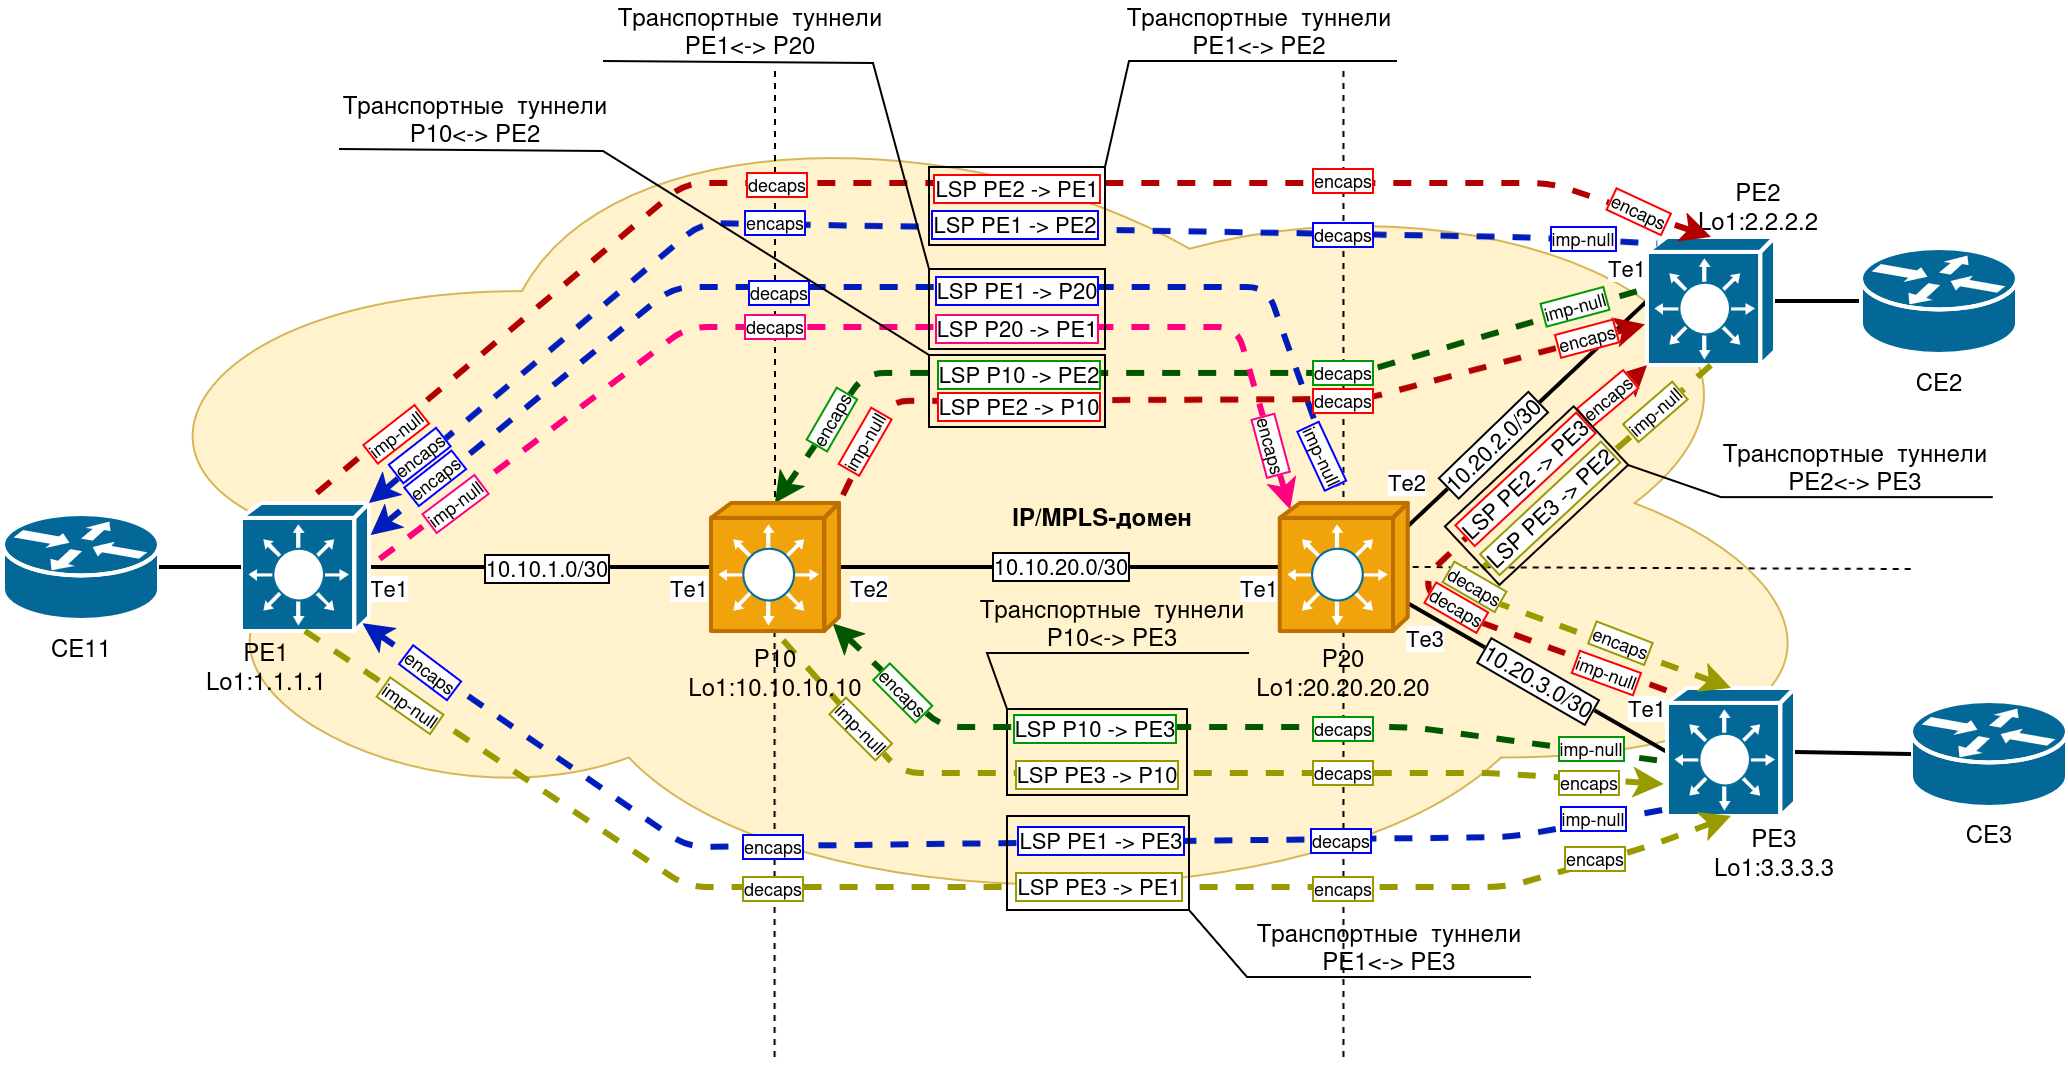
На диаграмме выше отображены пути построения LSP и формирование пар транспортных туннелей в малом MPLS-домене из 5 LSR.
Диаграмма приведена без учета функциональности ECMP.
Исходящие транспортные туннели для каждого LSR отображены своим цветом.
Входящие транспортные туннели с MPLS-меткой 3(imp-null) — аллокации ресурсов не требуют и не учитываются в расчете конкретного LSR, но учитываются как транзитные decaps туннели на вышестоящем LSR в LSP.
Итоговое распределение ресурсов для транспортных туннелей между LSR схемы:
| LSR | Входящие туннели (imp-null), шт | Исходящие туннели (encaps), шт | Транзитные туннели (encaps), шт | Транзитные туннели (decaps), шт | Аллокация ресурсов на LSR, encaps/decaps |
|---|---|---|---|---|---|
| Аллокация ресурсов в MPLS-домене: | - | 12 | 4 | 12 | |
| PE1 | 3 | 3 | 0 | 0 | 3/0 |
| P10 | 2 | 2 | 2 | 4 | 4/4 |
| P20 | 1 | 1 | 2 | 8 | 3/8 |
| PE2 | 3 | 3 | 0 | 0 | 3/0 |
| PE3 | 3 | 3 | 0 | 0 | 3/0 |
Рекомендуется, чтобы характеристики выбираемого устройства соответствовали максимальным значениям аллокаций для LSR MPLS-домена.
Просмотр текущего числа транспортных туннелей и значений меток для них на коммутаторах MES возможен с помощью команды show mpls forwarding:
PE1#show mpls forwarding |
P10#show mpls forwarding |
P20#show mpls forwarding |
PE2#show mpls forwarding |
PE3#show mpls forwarding |
Где: No Label — может возникать при отсутствии downstream LSR; Pop Label — индикатор использования PHP на вышестоящем LSR. |
Пример расчета выделения аппаратных ресурсов для сервисных MPLS-туннелей
Расчет количества сервисных MPLS-туннелей выполняется только для PE-маршрутизаторов MPLS-домена.
При расчете количества требуемых аппаратных ресурсов для сервисных MPLS-туннелей необходимо учитывать следующие факторы:
- Сервисные туннели также однонаправленны;
- Сервисный туннель однозначно идентифицируется исходящей сервисной меткой VPN-маршрута;
- Выделение сервисной метки производится в режиме per-VRF на Egress-PE; метка закрепляется за всеми локальными VPN-маршрутами уникального VRF вместе с уникальным RD для VRF;
- Сервисная метка используется всеми остальными PE для инкапсуляции VPN-трафика к Egress-PE;
- Сервисные туннели строятся «навстречу» продвижению потока VPN-трафика, но сами являются сонаправленным потоку трафика каналом;
- Сервисная метка отбрасывается на Egress-PE в процессе декапсуляции трафика, т. к. является последней в стеке меток;
- Установка сервисных туннелей и сервисных маршрутов в FIB и выделение для них аппаратных ресурсов производится только при наличии актуального LSP в LFIB.
Все подвиды сервисных туннелей формируются в процессе построения входящих сервисных туннелей, т. е. при распространении значений сервисных VPN-меток для локальных VPN-маршрутов уникального VRF с Egress-PE на всех PE MPLS-домена. Сервисные туннели существуют на всем протяжении пути трафика между двумя и более PE.
Для корректной работы MPLS L3 VPN необходимо корректное построение между PE пар входящих–исходящих сервисных туннелей согласно выбранной топологии L3 VPN.
Диаграмма построения и формирования сервисных туннелей в Overlay-сети для двух полносвязных VPN на трех PE:
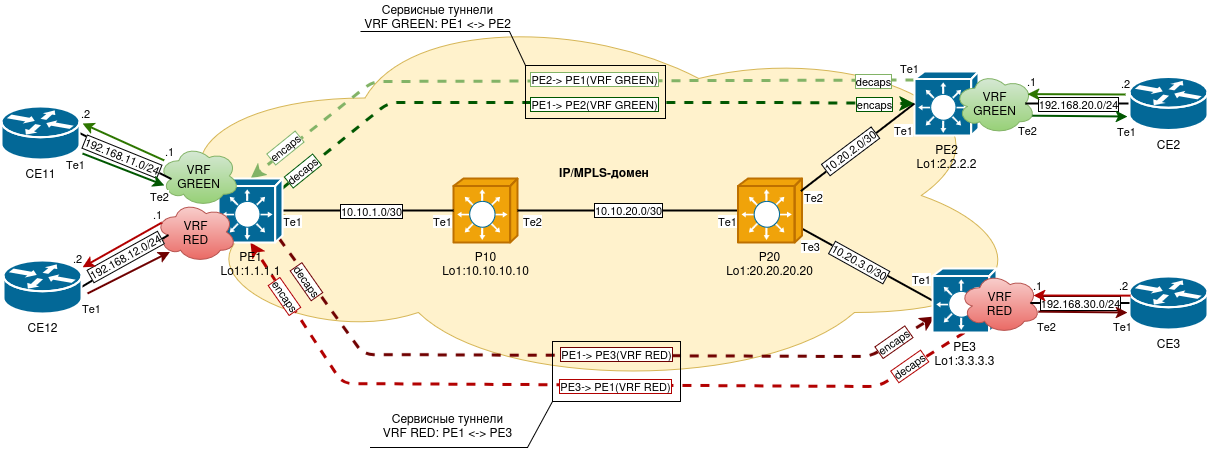
На диаграмме выше отображены пути построения сервисных туннелей и формирование пар сервисных туннелей для двух полносвязных VPN на трех PE.
Диаграмма приведена без учета функциональности ECMP.
Увеличение числа VRF на PE ведет к увеличению числа входящих сервисных туннелей.
Итоговое распределение ресурсов для сервисных туннелей между PE VRF-схемы:
| PE | VRF | RD | RT, import/export | Исходящие туннели (encaps), шт | Входящие туннели (decaps), шт | Аллокация ресурсов на PE, encaps/decaps |
|---|---|---|---|---|---|---|
| Аллокация ресурсов в MPLS-домене: | - | - | - | 4 | 4 | - |
| PE1 | GREEN | 65500:1 | 65500:1/65500:1 | 1 | 1 | 2/2 |
| PE1 | RED | 65500:2 | 65500:2/65500:2 | 1 | 1 | |
| PE2 | GREEN | 65500:1 | 65500:1/65500:1 | 1 | 1 | 1/1 |
| PE3 | RED | 65500:2 | 65500:2/65500:2 | 1 | 1 | 1/1 |
Рекомендуется учитывать количество VRF и топологию VPN, с учетом запаса ресурсов на траблшутинг и оперативное расширение сети при выборе PE-устройства.
Просмотр текущего числа сервисных туннелей и значений меток для них на коммутаторах MES возможен с помощью команды show ip bgp vpnv4 unicast:
PE1#show ip bgp vpnv4 unicast |
PE2#show ip bgp vpnv4 unicast |
PE3#show ip bgp vpnv4 unicast |
Ориентироваться необходимо на значение поля «
|
Диаграмма построения и формирования сервисных туннелей в Overlay-сети для одного полносвязного VPN на трех PE:
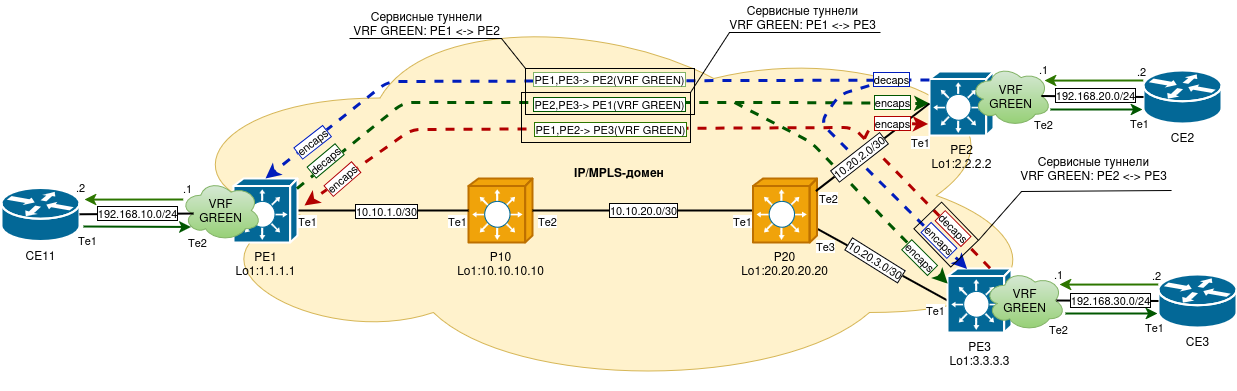
На диаграмме выше отображены пути построения сервисных туннелей и формирование пар сервисных туннелей для одного полносвязного VPN на трех PE.
Диаграмма приведена без учета функциональности ECMP.
Увеличение числа удаленных PE, на каждом из которых развернуты VRF с одинаковыми RT для импорта VPN-маршрутов, приводит к увеличению числа исходящих сервисных туннелей к PE, на каждом из которых развернуты VRF с аналогичными RT для экспорта VPN-маршрутов.
Итоговое распределение ресурсов для сервисных туннелей между PE VRF-схемы:
| PE | VRF | RD | RT, import/export | Исходящие туннели (encaps), шт | Входящие туннели (decaps), шт | Аллокация ресурсов на PE, encaps/decaps |
|---|---|---|---|---|---|---|
| Аллокация ресурсов в MPLS-домене: | - | - | - | 6 | 3 | - |
| PE1 | GREEN | 65500:1 | 65500:1/65500:1 | 2 | 1 | 2/1 |
| PE2 | GREEN | 65500:1 | 65500:1/65500:1 | 2 | 1 | 2/1 |
| PE3 | GREEN | 65500:1 | 65500:1/65500:1 | 2 | 1 | 2/1 |
Рекомендуется учитывать количество VRF и топологию VPN, с учетом запаса ресурсов на траблшутинг и оперативное расширение сети при выборе PE-устройства.
Просмотр текущего числа сервисных туннелей и значений меток для них на коммутаторах MES возможен с помощью команды show ip bgp vpnv4 unicast:
PE1#show ip bgp vpnv4 unicast |
PE2#show ip bgp vpnv4 unicast |
PE3#show ip bgp vpnv4 unicast |
Ориентироваться необходимо на значение поля «
|
Конфигурация IP/MPLS на коммутаторах Eltex MES
Рекомендуется производить конфигурацию IP/MPLS на коммутаторах Eltex MES в следующем порядке:
- Установка и активация необходимых лицензий;
- Предварительная настройка функций, требующих обязательной перезагрузки;
- Настройка IP-Underlay сети транспортной плоскости;
- Настройка MPLS-Underlay сети транспортной плоскости;
- Настройка MPLS-Overlay сети сервисной плоскости;
- Настройка VPN-сервисов и связности с CE;
- Настройка дополнительных сервисных функциональностей (DHCP relay, route-map и т. п.).
На каждом из этапов конфигурирования рекомендуется производить базовую проверку работоспособности настроенных функций.
Поэтапная конфигурация в логическом порядке при конфигурировании оборудования и своевременный контроль работоспособности протоколов и механизмов по плоскостям позволяют уменьшить вероятность возникновения ошибок и ускорить настройку и отладку устройств в сети.
Схема практической части:
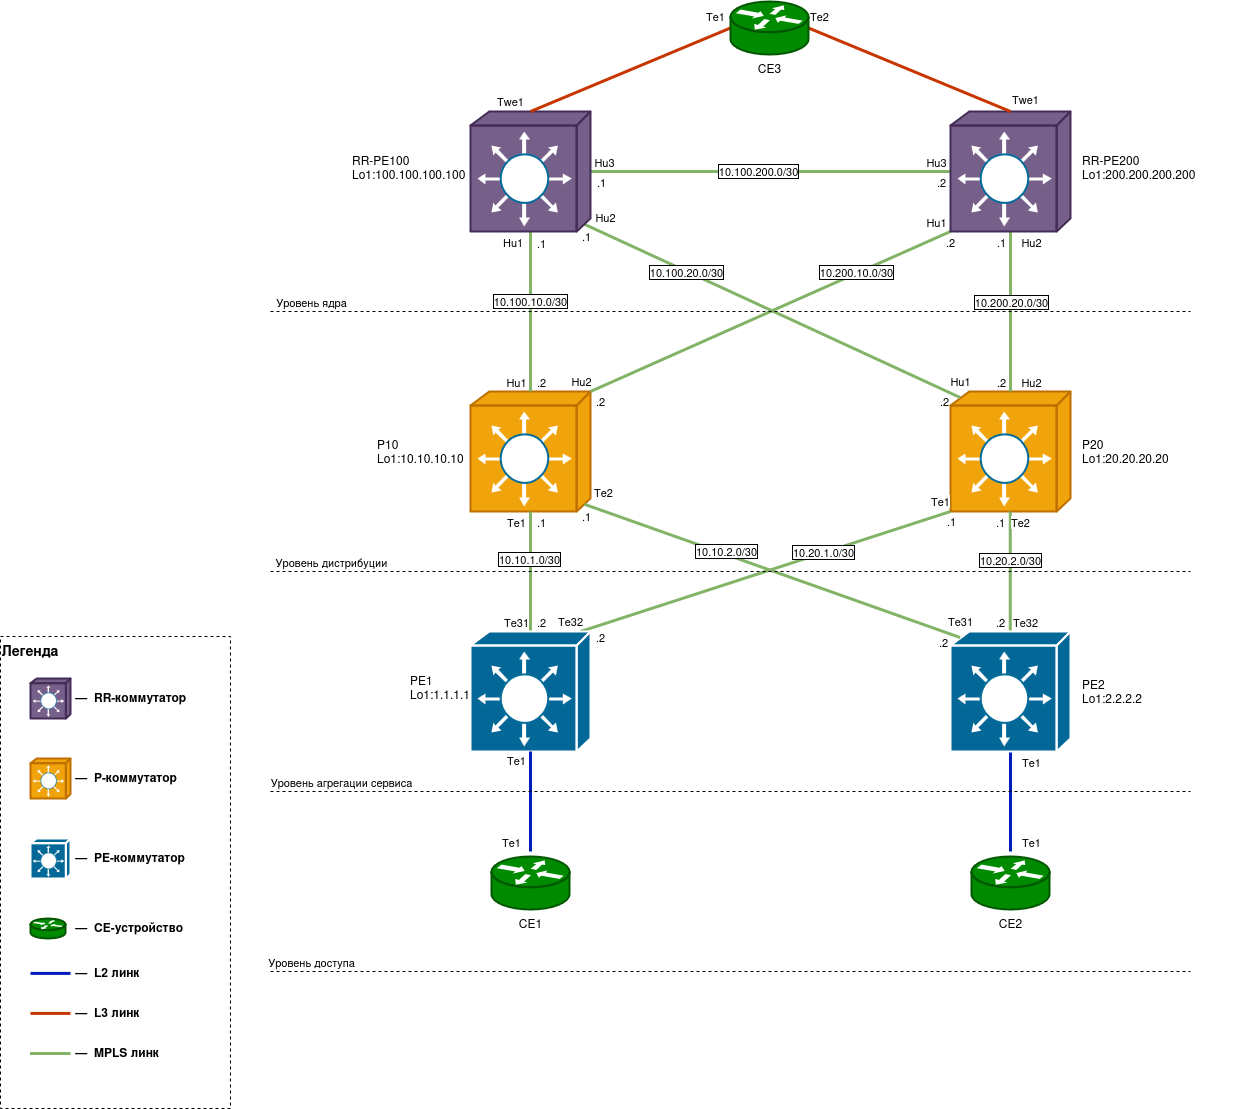
IP-адресация и интерфейсы приводятся в качестве примера, значения выбраны из принципа наглядности и не являются рекомендацией по планированию сети.
Адресный план Loopback-интерфейсов:
| Хост | Интерфейс | IP-интерфейс |
|---|---|---|
| RR-PE100 | Loopback 1 | 100.100.100.100/32 |
| RR-PE200 | Loopback 1 | 200.200.200.200/32 |
| P10 | Loopback 1 | 10.10.10.10/32 |
| P20 | Loopback 1 | 20.20.20.20/32 |
| PE1 | Loopback 1 | 1.1.1.1/32 |
| PE2 | Loopback 1 | 2.2.2.2/32 |
Адресный план линковых интерфейсов и подсетей:
| Хост A | Хост B | Интерфейс A | Интерфейс B | IP-интерфейс A | IP-интерфейс B | IP-подсеть |
|---|---|---|---|---|---|---|
| RR-PE100 | RR-PE200 | Hu1/0/3 | Hu1/0/3 | 10.100.200.1/30 | 10.100.200.2/30 | 10.100.200.0/30 |
| RR-PE100 | P10 | Hu1/0/1 | Hu1/0/1 | 10.100.10.1/30 | 10.100.10.2/30 | 10.100.10.0/30 |
| RR-PE100 | P20 | Hu1/0/2 | Hu1/0/1 | 10.100.20.1/30 | 10.100.20.2/30 | 10.100.20.0/30 |
| RR-PE200 | P10 | Hu1/0/1 | Hu1/0/2 | 10.200.10.1/30 | 10.200.10.2/30 | 10.200.10.0/30 |
| RR-PE200 | P20 | Hu1/0/2 | Hu1/0/2 | 10.200.20.1/30 | 10.200.20.2/30 | 10.200.20.0/30 |
| P10 | PE1 | Te1/0/1 | Te1/0/31 | 10.10.1.1/30 | 10.10.1.2/30 | 10.10.1.0/30 |
| P10 | PE2 | Te1/0/2 | Te1/0/31 | 10.10.2.1/30 | 10.10.2.2/30 | 10.10.2.0/30 |
| P20 | PE1 | Te1/0/1 | Te1/0/32 | 10.20.1.1/30 | 10.20.1.2/30 | 10.20.1.0/30 |
| P20 | PE2 | Te1/0/2 | Te1/0/32 | 10.20.2.1/30 | 10.20.2.2/30 | 10.20.2.0/30 |
Уникальные значения salt и seed для устройств домена:
| Хост | Router-id | salt = uint32(router-id) | seed = salt XOR 0xDEADBEEF |
|---|---|---|---|
| RR-PE100 | 100.100.100.100 | 1684300900 | 3133790859 |
| RR-PE200 | 200.200.200.200 | 3368601800 | 375748135 |
| P10 | 10.10.10.10 | 168430090 | 3567760613 |
| P20 | 20.20.20.20 | 336860180 | 3401165563 |
| PE1 | 1.1.1.1 | 16843009 | 3752640494 |
| PE2 | 2.2.2.2 | 33686018 | 3702504685 |
Подробная информация о планировании сети, рекомендации и базовый пример архитектуры представлены в соответствующих разделах руководства:
- Проектирование архитектуры сети на коммутаторах Eltex MES с использованием стека технологий MPLS L3 VPN;
- Общие рекомендации по планированию;
- Предлагаемая архитектура сети на коммутаторах Eltex MES с использованием стека технологий MPLS L3 VPN.
Предварительная настройка
Некоторые настройки требуют перезагрузки устройства для применения. Чтобы свести число перезагрузок к минимуму, рекомендуется выполнить действия, описанные в данном разделе, до основной настройки устройств.
Установка лицензий
Поддержка протокола BGP и технологии MPLS предоставляется по лицензии. Лицензии приобретаются отдельно для каждого устройства. Убедитесь в наличии соответствующих лицензий. Если лицензии отсутствуют, необходимо их установить. Для получения файлов лицензий необходимо обратиться к поставщику оборудования либо написать на электронную почту: eltex@eltex.ru.
Вывод команды show license в случае отсутствия установленных лицензий:
console#show license
Features installed:
                   Licenses  Licenses
     Feature       installed used      Active
------------------ --------- --------- -------

Licenses installed:
Для установки лицензии необходимо загрузить файл лицензии на устройство с помощью команды boot license source_url. Пример:
console#boot license tftp://192.168.1.1/licensefile

console#boot license tftp://192.168.1.1/licensefile
02-Jun-2022 12:01:49 %COPY-I-FILECPY: Files Copy - source URL tftp://192.168.1.1/licensefile destination URL flash://system/licenses/licensefile
02-Jun-2022 12:01:49 %LICENSE-I-INSTALL: License file licensefile was installed
02-Jun-2022 12:01:49 %COPY-N-TRAP: The copy operation was completed successfully

Copy: 1181 bytes copied in 00:00:01 [hh:mm:ss]
Для активации загруженной лицензии необходима перезагрузка устройства.
В текущей версии ПО функции EVPN/VXLAN и MPLS являются взаимоисключающими при работе на одном устройстве.
Одновременная установка двух взаимоисключающих лицензий или лицензии с комбинацией функций EVPN/VXLAN и MPLS допускается, но при загрузке такого файла система выведет сообщение о конфликте:
| %LICENSE-I-FEATURE-CONFLICT: Feature conflict: EVPN and MPLS. To choose a feature, use the command "system vpn-encapsulation" after reload the device. |
|---|
После перезагрузки устройства активной по умолчанию будет выбрана лицензия EVPN. Изменение активной лицензии производится с помощью команды управления режимом VPN-инкапсуляции в контексте глобальной конфигурации: system vpn-encapsulation { mpls | vxlan }. Для вступления настроек в силу необходимо сохранить конфигурацию и выполнить перезагрузку устройства. Данные команды доступны в CLI только при наличии активных лицензий с взаимоисключающим функционалом и после перезагрузки устройства.
Для просмотра текущего режима VPN-инкапсуляции можно воспользоваться командой: show system vpn-encapsulation.
Вывод команды show system vpn-encapsulation в случае наличия лицензий с взаимоисключающими функциями:
console#show system vpn-encapsulation
System vpn-encapsulation mode:
     VxLAN

System vpn-encapsulation mode after reset:
     VxLAN

Supported vpn-encapsulation modes:
     VxLAN
      MPLS
Пример переключения режима VPN-инкапсуляции в CLI:
Настройки jumbo-frame и ECMP
Подробная информация о MTU в MPLS-домене представлена в теоретической части руководства: MTU в MPLS L3 VPN в процессе коммутации пакетов по меткам.
Подробная информация о работе механизма ECMP в MPLS-домене представлена в теоретической части руководства: Использование ECMP на Underlay IP/MPLS сети.
Настройка jumbo-frame необходима для передачи через MPLS-сеть пользовательских кадров большого размера, более 1500 байт. Максимальный размер MTU, с учетом MPLS-заголовков, составляет 10240 байт.
Пример выполнения данных настроек в CLI:
console(config)#port jumbo-frame
This setting will take effect only after copying running configuration to startup configuration and resetting the device
console(config)#ip maximum-paths 2
Warning! New value will be applied only after reboot
console(config)#port-channel load-balance src-dst-mac-ip-port
console(config)#exit
Где:
port jumbo-frame— включение поддержки передачи больших фреймов (10240 — транзитный трафик, 9000 — протокольный и self-трафик);ip maximum-paths 2— задание максимального количества путей, которые могут быть установлены в FIB для каждого маршрута, с помощью чего задействуется функциональность ECMP;port-channel load-balance src-dst-mac-ip-port— изменение алгоритма балансировки трафика с использованием 5-Tuple (пятикортежа).
Перезагрузка устройства
Для применения лицензии и настроек port jumbo-frame и ip maximum-paths необходимо сохранить конфигурацию и выполнить перезагрузку:
console#write
Overwrite file [startup-config].... (Y/N)[N] ?Y
23-Jun-2022 07:13:16 %COPY-I-FILECPY: Files Copy - source URL running-config destination URL flash://system/configuration/startup-config
23-Jun-2022 07:13:16 %COPY-N-TRAP: The copy operation was completed successfully
Copy succeeded
console#reload
This command will reset the whole system and disconnect your current session. Do you want to continue ? (Y/N)[N] Y
Shutting down...
Проверка успешности предварительной настройки
После перезагрузки рекомендуется выполнить проверку успешности активации лицензии и применения настроек.
Пример вывода команды show license в случае успешно установленной лицензии и переключения режима VPN-инкапсуляции на MPLS:
Пример вывода команд для настроек port jumbo-frame, ip maximum-paths и режима VPN-инкапсуляции:
Строки Jumbo frames are enabled (current MTU 10240 bytes), Maximum Parallel Paths: 2 (2 after reset) и System vpn-encapsulation mode: MPLS указывают на успешное включение соответствующих настроек, Load balancing: src-dst-mac-ip-port указывает на успешное изменение алгоритма балансировки трафика для LAG и ECMP с использованием 5-Tuple (пятикортежа).
Настройка IP-Underlay сети транспортной плоскости с использованием протокола OSPF
Схема аналогична схеме, приведенной в разделе практической части.
Выполните предварительную настройку на всех устройствах схемы.
Полные конфигурации всех устройств для данного раздела руководства находятся в Приложении 1: Конфигурации устройств IP-Underlay-сети транспортной плоскости с использованием протокола OSPF.
Для упрощения процедуры настройки через консоль сначала можно использовать функцию terminal no prompt, отключающую необходимость подтверждения перед выполнением некоторых команд.
Функция terminal no prompt включается в привилегированном EXEC режиме для текущего сеанса управления. Команда действует до момента завершения сеанса:
console#terminal no prompt
Отключите протокол STP и задайте имя устройства в глобальном контексте конфигурации:
console#configure terminal
console(config)#no spanning-tree
console(config)#spanning-tree bpdu filtering
console(config)#hostname RR-PE100
RR-PE100(config)#end
Произведите настройку интерфейсов в соответствующих контекстах конфигурации:
RR-PE100#configure terminal
RR-PE100(config)#interface loopback 1
RR-PE100(config-if)#ip address 100.100.100.100 /32
RR-PE100(config-if)#exit
RR-PE100(config)#interface HundredGigabitEthernet1/0/1
RR-PE100(config-if)#description MPLS-link-P10,Hu1
RR-PE100(config-if)#ip address 10.100.10.1 /30
RR-PE100(config-if)#exit
RR-PE100(config)#interface HundredGigabitEthernet1/0/2
RR-PE100(config-if)#description MPLS-link-P20,Hu1
RR-PE100(config-if)#ip address 10.100.20.1 /30
RR-PE100(config-if)#exit
RR-PE100(config)#interface HundredGigabitEthernet1/0/3
RR-PE100(config-if)#description MPLS-link-RR-PE200,Hu3
RR-PE100(config-if)#ip address 10.100.200.1 /30
RR-PE100(config-if)#end
В целях минимизации перерыва в передаче трафика при отсутствии функционала LDP IGP Synchronization рекомендуется использовать настройку протокола OSPF max-metric router-lsa on-startup 300. Она позволяет добавить задержку для установки маршрутов в FIB до полной сходимости в OSPF-топологии при перезапуске маршрутизаторов.
Произведите настройку OSPF-процесса в соответствующем контексте конфигурации:
RR-PE100#configure terminal
RR-PE100(config)#router ospf 1
RR-PE100(router_ospf_process)#router-id 100.100.100.100
RR-PE100(router_ospf_process)#network 100.100.100.100 area 0.0.0.0
RR-PE100(router_ospf_process)#network 10.100.10.1 area 0.0.0.0
RR-PE100(router_ospf_process)#network 10.100.20.1 area 0.0.0.0
RR-PE100(router_ospf_process)#network 10.100.200.1 area 0.0.0.0
RR-PE100(router_ospf_process)#max-metric router-lsa on-startup 300
RR-PE100(router_ospf_process)#end
В протоколе OSPF рекомендуется задействовать режим p2p (point-to-point), который используется при установлении соединений на выделенных линках, где каждый маршрутизатор имеет только одного соседа. При таком типе соединения нет необходимости выбирать Designated Router (DR) или Backup Designated Router (BDR). Этот подход упрощает установление соседств, уменьшая время сходимости протокола.
Также рекомендуется использование BFD для защиты линков от неполадок с односторонней непроходимостью и ускорения времени реакции топологии на отказы.
Настройте дополнительные атрибуты OSPF-соседств и включите BFD на IP-интерфейсах в соответствующих контекстах конфигурации:
RR-PE100#configure terminal
RR-PE100(config)#interface ip 10.100.10.1
RR-PE100(config-ip)#ip ospf network point-to-point
RR-PE100(config-ip)#ip ospf bfd
RR-PE100(config)#interface ip 10.100.20.1
RR-PE100(config-ip)#ip ospf network point-to-point
RR-PE100(config-ip)#ip ospf bfd
RR-PE100(config)#interface ip 10.100.200.1
RR-PE100(config-ip)#ip ospf network point-to-point
RR-PE100(config-ip)#ip ospf bfd
RR-PE100(config-ip)#end
Настройте интервалы и множители BFD для IGP-соседств в глобальном контексте конфигурации:
RR-PE100#configure terminal
RR-PE100(config)#bfd neighbor 10.100.10.2 min-rx 50 interval 50 multiplier 3
RR-PE100(config)#bfd neighbor 10.100.20.2 min-rx 50 interval 50 multiplier 3
RR-PE100(config)#bfd neighbor 10.100.200.2 min-rx 50 interval 50 multiplier 3
RR-PE100(config)#end
Если в процессе настройки возникнет ситуация, когда LDP-соседство будет установлено раньше сходимости протокола IGP, то для ускорения построения LSP рекомендуется произвести перезапуск OSPF-процесса:
RR-PE100#clear ip ospf 1 process

Reset OSPF process? (Y/N)[N] Y
Настройка RR-PE200 выполняется аналогично, с внесением необходимых изменений согласно схеме и плану IP-адресации.
Изменению от устройства к устройству подлежат следующие параметры:
- Hostname устройства;
- Description на интерфейсах;
- IP-адреса интерфейсов (физических + loopback);
- OSPF router-id;
- IP-интерфейсы в OSPF-процессе;
- IP-интерфейсы, для которых изменены атрибуты OSPF-соседств;
- IP-адреса BFD-соседей.
Настройка P-коммутаторов
Для упрощения процедуры настройки через консоль сначала можно использовать функцию terminal no prompt, отключающую необходимость подтверждения перед выполнением некоторых команд.
Функция terminal no prompt включается в привилегированном EXEC-режиме для текущего сеанса управления. Команда действует до момента завершения сеанса:
console#terminal no prompt
Отключите протокол STP и задайте имя устройства в глобальном контексте конфигурации:
console#configure terminal
console(config)#no spanning-tree
console(config)#spanning-tree bpdu filtering
console(config)#hostname P10
P10(config)#end
Произведите настройку интерфейсов в соответствующих контекстах конфигурации:
P10#configure terminal
P10(config)#interface loopback 1
P10(config-if)#ip address 10.10.10.10 /32
P10(config-if)#exit
P10(config)#interface HundredGigabitEthernet1/0/1
P10(config-if)#description MPLS-link-RR-PE100,Hu1
P10(config-if)#ip address 10.100.10.2 /30
P10(config-if)#exit
P10(config)#interface HundredGigabitEthernet1/0/2
P10(config-if)#description MPLS-link-RR-PE200,Hu1
P10(config-if)#ip address 10.200.10.2 /30
P10(config-if)#exit
P10(config)#interface TenGigabitEthernet1/0/1
P10(config-if)#description MPLS-link-PE1,Te31
P10(config-if)#ip address 10.10.1.1 /30
P10(config-if)#exit
P10(config)#interface TenGigabitEthernet1/0/2
P10(config-if)#description MPLS-link-PE2,Te31
P10(config-if)#ip address 10.10.2.1 /30
P10(config-if)#end
Произведите настройку OSPF-процесса в соответствующем контексте конфигурации:
В целях минимизации перерыва в передаче трафика при отсутствии функционала LDP IGP Synchronization рекомендуется использовать настройку протокола OSPF max-metric router-lsa on-startup 300. Она позволяет добавить задержку для установки маршрутов в FIB до полной сходимости в OSPF-топологии при перезапуске маршрутизаторов.
P10#configure terminal
P10(config)#router ospf 1
P10(router_ospf_process)#router-id 10.10.10.10
P10(router_ospf_process)#network 10.10.10.10 area 0.0.0.0
P10(router_ospf_process)#network 10.100.10.2 area 0.0.0.0
P10(router_ospf_process)#network 10.200.10.2 area 0.0.0.0
P10(router_ospf_process)#network 10.10.1.1 area 0.0.0.0
P10(router_ospf_process)#network 10.10.2.1 area 0.0.0.0
P10(router_ospf_process)#max-metric router-lsa on-startup 300
P10(router_ospf_process)#end
В протоколе OSPF рекомендуется задействовать режим p2p (point-to-point), который используется при установлении соединений на выделенных линках, где каждый маршрутизатор имеет только одного соседа. При таком типе соединения нет необходимости выбирать Designated Router (DR) или Backup Designated Router (BDR). Этот подход упрощает установление соседств, уменьшая время сходимости протокола.
Также рекомендуется использование BFD для защиты линков от неполадок с односторонней непроходимостью и ускорения времени реакции топологии на отказы.
Настройте дополнительные атрибуты OSPF-соседств и включите BFD на IP-интерфейсах в соответствующих контекстах конфигурации:
P10#configure terminal
P10(config)#interface ip 10.100.10.2
P10(config-ip)#ip ospf network point-to-point
P10(config-ip)#ip ospf bfd
P10(config)#interface ip 10.200.10.2
P10(config-ip)#ip ospf network point-to-point
P10(config-ip)#ip ospf bfd
P10(config)#interface ip 10.10.1.1
P10(config-ip)#ip ospf network point-to-point
P10(config-ip)#ip ospf bfd
P10(config)#interface ip 10.10.2.1
P10(config-ip)#ip ospf network point-to-point
P10(config-ip)#ip ospf bfd
P10(config-ip)#end
Настройте интервалы и множители BFD для IGP-соседств в глобальном контексте конфигурации:
P10#configure terminal
P10(config)#bfd neighbor 10.100.10.1 min-rx 50 interval 50 multiplier 3
P10(config)#bfd neighbor 10.200.10.1 min-rx 50 interval 50 multiplier 3
P10(config)#bfd neighbor 10.10.1.2 min-rx 50 interval 50 multiplier 3
P10(config)#bfd neighbor 10.10.2.2 min-rx 50 interval 50 multiplier 3
P10(config)#end
Если в процессе настройки возникнет ситуация, когда LDP-соседство будет установлено раньше сходимости протокола IGP, то для ускорения построения LSP рекомендуется произвести перезапуск OSPF-процесса:
P10#clear ip ospf 1 process

Reset OSPF process? (Y/N)[N] Y
Настройка P20 выполняется аналогично, с внесением необходимых изменений согласно схеме и плану IP-адресации.
Изменению от устройства к устройству подлежат следующие параметры:
- Hostname устройства;
- Description на интерфейсах;
- IP-адреса интерфейсов (физических + loopback);
- OSPF router-id;
- IP-интерфейсы в OSPF-процессе;
- IP-интерфейсы, для которых изменены атрибуты OSPF-соседств;
- IP-адреса BFD-соседей.
Настройка PE-коммутаторов
Для упрощения процедуры настройки через консоль сначала можно использовать функцию terminal no prompt, отключающую необходимость подтверждения перед выполнением некоторых команд.
Функция terminal no prompt включается в привилегированном EXEC режиме для текущего сеанса управления. Команда действует до момента завершения сеанса:
console#terminal no prompt
Отключите протокол STP и задайте имя устройства в глобальном контексте конфигурации:
console#configure terminal
console(config)#no spanning-tree
console(config)#spanning-tree bpdu filtering
console(config)#hostname PE1
PE1(config)#end
Произведите настройку интерфейсов в соответствующих контекстах конфигурации:
PE1#configure terminal
PE1(config)#interface loopback 1
PE1(config-if)#ip address 1.1.1.1 /32
PE1(config-if)#exit
PE1(config)#interface TenGigabitEthernet1/0/31
PE1(config-if)#description MPLS-link-P10,Te1
PE1(config-if)#ip address 10.10.1.2 /30
PE1(config-if)#exit
PE1(config)#interface TenGigabitEthernet1/0/32
PE1(config-if)#description MPLS-link-P20,Te1
PE1(config-if)#ip address 10.20.1.2 /30
PE1(config-if)#end
В целях минимизации перерыва в передаче трафика при отсутствии функциональности LDP IGP Synchronization рекомендуется использовать настройку протокола OSPF max-metric router-lsa on-startup 300. Она позволяет добавить задержку для установки маршрутов в FIB до полной сходимости в OSPF-топологии при перезапуске маршрутизаторов.
Произведите настройку OSPF-процесса в соответствующем контексте конфигурации:
PE1#configure terminal
PE1(config)#router ospf 1
PE1(router_ospf_process)#router-id 1.1.1.1
PE1(router_ospf_process)#network 1.1.1.1 area 0.0.0.0
PE1(router_ospf_process)#network 10.10.1.2 area 0.0.0.0
PE1(router_ospf_process)#network 10.20.1.2 area 0.0.0.0
PE1(router_ospf_process)#max-metric router-lsa on-startup 300
PE1(router_ospf_process)#end
В протоколе OSPF рекомендуется задействовать режим p2p (point-to-point), который используется при установлении соединений на выделенных линках, где каждый маршрутизатор имеет только одного соседа. При таком типе соединения нет необходимости выбирать Designated Router (DR) или Backup Designated Router (BDR). Этот подход упрощает установление соседств, уменьшая время сходимости протокола.
Также рекомендуется использование BFD для защиты линков от неполадок с односторонней непроходимостью и ускорения времени реакции топологии на отказы.
Настройте дополнительные атрибуты OSPF-соседств и включите BFD на IP-интерфейсах в соответствующих контекстах конфигурации:
PE1#configure terminal
PE1(config)#interface ip 10.10.1.2
PE1(config-ip)#ip ospf network point-to-point
PE1(config-ip)#ip ospf bfd
PE1(config)#interface ip 10.20.1.2
PE1(config-ip)#ip ospf network point-to-point
PE1(config-ip)#ip ospf bfd
PE1(config-ip)#end
Настройте интервалы и множители BFD для IGP-соседств в глобальном контексте конфигурации:
PE1#configure terminal
PE1(config)#bfd neighbor 10.10.1.1 min-rx 50 interval 50 multiplier 3
PE1(config)#bfd neighbor 10.20.1.1 min-rx 50 interval 50 multiplier 3
PE1(config)#end
Если в процессе настройки возникнет ситуация, когда LDP-соседство будет установлено раньше сходимости протокола IGP, то для ускорения построения LSP рекомендуется произвести перезапуск OSPF-процесса:
PE1#clear ip ospf 1 process

Reset OSPF process? (Y/N)[N] Y
Настройка PE2 выполняется аналогично, с внесением необходимых изменений согласно схеме и плану IP-адресации.
Изменению от устройства к устройству подлежат следующие параметры:
- Hostname устройства;
- Description на интерфейсах;
- IP-адреса интерфейсов (физических + loopback);
- OSPF router-id;
- IP-интерфейсы в OSPF-процессе;
- IP-интерфейсы, для которых изменены атрибуты OSPF-соседств;
- IP-адреса BFD-соседей.
Проверка настроек и функционирования IP-Underlay OSPF
После выполнения вышеописанных настроек необходимо выполнить проверку установления соседств протоколов OSPF и BFD, подтвердить наличие IP-связности между loopback-интерфейсами устройств.
Для ускорения процедуры вывода show-команд рекомендуется использовать функцию terminal datadump, отключающую пагинацию при выводе большого объема текста.
Функция terminal datadump включается в привилегированном EXEC-режиме для текущего сеанса управления. Команда действует до момента завершения сеанса:
RR-PE100#terminal datadump
Используемые команды:
show ip interface
show ip ospf neighbor
show ip ospf database
show ip route
show ip bfd neighbors
Пример выполнения вышеуказанных show-команд на устройстве RR-PE100:
Пример выполнения вышеуказанных show-команд на устройстве PE1:
В случае успешного установления всех соседств в схеме должна быть обеспечена IP-связность между всеми устройствами. Проверить это можно, выполнив команду ICMP ping с любого устройства до любого другого, указав в качестве src и dst IP-адреса loopback-интерфейсов устройств.
Пример выполнения ping с RR-PE100 до PE1:
Ожидаемый результат
- Конфигурация IP-интерфейсов верна, административные и оперативные статусы в UP;
- Все соседства протокола OSPF установлены, соседства в статусе full, LSDB заполнена, и топология сошлась;
- Все IP-маршруты обучены, распространены и установлены в FIB;
- IP-связность между всеми устройствами схемы установлена.
Настройка IP-Underlay сети транспортной плоскости с использованием протокола IS-IS
Схема аналогична схеме, приведенной в разделе практической части.
Выполните предварительную настройку на всех устройствах схемы.
Полные конфигурации всех устройств для данного раздела руководства находятся в Приложении 1: Конфигурации устройств IP-Underlay-сети транспортной плоскости с использованием протокола IS-IS
Настройка RR-PE коммутаторов
Для упрощения процедуры настройки через консоль сначала можно использовать функцию terminal no prompt, отключающую необходимость подтверждения перед выполнением некоторых команд.
Функция terminal no prompt включается в привилегированном EXEC-режиме для текущего сеанса управления. Команда действует до момента завершения сеанса:
console#terminal no prompt
Отключите протокол STP и задайте имя устройства:
console#configure terminal console(config)#no spanning-tree console(config)#spanning-tree bpdu filtering console(config)#hostname RR-PE100 RR-PE100(config)#end
В протоколе IS-IS рекомендуется задействовать режим p2p (point-to-point). Он используется при установлении соединений на выделенных линках, где каждый маршрутизатор имеет только одного соседа. Режим point-to-point уменьшает количество служебных пакетов протокола IS-IS, ускоряет установление соседств, уменьшая время сходимости протокола.
Произведите настройку интерфейсов в соответствующих контекстах конфигурации:
RR-PE100#configure terminal RR-PE100(config)#interface loopback 1 RR-PE100(config-if)#ip address 100.100.100.100 /32 RR-PE100(config-if)#ip router isis RR-PE100(config-if)#exit RR-PE100(config)#interface HundredGigabitEthernet1/0/1 RR-PE100(config-if)#description MPLS-link-P10,Hu1 RR-PE100(config-if)#ip address 10.100.10.1 /30 RR-PE100(config-if)#ip router isis RR-PE100(config-if)#isis network point-to-point RR-PE100(config-if)#isis bfd RR-PE100(config-if)#exit RR-PE100(config)#interface HundredGigabitEthernet1/0/2 RR-PE100(config-if)#description MPLS-link-P20,Hu1 RR-PE100(config-if)#ip address 10.100.20.1 /30 RR-PE100(config-if)#ip router isis RR-PE100(config-if)#isis network point-to-point RR-PE100(config-if)#isis bfd RR-PE100(config-if)#exit RR-PE100(config)#interface HundredGigabitEthernet1/0/3 RR-PE100(config-if)#description MPLS-link-RR-PE200,Hu3 RR-PE100(config-if)#ip address 10.100.200.1 /30 RR-PE100(config-if)#ip router isis RR-PE100(config-if)#isis network point-to-point RR-PE100(config-if)#isis bfd RR-PE100(config-if)#end
Произведите настройку IS-IS-процесса в соответствующем контексте конфигурации:
RR-PE100#configure terminal RR-PE100(config)#router isis RR-PE100(router-isis)#is-type level-2-only RR-PE100(router-isis)#net 49.0001.0100.0100.0100.00 RR-PE100(router-isis)#metric-style wide RR-PE100(router-isis)#end
Настройте интервалы и множители BFD для IGP-соседств в глобальном контексте конфигурации:
RR-PE100#configure terminal RR-PE100(config)#bfd neighbor 10.100.10.2 min-rx 50 interval 50 multiplier 3 RR-PE100(config)#bfd neighbor 10.100.20.2 min-rx 50 interval 50 multiplier 3 RR-PE100(config)#bfd neighbor 10.100.200.2 min-rx 50 interval 50 multiplier 3 RR-PE100(config)#end
Если в процессе настройки возникнет ситуация, когда LDP-соседство будет установлено раньше сходимости протокола IGP, то для ускорения построения LSP рекомендуется произвести перезапуск IGP-процесса:
RR-PE100#clear isis This action will reset all neighbor connections and clear IS-IS routing table. Would you like to continue? (Y/N)[N] Y
Настройка RR-PE200 выполняется аналогично, с внесением необходимых изменений согласно схеме и плану IP-адресации.
Изменению от устройства к устройству подлежат следующие параметры:
- Hostname устройства;
- Description на интерфейсах;
- IP-адреса интерфейсов (физических + loopback);
- IS-IS net идентификатор;
- IP-адреса BFD-соседей.
Настройка P-коммутаторов
Для упрощения процедуры настройки через консоль сначала можно использовать функцию terminal no prompt, отключающую необходимость подтверждения перед выполнением некоторых команд.
Функция terminal no prompt включается в привилегированном EXEC-режиме для текущего сеанса управления. Команда действует до момента завершения сеанса:
console#terminal no prompt
Отключите протокол STP и задайте имя устройства:
console#configure terminal console(config)#no spanning-tree console(config)#spanning-tree bpdu filtering console(config)#hostname P10 P10(config)#end
В протоколе IS-IS рекомендуется задействовать режим p2p (point-to-point). Он используется при установлении соединений на выделенных линках, где каждый маршрутизатор имеет только одного соседа. Режим point-to-point уменьшает количество служебных пакетов протокола IS-IS, ускоряет установление соседств, уменьшая время сходимости протокола.
Произведите настройку интерфейсов в соответствующих контекстах конфигурации:
P10#configure terminal P10(config)#interface loopback 1 P10(config-if)#ip address 10.10.10.10 /32 P10(config-if)#ip router isis P10(config-if)#exit P10(config)#interface HundredGigabitEthernet1/0/1 P10(config-if)#description MPLS-link-RR-PE100,Hu1 P10(config-if)#ip address 10.100.10.2 /30 P10(config-if)#ip router isis P10(config-if)#isis network point-to-point P10(config-if)#isis bfd P10(config-if)#exit P10(config)#interface HundredGigabitEthernet1/0/2 P10(config-if)#description MPLS-link-RR-PE200,Hu1 P10(config-if)#ip address 10.200.10.2 /30 P10(config-if)#ip router isis P10(config-if)#isis network point-to-point P10(config-if)#isis bfd P10(config-if)#exit P10(config)#interface TenGigabitEthernet1/0/1 P10(config-if)#description MPLS-link-PE1,Te31 P10(config-if)#ip address 10.10.1.1 /30 P10(config-if)#ip router isis P10(config-if)#isis network point-to-point P10(config-if)#isis bfd P10(config-if)#exit P10(config)#interface TenGigabitEthernet1/0/2 P10(config-if)#description MPLS-link-PE2,Te31 P10(config-if)#ip address 10.10.2.1 /30 P10(config-if)#ip router isis P10(config-if)#isis network point-to-point P10(config-if)#isis bfd P10(config-if)#end
Произведите настройку IS-IS-процесса в соответствующем контексте конфигурации:
P10#configure terminal P10(config)#router isis P10(router-isis)#is-type level-2-only P10(router-isis)#net 49.0001.0010.0010.0010.00 P10(router-isis)#metric-style wide P10(router-isis)#end
Настройте интервалы и множители BFD для IGP-соседств в глобальном контексте конфигурации:
P10#configure terminal P10(config)#bfd neighbor 10.100.10.1 min-rx 50 interval 50 multiplier 3 P10(config)#bfd neighbor 10.200.10.1 min-rx 50 interval 50 multiplier 3 P10(config)#bfd neighbor 10.10.1.2 min-rx 50 interval 50 multiplier 3 P10(config)#bfd neighbor 10.10.2.2 min-rx 50 interval 50 multiplier 3 P10(config)#end
Если в процессе настройки возникнет ситуация, когда LDP-соседство будет установлено раньше сходимости протокола IGP, то для ускорения построения LSP рекомендуется произвести перезапуск IGP-процесса:
P10#clear isis This action will reset all neighbor connections and clear IS-IS routing table. Would you like to continue? (Y/N)[N] Y
Настройка P20 выполняется аналогично, с внесением необходимых изменений согласно схеме и плану IP-адресации.
Изменению от устройства к устройству подлежат следующие параметры:
- Hostname устройства;
- Description на интерфейсах;
- IP-адреса интерфейсов (физических + loopback);
- IS-IS net идентификатор;
- IP-адреса BFD-соседей.
Настройка PE-коммутаторов
Для упрощения процедуры настройки через консоль сначала можно использовать функцию terminal no prompt, отключающую необходимость подтверждения перед выполнением некоторых команд.
Функция terminal no prompt включается в привилегированном EXEC-режиме для текущего сеанса управления. Команда действует до момента завершения сеанса:
console#terminal no prompt
Отключите протокол STP и задайте имя устройства:
console#configure terminal console(config)#no spanning-tree console(config)#spanning-tree bpdu filtering console(config)#hostname PE1 PE1(config)#end
В протоколе IS-IS рекомендуется задействовать режим p2p (point-to-point). Он используется при установлении соединений на выделенных линках, где каждый маршрутизатор имеет только одного соседа. Режим point-to-point уменьшает количество служебных пакетов протокола IS-IS, ускоряет установление соседств, уменьшая время сходимости протокола.
Произведите настройку интерфейсов в соответствующих контекстах конфигурации:
PE1#configure terminal PE1(config)#interface loopback 1 PE1(config-if)#ip address 1.1.1.1 /32 PE1(config-if)#ip router isis PE1(config-if)#exit PE1(config)#interface TenGigabitEthernet1/0/31 PE1(config-if)#description MPLS-link-P10,Te1 PE1(config-if)#ip address 10.10.1.2 /30 PE1(config-if)#ip router isis PE1(config-if)#isis network point-to-point PE1(config-if)#isis bfd PE1(config-if)#exit PE1(config)#interface TenGigabitEthernet1/0/32 PE1(config-if)#description MPLS-link-P20,Te1 PE1(config-if)#ip address 10.20.1.2 /30 PE1(config-if)#ip router isis PE1(config-if)#isis network point-to-point PE1(config-if)#isis bfd PE1(config-if)#end
Произведите настройку IS-IS-процесса в соответствующем контексте конфигурации:
PE1#configure terminal PE1(config)#router isis PE1(router-isis)#is-type level-2-only PE1(router-isis)#net 49.0001.0001.0001.0001.00 PE1(router-isis)#metric-style wide PE1(router-isis)#end
Настройте интервалы и множители BFD для IGP-соседств в глобальном контексте конфигурации:
PE1#configure terminal PE1(config)#bfd neighbor 10.10.1.1 min-rx 50 interval 50 multiplier 3 PE1(config)#bfd neighbor 10.20.1.1 min-rx 50 interval 50 multiplier 3 PE1(config)#end
Если в процессе настройки возникнет ситуация, когда LDP-соседство будет установлено раньше сходимости протокола IGP, то для ускорения построения LSP рекомендуется произвести перезапуск IGP-процесса:
PE1#clear isis This action will reset all neighbor connections and clear IS-IS routing table. Would you like to continue? (Y/N)[N] Y
Настройка PE2 выполняется аналогично, с внесением необходимых изменений согласно схеме и плану IP-адресации.
Изменению от устройства к устройству подлежат следующие параметры:
- Hostname устройства;
- Description на интерфейсах;
- IP-адреса интерфейсов (физических + loopback);
- IS-IS net идентификатор;
- IP-адреса BFD-соседей.
Проверка настроек и функционирования IP-Underlay IS-IS
После выполнения вышеописанных настроек необходимо выполнить проверку установления соседства протоколов IS-IS и BFD, подтвердить наличие IP-связности между loopback-интерфейсами устройств.
Для ускорения процедуры вывода show-команд рекомендуется использовать функцию terminal datadump, отключающую пагинацию при выводе большого объема текста.
Функция terminal datadump включается в привилегированном EXEC режиме для текущего сеанса управления. Команда действует до момента завершения сеанса:
RR-PE100#terminal datadump
Используемые команды:
show ip interface show isis neighbors show isis database show ip route show ip bfd neighbors
Пример выполнения вышеуказанных show-команд на устройстве RR-PE100:
Пример выполнения вышеуказанных show-команд на устройстве PE1:
В случае успешного установления всех соседств в схеме должна быть обеспечена IP-связность между всеми устройствами. Проверить это можно, выполнив команду ICMP ping с любого устройства до любого другого, указав в качестве src и dst IP-адреса loopback-интерфейсов устройств.
Пример выполнения ping с RR-PE100 до PE1:
Ожидаемый результат
- Конфигурация IP-интерфейсов верна, административные и оперативные статусы в UP;
- Все соседства протокола IS-IS установлены, соседства в статусе up, LSDB заполнена, и топология сошлась;
- Все IP-маршруты обучены, распространены и установлены в FIB;
- IP-связность между всеми устройствами схемы установлена.
Настройка MPLS-Underlay сети транспортной плоскости с использованием протокола LDP
Схема аналогична схеме, приведенной в разделе практической части.
Полные конфигурации всех устройств для данного раздела руководства находятся в Приложении 1: Конфигурации устройств MPLS-Underlay сети транспортной плоскости с использованием протокола LDP.
Поддержка протокола LDP предоставляется в составе лицензии MPLS (см. раздел "Установка лицензий").
Настройка RR-PE коммутаторов
Для упрощения процедуры настройки через консоль сначала можно использовать функцию terminal no prompt, отключающую необходимость подтверждения перед выполнением некоторых команд.
Функция terminal no prompt включается в привилегированном EXEC-режиме для текущего сеанса управления. Команда действует до момента завершения сеанса:
RR-PE100#terminal no prompt
Ввиду отсутствия функциональности LDP IGP Synchronization, рекомендуется производить настройку LDP после настройки и полной сходимости IGP-протокола.
Произведите настройку LDP-процесса в соответствующем контексте конфигурации. В контексте AF LDP необходимо настроить редистрибуцию connected-маршрутов и маршрутов IGP-протокола для селекции и установки FEC.
Пример настройки LDP с IGP OSPF:
RR-PE100#configure terminal RR-PE100(config)#mpls ldp RR-PE100(mpls-ldp)#router-id 100.100.100.100 This action will reset all peer connections and interrupt MPLS traffic forwarded by the device. RR-PE100(mpls-ldp)#address-family IPv4 unicast RR-PE100(mpls-ldp-af)#redistribute connected RR-PE100(mpls-ldp-af)#redistribute ospf 1 match internal RR-PE100(mpls-ldp-af)#end
Пример настройки LDP с IGP IS-IS:
RR-PE100#configure terminal RR-PE100(config)#mpls ldp RR-PE100(mpls-ldp)#router-id 100.100.100.100 This action will reset all peer connections and interrupt MPLS traffic forwarded by the device. RR-PE100(mpls-ldp)#address-family IPv4 unicast RR-PE100(mpls-ldp-af)#redistribute connected RR-PE100(mpls-ldp-af)#redistribute isis level-2 RR-PE100(mpls-ldp-af)#end
Включите поддержку MPLS IP туннелирования на MPLS-интерфейсах в соответствующих контекстах конфигурации:
RR-PE100#configure terminal RR-PE100(config)#interface HundredGigabitEthernet1/0/1 RR-PE100(config-if)#mpls ip RR-PE100(config-if)#exit RR-PE100(config)#interface HundredGigabitEthernet1/0/2 RR-PE100(config-if)#mpls ip RR-PE100(config-if)#exit RR-PE100(config)#interface HundredGigabitEthernet1/0/3 RR-PE100(config-if)#mpls ip RR-PE100(config-if)#end
Задайте уникальные для маршрутизатора значения salt и seed:
RR-PE100#configure terminal RR-PE100(config)#port-channel load-balance hash salt 1684300900 RR-PE100(config)#port-channel load-balance hash seed 3133790859 RR-PE100(config)#end
Если в процессе настройки возникнет ситуация, когда LDP-соседство будет установлено раньше сходимости протокола IGP, то для ускорения построения LSP рекомендуется произвести перезапуск IGP-процесса.
Настройка RR-PE200 выполняется аналогично, с внесением необходимых изменений согласно схеме и плану IP-адресации.
Изменению от устройства к устройству подлежат следующие параметры:
- LDP router-id;
- Значения salt и seed.
Настройка P-коммутаторов
Для упрощения процедуры настройки через консоль сначала можно использовать функцию terminal no prompt, отключающую необходимость подтверждения перед выполнением некоторых команд.
Функция terminal no prompt включается в привилегированном EXEC-режиме для текущего сеанса управления. Команда действует до момента завершения сеанса:
P10#terminal no prompt
Ввиду отсутствия функциональности LDP IGP Synchronization, рекомендуется производить настройку LDP после настройки и полной сходимости IGP-протокола.
Произведите настройку LDP-процесса в соответствующем контексте конфигурации. В контексте AF LDP необходимо настроить редистрибуцию connected-маршрутов и маршрутов IGP-протокола для селекции и установки FEC.
Пример настройки LDP с IGP OSPF:
P10#configure terminal P10(config)#mpls ldp P10(mpls-ldp)#router-id 10.10.10.10 This action will reset all peer connections and interrupt MPLS traffic forwarded by the device. P10(mpls-ldp)#address-family IPv4 unicast P10(mpls-ldp-af)#redistribute connected P10(mpls-ldp-af)#redistribute ospf 1 match internal P10(mpls-ldp-af)#end
Пример настройки LDP с IGP IS-IS:
P10#configure terminal P10(config)#mpls ldp P10(mpls-ldp)#router-id 10.10.10.10 This action will reset all peer connections and interrupt MPLS traffic forwarded by the device. P10(mpls-ldp)#address-family IPv4 unicast P10(mpls-ldp-af)#redistribute connected P10(mpls-ldp-af)#redistribute isis level-2 P10(mpls-ldp-af)#end
Включите поддержку MPLS IP туннелирования на MPLS-интерфейсах в соответствующих контекстах конфигурации:
P10#configure terminal P10(config)#interface HundredGigabitEthernet1/0/1 P10(config-if)#mpls ip P10(config-if)#exit P10(config)#interface HundredGigabitEthernet1/0/2 P10(config-if)#mpls ip P10(config-if)#exit P10(config)#interface TenGigabitEthernet1/0/1 P10(config-if)#mpls ip P10(config-if)#exit P10(config)#interface TenGigabitEthernet1/0/2 P10(config-if)#mpls ip P10(config-if)#end
Задайте уникальные для маршрутизатора значения salt и seed:
P10#configure terminal P10(config)#port-channel load-balance hash salt 168430090 P10(config)#port-channel load-balance hash seed 3567760613 P10(config)#end
Если в процессе настройки возникнет ситуация, когда LDP-соседство будет установлено раньше сходимости протокола IGP, то для ускорения построения LSP рекомендуется произвести перезапуск IGP-процесса.
Настройка P20 выполняется аналогично, с внесением необходимых изменений согласно схеме и плану IP-адресации.
Изменению от устройства к устройству подлежат следующие параметры:
- LDP router-id;
- Значения salt и seed.
Настройка PE-коммутаторов
Для упрощения процедуры настройки через консоль сначала можно использовать функцию terminal no prompt, отключающую необходимость подтверждения перед выполнением некоторых команд.
Функция terminal no prompt включается в привилегированном EXEC режиме для текущего сеанса управления. Команда действует до момента завершения сеанса:
PE1#terminal no prompt
Ввиду отсутствия функциональности LDP IGP Synchronization, рекомендуется производить настройку LDP после настройки и полной сходимости IGP-протокола.
Произведите настройку LDP-процесса в соответствующем контексте конфигурации. В контексте AF LDP необходимо настроить редистрибуцию connected-маршрутов и маршрутов IGP-протокола для селекции и установки FEC.
Пример настройки LDP с IGP OSPF:
PE1#configure terminal PE1(config)#mpls ldp PE1(mpls-ldp)#router-id 1.1.1.1 This action will reset all peer connections and interrupt MPLS traffic forwarded by the device. PE1(mpls-ldp)#address-family IPv4 unicast PE1(mpls-ldp-af)#redistribute connected PE1(mpls-ldp-af)#redistribute ospf 1 match internal PE1(mpls-ldp-af)#end
Пример настройки LDP с IGP IS-IS:
PE1#configure terminal PE1(config)#mpls ldp PE1(mpls-ldp)#router-id 1.1.1.1 This action will reset all peer connections and interrupt MPLS traffic forwarded by the device. PE1(mpls-ldp)#address-family IPv4 unicast PE1(mpls-ldp-af)#redistribute connected PE1(mpls-ldp-af)#redistribute isis level-2 PE1(mpls-ldp-af)#end
Включите поддержку MPLS IP туннелирования на MPLS-интерфейсах в соответствующих контекстах конфигурации:
PE1#configure terminal PE1(config)#interface TenGigabitEthernet1/0/31 PE1(config-if)#mpls ip PE1(config-if)#exit PE1(config)#interface TenGigabitEthernet1/0/32 PE1(config-if)#mpls ip PE1(config-if)#end
Задайте уникальные для маршрутизатора значения salt и seed:
PE1#configure terminal PE1(config)#port-channel load-balance hash salt 16843009 PE1(config)#port-channel load-balance hash seed 3752640494 PE1(config)#end
Если в процессе настройки возникнет ситуация, когда LDP-соседство будет установлено раньше сходимости протокола IGP, то для ускорения построения LSP рекомендуется произвести перезапуск IGP-процесса.
Настройка PE2 выполняется аналогично, с внесением необходимых изменений согласно схеме и плану IP-адресации.
Изменению от устройства к устройству подлежат следующие параметры:
- LDP router-id;
- Значения salt и seed.
Проверка настроек и функционирования MPLS-Underlay LDP
После выполнения вышеописанных настроек необходимо выполнить проверку установления LDP-соседств, ассоциации FEC и построения LSP, подтвердить наличие IP-связности между loopback-интерфейсами устройств.
Для ускорения процедуры вывода show-команд рекомендуется использовать функцию terminal datadump, отключающую пагинацию при выводе большого объема текста.
Функция terminal datadump включается в привилегированном EXEC режиме для текущего сеанса управления. Команда действует до момента завершения сеанса:
RR-PE100#terminal datadump
Используемые команды:
show mpls ldp neighbors show mpls ldp bindings show mpls forwarding
Пример выполнения вышеуказанных show-команд на устройстве RR-PE100:
Пример выполнения вышеуказанных show-команд на устройстве PE1:
В случае успешного установления всех соседств в схеме должна быть обеспечена IP/MPLS-связность между всеми устройствами. Проверить это можно, выполнив команду ICMP ping с любого устройства до любого другого, указав в качестве src и dst IP-адреса loopback-интерфейсов устройств.
Пример выполнения ping с RR-PE100 до PE1:
RR-PE100#ping 1.1.1.1 source 100.100.100.100
Pinging 1.1.1.1 with 18 bytes of data:

18 bytes from 1.1.1.1: icmp_seq=1. time=0 ms
18 bytes from 1.1.1.1: icmp_seq=2. time=0 ms
18 bytes from 1.1.1.1: icmp_seq=3. time=0 ms
18 bytes from 1.1.1.1: icmp_seq=4. time=0 ms

----1.1.1.1 PING Statistics----
4 packets transmitted, 4 packets received, 0% packet loss
round-trip (ms) min/avg/max = 0/0/0
Подробная информация по работе LDP в транспортной плоскости представлена в теоретической части руководства: Построение LSP с помощью LDP и Базовые принципы работы транспортной плоскости.
Подробная информация о процессе передачи MPLS-пакетов на транспортной плоскости представлена в теоретической части руководства: Базовый процесс коммутации пакетов по меткам в MPLS-домене.
Ожидаемый результат
- Конфигурация MPLS-интерфейсов верна;
- Все соседства протокола LDP установлены, соседства в статусе operational, LIB заполнена, и топология сошлась;
- Все /32 IP-маршруты инсталлированы как FEC, данные о MPLS-метках и FEC распространены, и LSP установлены в LFIB;
- IP/MPLS-связность между всеми устройствами схемы установлена.
Настройка MPLS-Overlay сети сервисной плоскости с использованием протокола MP-BGP
Схема и адресный план аналогичны данным, приведенным в разделе "Схема практической части".
Полные конфигурации всех устройств для данного раздела руководства находятся в Приложении 1: Конфигурации устройств MPLS-Overlay сети сервисной плоскости с использованием протокола MP-BGP.
Подробная информация по работе сервисной плоскости представлена в теоретической части руководства: Базовые принципы работы сервисной плоскости.
Поддержка протокола BGP предоставляется по лицензии.
Функциональность MP-BGP AF VPNv4 Unicast доступен только при наличии лицензий на функциональность BGP и MPLS (см. Установка лицензий).
Настройка RR-PE коммутаторов
Для упрощения процедуры настройки через консоль сначала можно использовать функцию terminal no prompt, отключающую необходимость подтверждения перед выполнением некоторых команд.
Функция terminal no prompt включается в привилегированном EXEC-режиме для текущего сеанса управления. Команда действует до момента завершения сеанса:
RR-PE100#terminal no prompt
Произведите настройку BGP-процесса в соответствующем контексте конфигурации:
RR-PE100#configure terminal
RR-PE100(config)#router bgp 65500
RR-PE100(router-bgp)#bgp router-id 100.100.100.100
This action will reset all neighbor connections and clear BGP routing table.
RR-PE100(router-bgp)#bgp cluster-id 100.100.100.100
This action will reset all neighbor connections and clear BGP routing table.
RR-PE100(router-bgp)#address-family IPv4 unicast
RR-PE100(router-bgp-af)#exit
RR-PE100(router-bgp)#address-family vpnv4 unicast
This action will reset all neighbor connections and clear BGP routing table.
RR-PE100(router-bgp-af)#exit
RR-PE100(router-bgp)#peer-group PE_GROUP
RR-PE100(router-bgp-nbrgrp)#remote-as 65500
This action will reset connection with all neighbors in peer group.
RR-PE100(router-bgp-nbrgrp)#update-source loopback 1
This action will reset connection with all neighbors in peer group.
RR-PE100(router-bgp-nbrgrp)#fall-over bfd
RR-PE100(router-bgp-nbrgrp)#route-reflector-client
RR-PE100(router-bgp-nbrgrp)#exit
RR-PE100(router-bgp)#peer-group RR_GROUP
RR-PE100(router-bgp-nbrgrp)#remote-as 65500
This action will reset connection with all neighbors in peer group.
RR-PE100(router-bgp-nbrgrp)#update-source loopback 1
This action will reset connection with all neighbors in peer group.
RR-PE100(router-bgp-nbrgrp)#fall-over bfd
RR-PE100(router-bgp-nbrgrp)#exit
RR-PE100(router-bgp)#neighbor 1.1.1.1
RR-PE100(router-bgp-nbr)#peer-group PE_GROUP
RR-PE100(router-bgp-nbr)#address-family IPv4 unicast
RR-PE100(router-bgp-nbr-af)#exit
RR-PE100(router-bgp-nbr)#address-family vpnv4 unicast
This action will reset connection with the neighbor.
RR-PE100(router-bgp-nbr-af)#exit
RR-PE100(router-bgp-nbr)#exit
RR-PE100(router-bgp)#neighbor 2.2.2.2
RR-PE100(router-bgp-nbr)#peer-group PE_GROUP
RR-PE100(router-bgp-nbr)#address-family IPv4 unicast
RR-PE100(router-bgp-nbr-af)#exit
RR-PE100(router-bgp-nbr)#address-family vpnv4 unicast
This action will reset connection with the neighbor.
RR-PE100(router-bgp-nbr-af)#exit
RR-PE100(router-bgp-nbr)#exit
RR-PE100(router-bgp)#neighbor 200.200.200.200
RR-PE100(router-bgp-nbr)#peer-group RR_GROUP
RR-PE100(router-bgp-nbr)#address-family IPv4 unicast
RR-PE100(router-bgp-nbr-af)#exit
RR-PE100(router-bgp-nbr)#address-family vpnv4 unicast
This action will reset connection with the neighbor.
RR-PE100(router-bgp-nbr-af)#end
Настройте интервалы и множители BFD для BGP-соседств в глобальном контексте конфигурации:
RR-PE100#configure terminal
RR-PE100(config)#bfd neighbor 1.1.1.1 min-rx 50 interval 50 multiplier 3
RR-PE100(config)#bfd neighbor 2.2.2.2 min-rx 50 interval 50 multiplier 3
RR-PE100(config)#bfd neighbor 200.200.200.200 min-rx 50 interval 50 multiplier 3
RR-PE100(config)#end
Если в процессе настройки возникнет ситуация, когда BGP-соседство будет установлено раньше, чем будет включен route-reflector, то для применения настройки route-reflector-client необходим перезапуск процесса BGP:
RR-PE100#clear ip bgp
This action will reset connection with the neighbor.
Would you like to continue? (Y/N)[N] Y
Настройка RR-PE200 выполняется аналогично, с внесением необходимых изменений согласно схеме и плану IP-адресации.
Изменению от устройства к устройству подлежат следующие параметры:
- BGP router-id;
- IP-адреса BGP-соседей.
Настройка PE-коммутаторов
Для упрощения процедуры настройки через консоль сначала можно использовать функцию terminal no prompt, отключающую необходимость подтверждения перед выполнением некоторых команд.
Функция terminal no prompt включается в привилегированном EXEC-режиме для текущего сеанса управления. Команда действует до момента завершения сеанса:
PE1#terminal no prompt
Произведите настройку BGP-процесса в соответствующем контексте конфигурации:
PE1#configure terminal
PE1(config)#router bgp 65500
PE1(router-bgp)#bgp router-id 1.1.1.1
This action will reset all neighbor connections and clear BGP routing table.
PE1(router-bgp)#address-family IPv4 unicast
PE1(router-bgp-af)#exit
PE1(router-bgp)#address-family vpnv4 unicast
This action will reset all neighbor connections and clear BGP routing table.
PE1(router-bgp-af)#exit
PE1(router-bgp)#peer-group RR_GROUP
PE1(router-bgp-nbrgrp)#remote-as 65500
This action will reset connection with all neighbors in peer group.
PE1(router-bgp-nbrgrp)#update-source loopback 1
This action will reset connection with all neighbors in peer group.
PE1(router-bgp-nbrgrp)#fall-over bfd
PE1(router-bgp-nbrgrp)#exit
PE1(router-bgp)#neighbor 100.100.100.100
PE1(router-bgp-nbr)#peer-group RR_GROUP
PE1(router-bgp-nbr)#address-family IPv4 unicast
PE1(router-bgp-nbr-af)#exit
PE1(router-bgp-nbr)#address-family vpnv4 unicast
This action will reset connection with the neighbor.
PE1(router-bgp-nbr-af)#exit
PE1(router-bgp-nbr)#exit
PE1(router-bgp)#neighbor 200.200.200.200
PE1(router-bgp-nbr)#peer-group RR_GROUP
PE1(router-bgp-nbr)#address-family IPv4 unicast
PE1(router-bgp-nbr-af)#exit
PE1(router-bgp-nbr)#address-family vpnv4 unicast
PE1(router-bgp-nbr)#end
Настройте интервалы и множители BFD для BGP-соседств в глобальном контексте конфигурации:
PE1#configure terminal
PE1(config)#bfd neighbor 100.100.100.100 min-rx 50 interval 50 multiplier 3
PE1(config)#bfd neighbor 200.200.200.200 min-rx 50 interval 50 multiplier 3
PE1(config)#end
Настройка PE2 выполняется аналогично, с внесением необходимых изменений согласно схеме и плану IP-адресации.
Изменению от устройства к устройству подлежат следующие параметры:
- BGP router-id;
- IP-адреса BGP-соседей.
Проверка настроек и функционирования MPLS-Overlay MP-BGP
После выполнения вышеописанных настроек необходимо выполнить проверку установления соседств протоколов BGP и BFD.
Для ускорения процедуры вывода show-команд рекомендуется использовать функцию terminal datadump, отключающую пагинацию при выводе большого объема текста.
Функция terminal datadump включается в привилегированном EXEC-режиме для текущего сеанса управления. Команда действует до момента завершения сеанса:
RR-PE100#terminal datadump
Используемые команды:
show ip bgp all all neighbors
show ip bfd neighbors
Пример выполнения вышеуказанных show-команд на устройстве RR-PE100:
Пример выполнения вышеуказанных show-команд на устройстве PE1:
Ожидаемый результат
- Соседства протокола BGP в состоянии ESTABLISHED для всех Address Family, MP-BGP готов к работе;
- Соседства протокола BFD на loopback-интерфейсах в состоянии Up, BGP-сессии защищены.
Настройка MPLS L3 VPN-сервисов
L3 VPN с полносвязной топологией
Схема и адресный план Underlay-сети аналогичны используемым в разделе "Схема практической части".
Перед настройкой L3 VPN-сервисов выполните предварительную настройку устройств и настройку Underlay- и Overlay-сетей согласно предыдущим разделам данного руководства.
Полные конфигурации всех устройств для данного раздела руководства находятся в Приложении 1: Конфигурации устройств для L3 VPN с полносвязной топологией.
Управление топологией L3 VPN-сервиса производится с помощью Route-Target, подробная информация представлена в теоретической части руководства: Управление топологией VPN с помощью Route Target.
Полносвязный L3 VPN-сервис подразумевает наличие равноценного обмена маршрутами между всеми VPN-сайтами IP/MPLS-сети. При такой топологии сервиса все VPN-сайты считаются одноранговыми. Далее представлена диаграмма обмена маршрутной информацией в L3 VPN-сервисе и его адресный план.
Диаграмма обмена маршрутной информацией в полносвязном L3 VPN-сервисе:
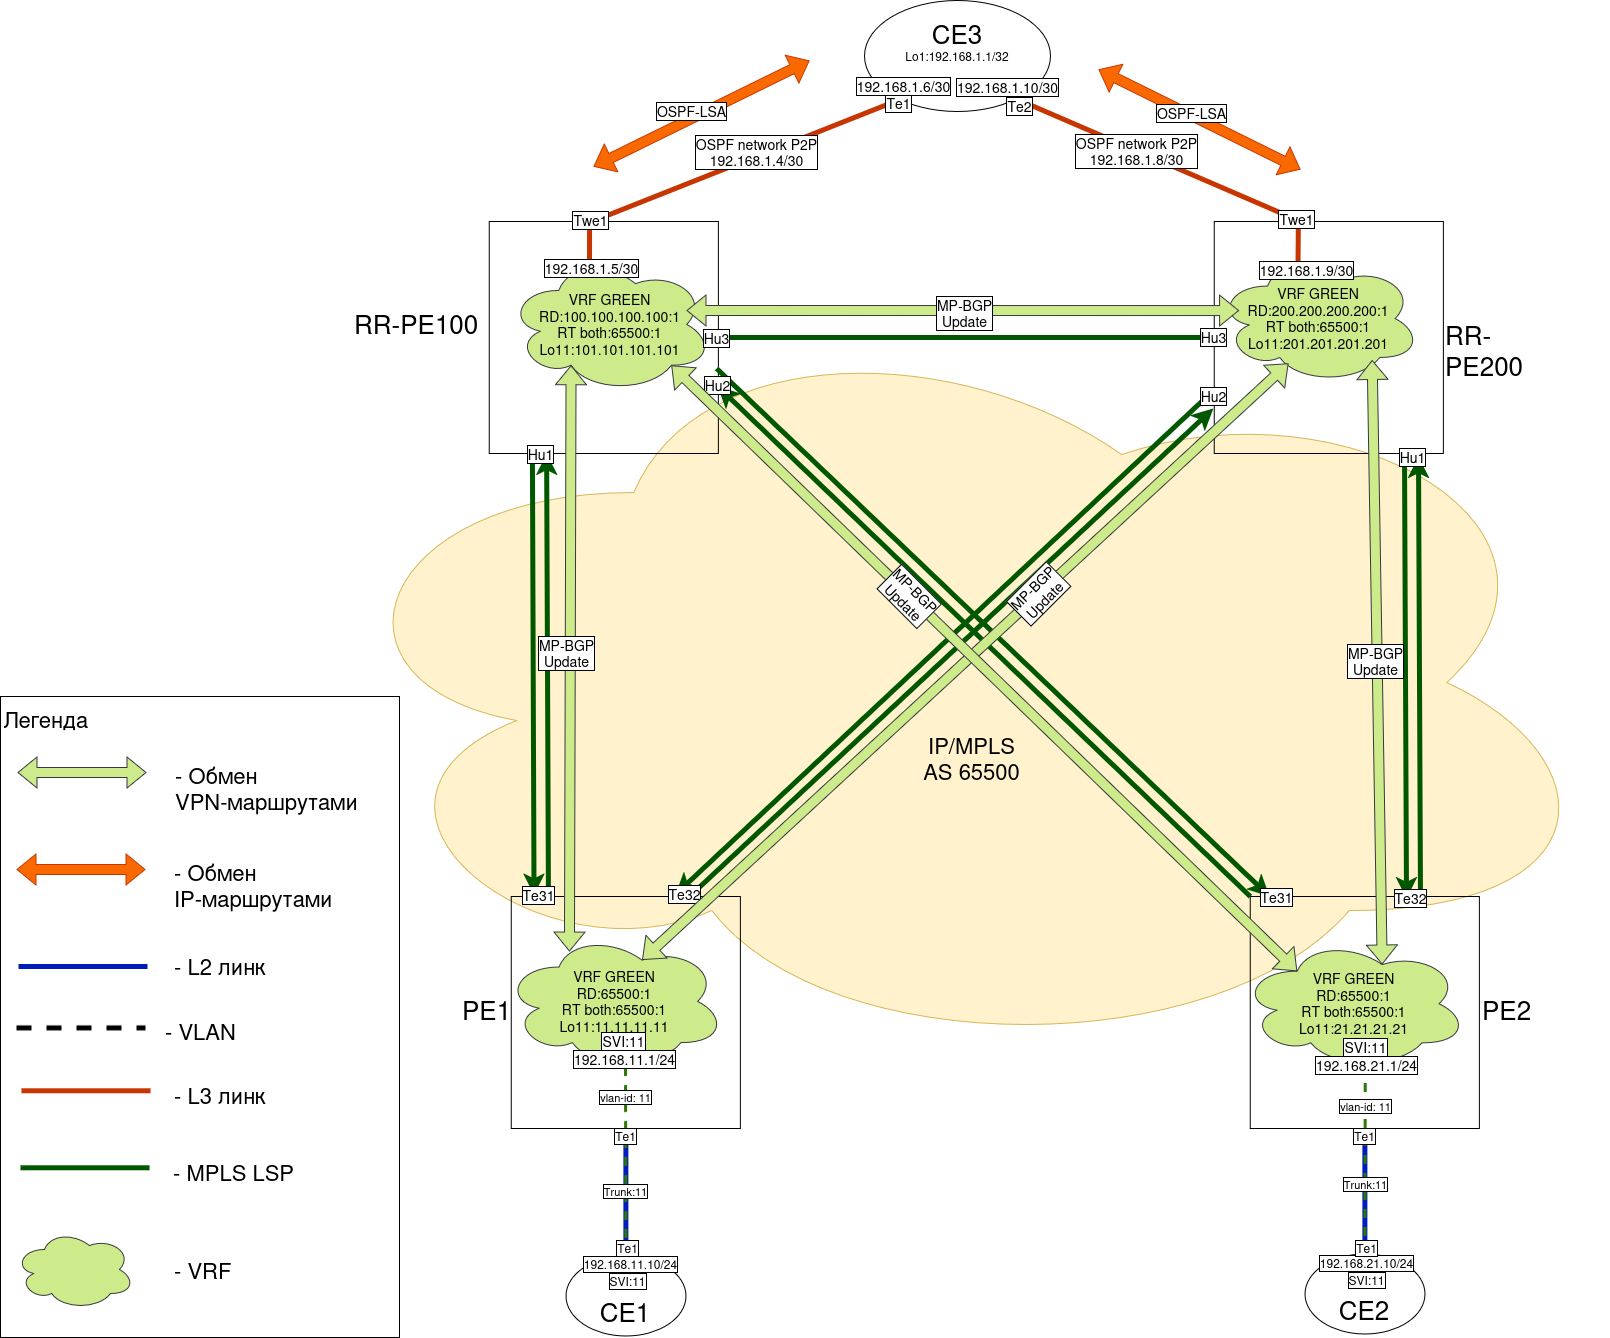
Подробная информация о выборе значения и типа RD представлена в теоретической части руководства: Формат и особенности VPNv4-маршрутов.
IP-адресация, интерфейсы и атрибуты маршрутов используются для примера, значения выбраны исходя из принципа наглядности и не являются рекомендацией для планирования.
Адресный план и распределение VLAN и интерфейсов:
| Хост | VRF name | RD | RT | Интерфейс | VLAN | IP-интерфейс |
|---|---|---|---|---|---|---|
| RR-PE100 | GREEN | 100.100.100.100:1 | import 65500:1 | Loopback 11 | - | 101.101.101.101/32 |
| export 65500:1 | Twe1/0/1 | - | 192.168.1.5/30 | |||
| RR-PE200 | GREEN | 200.200.200.200:1 | import 65500:1 | Loopback 11 | - | 201.201.201.201/32 |
| export 65500:1 | Twe1/0/1 | - | 192.168.1.9/30 | |||
| PE1 | GREEN | 65500:1 | import 65500:1 | Loopback 11 | - | 11.11.11.11/32 |
| export 65500:1 | Te1/0/1 | 11 | 192.168.11.1/24 | |||
| PE2 | GREEN | 65500:1 | import 65500:1 | Loopback 11 | - | 21.21.21.21/32 |
| export 65500:1 | Te1/0/1 | 11 | 192.168.21.1/24 |
Подробная информация о сервисной модели, рекомендации и базовый пример модели доставки услуг представлены в соответствующих разделах руководства:
- Сервисная модель;
- Общие рекомендации по планированию;
- Пример сервисной модели сети на коммутаторах Eltex MES с использованием стека технологий MPLS L3 VPN.
Настройка сервиса полносвязного L3 VPN с dual-homing-подключением CE в режиме active-active с помощью OSPF на RR-PE коммутаторах
При одноранговой настройке L3-линков и включенной поддержке ECMP dual-homing-схема будет функционировать в режиме Active-Active.
Необходимо создать на устройстве RR-PE100 VRF с именем GREEN — ip vrf GREEN. Сконфигурируйте в контексте VRF RD и Route-Target.
При подключении CE3 по схеме dual-homing рекомендуется использовать RD типа 1 - rd 100.100.100.100:1.
Топология сервиса полносвязная, поэтому рекомендуется одинаковое значение RT типа 0 для импорта и экспорта — route-target both 65500:1.
Во избежание зацикливания трафика через CE рекомендуется увеличить административную дистанцию OSPF Inter-AS относительно BGP Intra-AS в VRF на PE.
Подробная информация о выборе значения и типа RD представлена в теоретической части руководства: Route Distinguisher и Применение RD для резервирования маршрутов.
Подробная информация о выборе значения и типа RT представлена в теоретической части руководства: Route Target и Управление топологией VPN с помощью Route Target.
Произведите настройку VRF в соответствующем контексте конфигурации:
RR-PE100#configure terminal
RR-PE100(config)#ip vrf GREEN
RR-PE100(config-vrf)#rd 100.100.100.100:1
RR-PE100(config-vrf)#route-target both 65500:1
RR-PE100(config-vrf)#distance ospf inter-as 250
RR-PE100(config-vrf)#end
Настройте и ассоциируйте с VRF интерфейсы в соответствующих контекстах конфигурации:
RR-PE100#configure terminal
RR-PE100(config)#interface loopback 11
RR-PE100(config-if)#ip vrf GREEN
RR-PE100(config-if)#ip address 101.101.101.101 /32
RR-PE100(config-if)#exit
RR-PE100(config)#interface TwentyFiveGigaEthernet1/0/1
RR-PE100(config-if)#description L3-link-CE3,Te1
RR-PE100(config-if)#ip vrf GREEN
RR-PE100(config-if)#ip address 192.168.1.5 /30
RR-PE100(config-if)#end
Произведите настройку OSPF-процесса и правил редистрибуции маршрутов для VRF GREEN в соответствующем контексте конфигурации:
RR-PE100#configure terminal
RR-PE100(config)#router ospf 101 vrf GREEN
RR-PE100(router_ospf_process)#router-id 101.101.101.101
RR-PE100(router_ospf_process)#network 192.168.1.5 area 0.0.0.0
RR-PE100(router_ospf_process)#redistribute connected subnets
RR-PE100(router_ospf_process)#redistribute bgp metric 100 subnets
RR-PE100(router_ospf_process)#end
Для симметрии исходящего трафика от CE в dual-homing-схеме с active-active-режимом работы рекомендуется добавление метрики к редистрибутируемым из MP-BGP в сервисный OSPF-процесс маршрутам на RR-PE для повышения предпочтительности internal-OSPF маршрутов на CE.
Настройте тип сети для OSPF-соседства и включите BFD на IP интерфейсе VRF GREEN в соответствующем контексте конфигурации:
RR-PE100#configure terminal
RR-PE100(config)#interface ip 192.168.1.5 vrf GREEN
RR-PE100(config-ip)#ip ospf network point-to-point
RR-PE100(config-ip)#ip ospf bfd
RR-PE100(config-ip)#end
Настройте интервалы и множители BFD для интерфейса OSPF-соседства VRF GREEN в глобальном контексте конфигурации:
RR-PE100#configure terminal
RR-PE100(config)#bfd neighbor 192.168.1.6 min-rx 50 interval 50 multiplier 3 vrf GREEN
RR-PE100(config)#end
Создайте VRF-инстанс в контексте конфигурации BGP-процесса и настройте редистрибуцию необходимых протоколов в BGP AF IPv4 Unicast для последующего экспорта в MP-BGP:
RR-PE100#configure terminal
RR-PE100(config)#router bgp 65500
RR-PE100(router-bgp)#vrf GREEN
RR-PE100(router-bgp-vrf)#address-family IPv4 unicast
RR-PE100(router-bgp-af-vrf)#redistribute connected
RR-PE100(router-bgp-af-vrf)#redistribute ospf 101 match internal
RR-PE100(router-bgp-af-vrf)#end
Настройка RR-PE200 выполняется аналогично, с внесением необходимых изменений согласно схеме и плану IP-адресации.
Изменению от устройства к устройству подлежат следующие параметры:
- Значения RD в контексте VRF;
- Description на интерфейсах;
- IP-адреса интерфейсов (физических + loopback);
- OSPF router-id;
- IP-интерфейсы в OSPF-процессе;
- IP-интерфейсы, для которых изменены атрибуты OSPF-соседств;
- IP-адреса BFD-соседей.
Настройка сервиса полносвязного L3 VPN с L2 single-homing-подключением CE на PE коммутаторах
Необходимо создать на устройстве PE1 VRF с именем GREEN — ip vrf GREEN. Сконфигурируйте в контексте VRF RD и Route-Target.
Подключение CE планируется по схеме single-homing, достаточно использовать RD типа 0 — rd 65500:1.
Топология сервиса полносвязная, поэтому рекомендуется одинаковое значение RT типа 0 для импорта и экспорта — route-target both 65500:1.
Подробная информация о выборе значения и типа RD представлена в теоретической части руководства: Route Distinguisher.
Подробная информация о выборе значения и типа RT представлена в теоретической части руководства: Route Target и Управление топологией VPN с помощью Route Target.
Произведите настройку VRF в соответствующем контексте конфигурации:
PE1#configure terminal
PE1(config)#ip vrf GREEN
PE1(config-vrf)#rd 65500:1
PE1(config-vrf)#route-target both 65500:1
PE1(config-vrf)#end
Настройте и ассоциируйте с VRF интерфейсы, настройте интерфейс L2-стыка с CE в соответствующих контекстах конфигурации:
PE1#configure terminal
PE1(config)#interface loopback 11
PE1(config-if)#ip vrf GREEN
PE1(config-if)#ip address 11.11.11.11 /32
PE1(config-if)#exit
PE1(config)#interface vlan 11
PE1(config-if)#name L3VPN-GREEN
PE1(config-if)#ip vrf GREEN
PE1(config-if)#ip address 192.168.11.1 /24
PE1(config-if)#exit
PE1(config)#interface TenGigabitEthernet1/0/1
PE1(config-if)#description L2-link-CE1,Te1
PE1(config-if)#switchport mode trunk
PE1(config-if)#switchport trunk allowed vlan add 11
PE1(config-if)#switchport forbidden default-vlan
PE1(config-if)#end
Создайте VRF-инстанс в контексте конфигурации BGP-процесса и настройте редистрибуцию необходимых протоколов в BGP AF IPv4 Unicast для последующего экспорта в MP-BGP:
PE1#configure terminal
PE1(config)#router bgp 65500
PE1(router-bgp)#vrf GREEN
PE1(router-bgp-vrf)#address-family IPv4 unicast
PE1(router-bgp-af-vrf)#redistribute connected
PE1(router-bgp-af-vrf)#end
Настройка PE2 выполняется аналогично, с внесением необходимых изменений согласно схеме и плану IP-адресации.
Изменению от устройства к устройству подлежат следующие параметры:
- Description и name на интерфейсах;
- IP-адреса интерфейсов (физических + loopback);
Проверка настройки VRF и обмена маршрутной информацией в L3 VPN на PE-коммутаторах
После выполнения вышеописанных настроек необходимо выполнить проверку конфигурирования VRF, ассоциации интерфейсов, обмена маршрутной информацией в VPN, подтвердить наличие IP-связности между Loopback-интерфейсами устройств в VRF.
Для ускорения процедуры вывода show-команд рекомендуется использовать функцию terminal datadump, отключающую пагинацию при выводе большого объема текста.
Функция terminal datadump включается в привилегированном EXEC-режиме для текущего сеанса управления. Команда действует до момента завершения сеанса:
RR-PE100#terminal datadump
Используемые команды:
show ip vrf <NAME>
show ip interface vrf <NAME>
show ip bgp vpnv4 unicast
show ip route vrf <NAME>
show ip route bgp vrf <NAME>
Пример выполнения вышеуказанных show-команд на устройстве RR-PE100:
Пример выполнения вышеуказанных show-команд на устройстве PE1:
В текущей версии ПО не поддержана фильтрация BGP-маршрутов VPNv4 Unicast, возможен только полный вывод таблицы.
Ниже детально рассматривается вывод команды show ip bgp vpnv4 unicast для VPN-маршрута 11.11.11.11/32 на RR-PE100:
RR-PE100#show ip bgp vpnv4 unicast

BGP routing table information for VRF default
BGP table version is 52, local router ID is 100.100.100.100
Status codes: * - valid, > - best, i - internal, s - suppressed, m - ECMP
Origin codes: i - IGP, e - EGP, ? - incomplete
Path type: a - aggregate

   Network            Nexthop         Metric     LocPrf     Weight     Path

Route distinguisher: 65500:1
  MPLS Labels in/out --/21
*>i11.11.11.11/32
                      1.1.1.1         0          100        0          ?
* i11.11.11.11/32
                      1.1.1.1         0          100        0          ?
Где:
Route distinguisher:— значение RD для VPN-маршрута, полученного от Egress-PE для 11.11.11.11/32 (PE1);MPLS Labels in/out— значение сервисной MPLS-метки, выделенной MP-BGP на Egress-PE для 11.11.11.11/32;11.11.11.11/32— префикс и его длина;1.1.1.1— nexthop для VPN-маршрута в транспортной плоскости (LSP).
Эта запись говорит о наличии двух VPN-маршрутов — от PE и от RR, для адреса назначения 11.11.11.11/32. На Egress-PE в VRF, в которую установлен маршрут, назначен RD типа 0 — 65500:1. Посредством MP-BGP на Egress-PE выделена и назначена сервисная MPLS-метка 21 для VPN-маршрутов VRF с RD 65500:1. Значение nexthop говорит о том, что данный маршрут доступен на транспортной плоскости за LSP к FEC 1.1.1.1/32.
Ниже детально рассматривается вывод команд show ip route address <VPN-route> vrf GREEN и show mpls forwarding <VPN nexthop> на RR-PE100:
RR-PE100#show ip route address 11.11.11.11 /32 vrf GREEN
Maximum Parallel Paths: 2 (2 after reset)
Load balancing: src-dst-mac-ip-port
Load balancing hash Salt value: 1684300900
Load balancing hash Seed value: 3133790859
IP Forwarding: enabled
Codes: > - best, C - connected, S - static,
       R - RIP,
       O - OSPF intra-area, OIA - OSPF inter-area,
       OE1 - OSPF external 1, OE2 - OSPF external 2,
       B - BGP, i - IS-IS, L1 - IS-IS level-1,
       P - PBR
       L2 - IS-IS level-2, ia - IS-IS inter area
[d/m]: d - route's distance, m - route's metric

B    11.11.11.11/32 [200/0] via 1.1.1.1, 00:58:35

RR-PE100#show mpls forwarding 1.1.1.1

Prefix           Local Label  Remote Label  Outgoing Interface  Next Hop
---------------  -----------  ------------  ------------------  ---------------
1.1.1.1          27           25            hu1/0/2             10.100.20.2
1.1.1.1          27           31            hu1/0/1             10.100.10.2
Из вывода данных команд следует: 11.11.11.11/32 из VRF GREEN доступен за Egress-PE1 с LSP к FEC 1.1.1.1, для достижения которого возможно использовать два LSP с транспортными исходящими MPLS-метками 31 и 25 за соответствующими интерфейсами и nexthop IP-Underlay сети, балансирование трафика будет выполняться по алгоритму src-dst-mac-ip-port (5-Tuple), заданы уникальные salt и seed для противодействия поляризации трафика при балансировке.
В случае корректной конфигурации VRF и успешного обмена маршрутной информацией в L3 VPN в схеме должна быть IP-связность между всеми устройствами. Проверить это можно, выполнив команду ICMP ping между любыми устройствами, указав в качестве src и dst IP-адреса Loopback-интерфейсов устройств в VRF.
Пример выполнения ping с RR-PE100 до PE1:
Подробная информация по обмену VPN-маршрутами представлена в теоретической части руководства: Обмен маршрутной информацией в BGP/MPLS L3 VPN.
Ожидаемый результат
- VRF сконфигурирован корректно;
- Успешно произведен обмен маршрутной информацией в L3 VPN;
- VPN-маршруты успешно установлены в VRF.
Проверка работоспособности L3 VPN на CE
Примеры конфигураций коммутаторов Eltex MES в роли CE находятся в Приложении 1: Пример настройки CE-устройств.
В качестве проверки работоспособности созданного L3 VPN можно использовать проверку корректности OSPF-маршрутов на CE3 и наличие IP-связности между CE1, CE2 и CE3. При наличии изученных маршрутов в таблице маршрутизации CE3, проконтролируйте успешность выполнения команды ping между всеми CE-устройствами.
Пример проверки таблицы маршрутизации на CE3:
Наличие нескольких ECMP-путей у активных IP-маршрутов в VPN подтверждает, что dual-homing-схема работает в режиме active-active.
Пример выполнения ping с CE3 до CE1 и CE2:
Аналогичный пример выполнения ping с CE1 и CE2:
В качестве дополнительной меры контроля возможно использовать функциональность зеркалирования входящего трафика с любого интерфейса устройств схемы.
Зеркалирование трафика можно использовать как инструмент контроля на любом устройстве схемы и на любом этапе, но корректное заполнение заголовков в случае инкапсулированного в MPLS трафика возможно получить только на входящих кадрах, так как на локальном устройстве исходящий трафик реплицируется процессом зеркалирования до завершения инкапсуляции.
Подробная информация по передаче VPN-трафика представлена в теоретической части руководства: Передача L3 VPN трафика и процесс коммутации пакетов по меткам.
Ожидаемый результат
- L3 VPN успешно функционирует;
- CE3 при dual-homing получил по OSPF и установил все необходимые маршруты для обмена с VPN-хостами в режиме active-active;
- Есть возможность передачи пользовательского трафика между CE.
Приложение 1
В приложении содержатся полные конфигурации всех устройств схемы, используемые в разделах руководства.
Предварительная настройка
Для всех устройств схемы
Конфигурации устройств IP-Underlay сети транспортной плоскости с использованием протокола OSPF
RR-PE100
RR-PE200
P10
P20
PE1
PE2
Конфигурации устройств IP-Underlay сети транспортной плоскости с использованием протокола IS-IS
RR-PE100
RR-PE200
P10
P20
PE1
PE2
Конфигурации устройств MPLS-Underlay сети транспортной плоскости с использованием протокола LDP
Конфигурация приведена сразу для OSPF и IS-IS протоколов в IP-Underlay сети.
В контексте LDP AF приведены команды сразу для IS-IS и OSPF, необходимо выбрать используемый протокол для редистрибуции IP-маршрутов в LDP в зависимости от выбранного IGP-протокола в IP-Underlay сети.
RR-PE100
RR-PE200
P10
P20
PE1
PE2
Конфигурации устройств MPLS-Overlay сети сервисной плоскости с использованием протокола MP-BGP
RR-PE100
RR-PE200
PE1
PE2
Конфигурации устройств для L3 VPN с полносвязной топологией
RR-PE100 с L3 dual-homing-подключением CE3 с помощью OSPF
RR-PE200 с L3 dual-homing-подключением CE3 с помощью OSPF
PE1 с L2 single-homing-подключением CE
PE2 с L2 single-homing-подключением CE
Пример настройки CE-устройств
В роли CE-устройств могут выступать любые L2- и L3-устройства — коммутаторы, маршрутизаторы, рабочие станции.
В качестве примера конфигурации CE будет приведена конфигурация, релевантная для коммутаторов серий 2300-XX/3300-XX и коммутаторов с поддержкой MPLS из раздела: Возможные продуктовые решения Eltex на базе коммутаторов с поддержкой MPLS L3 VPN.
Настройка сервиса полносвязного L3 VPN с L3 dual-homing-подключением CE с помощью OSPF на RR-PE коммутаторах
Конфигурация CE3:
Настройка сервиса полносвязного L3 VPN с L2 single-homing-подключением CE на PE-коммутаторах
Конфигурация CE1:
Конфигурация CE2:
Список изменений
| Версия документа | Дата выпуска | Содержание изменений |
|---|---|---|
| Версия 1.1 | 29.09.2026 | Первая публикация |